


如果你正在評估用於客服、銷售或內部工具的對話式 AI,可能已注意到供應商會依據所販售的產品,以截然不同的意思使用「chatbot」和「AI agent」。有些標示為 AI agent 的產品,只是在語言模型外加上一層介面,沒有工具存取能力。有些稱為 chatbot 的產品,反而比自稱 agent 的系統進行更多自主推理。
Chatbot 是對話介面;AI agent 則是控制背後工作的一種方式。腳本式 chatbot 可以呼叫 API 並保留狀態。Agent 可以從允許的工具中選擇下一步,但這不會驗證使用者身分、授權寫入,也不能證明任務已成功。本文比較三種實作架構,並透過一個假設的退貨請求具體說明這些界線。
術語說明
業界尚未形成一致的定義,因此本文採用三種工作分類,不把產品名稱當成規格:
-
規則式 chatbot: 透過意圖分類、實體擷取和腳本式對話流程選擇下一步。回覆使用範本,而非 LLM。工作流程可以保留狀態、呼叫 API,並強制執行核准程序。
-
僅回答問題的 LLM chatbot: 語言模型根據提供的上下文回答,內容通常取自知識庫。在本文的例子中,它沒有動作工具。其他稱為 chatbot 或 copilot 的產品,可能具有工具、多次模型呼叫和人工核准功能。
-
AI agent: LLM 在已設定的迴圈中選擇步驟和工具,根據觀察結果決定接下來做什麼。記憶、權限、停止條件和人工審查取決於實作。自主性受系統實際提供的工具和授權範圍限制。
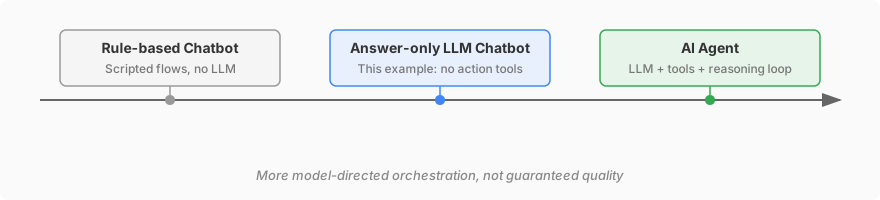 這些是架構示意。更多由模型主導的協調,不保證準確度更高、成本更低,或業務結果已完成。
一項實用的架構區別,是由誰選擇下一步:預先定義的應用程式邏輯,還是模型。Anthropic 的工作流程與 agent 指南 區分了這兩者,並建議先採用能滿足任務的最簡單方案。混合系統可以結合兩者。
假設客戶說:「我收到錯誤的商品。你們的退貨政策是什麼?可以幫我開始退貨嗎?」以下是假設的設計範例,不是已記錄的 Quickchat AI 執行過程,也不是內建的退款流程。
| 階段 | 允許執行的工作 | 宣稱成功前所需的證據 |
|---|---|---|
| 回答政策問題 | 檢索已公布的政策,不揭露私人訂單資料 | 適用的政策來源;回答不能證明這筆訂單符合退貨資格 |
| 讀取訂單 | 使用已驗證的客戶上下文,以及強制檢查對應訂單存取權的 API | 經授權且包含必要訂單欄位的回應;在聊天中輸入電子郵件或訂單編號不等於身分驗證 |
| 提出退貨申請 | 分別檢查寫入權限、政策條件,以及任何必要的客戶確認 | 退貨系統確認的結果,例如已受理的申請識別碼;這不等於退款已支付或退貨已完成 |
| 轉交例外情況 | 缺少授權、政策未支援例外,或寫入結果不確定時停止 | 已記錄的轉交請求及其已知目的地或佇列;不承諾已有真人回覆 |
確定性工作流程可以實作全部四個階段。僅回答問題的系統可以解釋政策,並引導客戶前往需要身分驗證的服務。Agent 可以在設定好的步驟中選擇,但仍須滿足相同的存取權與證據要求。
什麼是規則式 chatbot?
規則式 chatbot 以預先定義的邏輯,透過文字或語音與使用者對話。它結合意圖分類、實體擷取和腳本式對話流程。
規則式 chatbot 如何運作
典型的 chatbot 架構有三個元件:
-
自然語言理解(NLU): 解析使用者訊息,辨識意圖,也就是使用者想做什麼,並擷取實體,例如日期、產品名稱或訂單編號等具體資料。大多數 NLU 系統結合正規表示式、關鍵字比對和經過訓練的分類器。
-
對話管理器: 根據目前的對話狀態和辨識出的意圖決定下一步的狀態機。每個狀態都有一組可能的轉換,對話管理器沿著定義好的流程執行。
-
回應產生器: 取得與目前狀態對應的回覆範本。簡單的 chatbot 使用查詢表;稍複雜的版本則在範本中留有欄位,用擷取到的實體填入。
服務驗證客戶身分並檢查訂單存取權後,簡化的假設流程如下:
使用者:「訂單 #12345 的狀態是什麼?」
  → NLU: intent=order_status, entity={order_id: 12345}
  → 對話管理器:state=check_order → 經授權的 order_status_api(12345)
  → 回應:「訂單 #12345 已於 4 月 7 日出貨,預計 4 月 11 日送達。」
架構如下:

這種方式適合封閉領域問題,也就是可用意圖數量少且定義明確的情況。FAQ 機器人、預約排程器或訂單狀態查詢器,都可以這樣建立。
規則式架構的限制
狀態機必須明確處理其支援的路徑。實際限制取決於分類器、工作流程設計及整合範圍:
-
意圖覆蓋範圍: 請求必須對應到支援的意圖或備援路徑。即使經過訓練的分類器能泛化到不同於原句的說法,不熟悉的措辭仍可能被誤分類。重疊的意圖需要評估和維護。
-
預定義分支: 對話管理器可以合併多輪儲存的資訊,並據此選擇分支。新的決策類型仍需要規則或其他決策元件;流程圖不會在執行時自行創造新工作流程。
-
脆弱的實體擷取: 傳統欄位填充適合日期、數字和產品 SKU 等結構化輸入,但難以處理開放式描述、模糊指涉或多部分請求。
-
工作流程維護: 新用途可能需要增加意圖、分支、範本或整合。可重用元件有所幫助,但維護工作量必須實測,不能假設會以固定速率增加。
若想進一步了解 chatbot 架構的演變,請參閱從 NLP Chatbot 到生成式 AI。
什麼是 AI agent?
本文所稱的 AI agent,是由 LLM 根據任務和觀察結果選擇下一步或工具的系統。它可以在更大的腳本式工作流程內運作。持久記憶及修改外部系統的權限都是選用能力,不會因為使用 agent 這個名稱就自動具備。
「Agent」在 AI 研究中也有更廣泛的歷史意義:感知環境並朝目標採取行動的系統。本文聚焦於以 LLM 為基礎的協調,其中觀察、規劃、工具執行和評估可以重複進行,直到達到停止條件。
AI agent 如何運作
AI agent 的核心架構是推理迴圈,有時稱為 ReAct 迴圈,名稱來自將此模式形式化的 ReAct 論文。這個迴圈有四個階段:
-
觀察: Agent 接收使用者訊息,以及對話紀錄、系統指令和檢索到的上下文,例如相關知識庫文章。
-
推理: LLM 根據可用上下文選擇回覆、澄清問題或工具呼叫。與狀態圖中的固定轉換不同,這項選擇發生於執行時。它可能出錯,因此需要評估。
-
行動: 模型提出結構化呼叫,例如
search_knowledge_base(query="return policy")或create_return_request(order_id=12345)。應用程式控制與目的地 API 必須在執行前強制限制允許的操作及範圍。提出呼叫不等於獲得授權。 -
評估: 系統檢查結果,決定繼續、回覆或停止並交由人工審查。模型認為自己已完成,不是業務操作成功的獨立證據。應限制迴圈,並在需要時驗證外部狀態。

同一退貨情境可以表達為建議的控制流程。下列呼叫或結果均未實際執行或觀察。 操作名稱僅供說明,不是可以直接貼進 Quickchat AI 帳戶的設定。
客戶:「我收到錯誤的商品。可以幫我開始退貨嗎?」

[政策] 檢索適用的退貨政策,並引用其條件來源。
[讀取] 要求已驗證的客戶上下文及訂單層級存取權。
       透過經授權的服務查詢對應訂單。
       除非已驗證,否則將「收到錯誤商品」視為客戶陳述。
[關卡] 檢查退貨政策、寫入授權及必要確認。
       若缺少條件,則要求澄清或轉交人工。
[寫入] 僅在通過獨立的寫入關卡後提交退貨申請。
[檢查] 只有外部結果確認時,才回報申請已受理。
       受理申請不代表已支付退款。
       結果不確定時,檢查狀態或轉交人工,不要盲目重試。
[轉交] 記錄尚未釐清的事實及已知佇列或接收者。
       不要宣稱真人已經回覆。
具 agent 性質的部分,是依據上下文選擇下一個允許的步驟。服務仍需要定義好的工具、政策規則、身分檢查和失敗處理。固定工作流程也可以執行相同操作;架構改變的是協調方式,不是客戶的權限。
工具使用與 function calling
工具使用又稱 function calling,讓模型連接到檢索或外部操作。LLM 取得包含參數名稱、類型和說明的工具結構描述。它可以從可用工具中提出呼叫;應用程式決定該呼叫是否允許,以及如何揭露結果。
面向客戶的 AI agent 常見工具類別包括:
| 類別 | 範例 |
|---|---|
| 知識檢索 | 搜尋知識庫、查詢 FAQ、取得產品文件 |
| 資料查詢 | 檢查訂單狀態、取得帳戶資料、查詢庫存 |
| 寫入操作 | 建立退貨申請或工單、更新允許的客戶欄位;每項操作都需要各自的授權 |
| 通訊 | 傳送電子郵件、觸發簡訊、發文到 Slack |
| 升級處理 | 附上相關上下文及已知佇列或接收者,請求人工審查 |
結構描述定義呼叫格式,不會驗證客戶身分,也不會強制執行業務政策。應在目的地驗證參數和存取權、限制公開欄位,並區分讀取與會改變狀態的操作。單靠提示指令不能形成安全邊界。
建立會採取實際行動的 AI agent 教學說明如何在對話中呼叫已描述的 HTTP 請求。後續關於使用執行條件與儲存結果安排 Actions 順序 的文章介紹 Run only when 和 Save to memory。這些控制不會驗證客戶身分,也不會讓寫入操作自動具有冪等性;仍需要可信任的中繼資料和目的地授權。這些連結各自保有原本的示範情境;本文假設的退貨流程尚未經過測試。
記憶與上下文管理
腳本式 chatbot 可以儲存已填入的欄位,例如 order_id=12345 和 intent=order_status,以及對話紀錄或其他狀態。Agent 實作通常結合多種上下文,以處理開放式請求。這兩種架構都不會自動提供安全的跨工作階段記憶。
實用的上下文層次包括:
- 對話紀錄: 目前工作階段中的原始訊息序列。
- 工作記憶: 工具呼叫和推理步驟的中間結果,用來支援後續決策。
- 檢索上下文: 根據目前查詢,透過檢索增強生成(RAG)取得的知識庫文章、產品文件或客戶紀錄。
- 長期記憶(選用): 跨工作階段保留的使用者或帳戶事實,例如偏好語言、過往問題或訂閱級別。
在 LLM 的 token 視窗內管理上下文是工程限制。摘要、滑動視窗和選擇性檢索可以減少上下文大小,但可能遺漏重要細節。身分、權限和具權威性的交易狀態應保存在可信任的系統中,不要依賴模型摘要。
中間地帶:LLM chatbot 與 copilot
僅回答問題的 LLM chatbot 可以檢索相關知識,將其與使用者訊息一起交給模型,再傳回回覆。這種簡單設計沒有由模型主導的動作迴圈。它是一種實作模式,不是每個稱為 chatbot 或 copilot 的產品都遵循的定義。
對於政策問題,檢索並回答的系統可能就足夠。它可以處理多樣措辭,而不必為每種表達建立獨立意圖。檢索品質、支援語言和來源品質仍需要評估。
在退貨範例中,僅回答問題的系統解釋已公布的政策,但不會取得私人訂單資料或建立退貨申請。若需要這些操作,應加入經身分驗證的工作流程,或具有適當限制的工具。腳本式整合也可以完成這些操作。
混合設計也是常見的可行方案:LLM 分類請求,確定性工作流程強制執行必要檢查,再由模型草擬回覆。應評估決策在哪裡發生、允許哪些操作,以及傳回什麼證據,不要從「chatbot」、「copilot」或「agent」這些名稱推斷上述特性。
並排比較
中間欄描述本文使用的僅回答問題範例。RAG、持久狀態和 API 存取等功能,也可以與其他架構結合。
| 比較面向 | 規則式 chatbot | 僅回答問題的 LLM chatbot | AI 代理 |
|---|---|---|---|
| 核心引擎 | 意圖分類器與預先定義的邏輯 | LLM 搭配檢索及回答流程 | LLM 在受控迴圈內選擇步驟 |
| 回覆產生 | 範本與儲存的值 | 根據提供的上下文產生 | 根據上下文和可用工具結果產生 |
| 對話流程 | 定義好的轉換,包括多輪狀態 | 在設定的流程中回答或澄清 | 模型選擇下一個允許的步驟 |
| 工具使用 | 可將 API 呼叫建置於流程內 | 本例沒有動作工具 | 模型提出呼叫,應用程式強制檢查存取權 |
| 多步驟任務 | 明確的順序和分支 | 外部操作需要額外工作流程 | 可以在限制內選擇步驟順序 |
| 處理新請求 | 由分類器和備援覆蓋範圍決定行為 | 僅在上下文支持時回答 | 可能選出有用路徑,也可能做出錯誤決策 |
| 知識存取 | 設定好的搜尋、API 或儲存回覆 | 通常使用 RAG,依實作而定 | 通常使用 RAG 和工具,依實作而定 |
| 維護模式 | 維護流程、範本、整合和測試 | 維護來源、檢索和評估 | 維護來源、工具、政策和評估 |
| 成本結構 | 主機、整合、授權及人工工作 | 平台或模型用量加人工工作 | 平台或模型用量、工具及人工工作 |
| 失敗模式 | 路由錯誤、錯誤狀態或 API 錯誤 | 缺乏依據的回答或檢索失敗 | 缺乏依據的回答、工具誤用或不確定的寫入結果 |
| 延遲 | 取決於流程和下游服務 | 取決於檢索、模型和傳遞方式 | 取決於所選步驟、服務和傳遞方式 |
規則式 chatbot 仍然合理嗎?
合理。選擇能滿足任務品質、控制及回應時間要求的最簡單架構。對於穩定的表單、少量已核准答案,或步驟固定的授權查詢,腳本式流程可能已經足夠。加入模型並不會免除維護整合與政策的需要。
以下幾種條件可能適合預先定義的工作流程:
必須使用已核准措辭的回覆。 範本可以保留經審查的文字。這是一項控制措施,不是符合法規的證明;資格、揭露、存取權及審查義務仍取決於實際部署。
簡單且可重複的操作。 已知的順序在任何流量下都可能避免不必要的模型呼叫。應比較實際主機、授權、API 和維護費用,而非假設存在通用的流量門檻。
已經正常運作的整合。 保留可靠流程,並在評估證明有實用改善時,加入語言理解或選定工具。使用 LLM 不需要先替換所有意圖和流程。
當所需步驟不固定,而且模型主導的選擇能增加價值時,agent 架構值得評估。使用具代表性的任務和失敗案例確認這項價值;架構名稱本身不提供預設勝率。
AI agent 最擅長的場景
當請求足夠多樣,執行時選擇下一步可能有所幫助時,模型主導的協調就值得評估。以下是候選用途,不是已測得優越性的宣稱:
跨系統的客服請求。 退貨範例結合政策檢索、經授權的訂單讀取,以及另行授權的申請。模型可能有助於選擇下一個相關步驟,而固定工作流程仍是有效替代方案。
開放式產品問題。 關於團隊規模、通路存取和方案限制的問題,可能需要整合多項有文件依據的事實。檢索對僅回答問題的 chatbot 和 agent 都有幫助。兩者都不應從產品描述推斷法律合規性或未記載的權益。
銷售對話。 模型可以收集客戶陳述的需求,並檢索允許存取的 CRM 上下文。在宣稱更有效之前,應將建議準確度、同意條件及實用結果與現有流程比較。
多語言支援。 語言模型可以減少為各語言分別撰寫回覆的需要,但支援語言和品質有所差異。應在每個目標語言評估術語、語氣、政策忠實度和轉交流程。多語言回答不需要 agent 迴圈,這種迴圈也不會消除在地化工作。
升級處理決策。 設定好的規則和模型判斷,可以協助辨識知識不足或要求真人的情況。模型信心或情緒判斷不是決策正確的可靠證據。應將轉交請求和人員接手流程與 AI 回覆分開驗證。
若要了解平台元件背景,請參閱對話式 AI 平台指南。
AI agent 在生產環境中的運作方式
正式環境系統結合模型行為與應用程式控制。類似控制也能支援腳本式工作流程,並非 agent 專有。
防護措施與行為規則。 指令定義範圍、語氣和轉交行為。應用程式檢查限制允許的操作和停止條件。除了預期請求,也要測試拒絕和失敗情況;提示不保證每個回答都會遵循政策。
知識依據(RAG)。 檢索在生成前提供相關來源,可能減少缺乏依據的回答,但不保證事實正確。應利用實作實際提供的可追溯能力,檢查檢索來源和產生的主張。更多背景可參閱什麼是 AI 幻覺?。
工具存取與動作權限。 API 或 MCP 伺服器可以提供讀取與寫入。應限制憑證和允許操作、在目的地強制檢查客戶存取權,並將回傳文字視為資料。已設定的工具或模型提出的參數,都不能授予存取其他客戶訂單或執行未核准退款的權限。
Quickchat AI Agents 支援 Knowledge Base 回答及已設定的 API 與 MCP Actions。API Actions 可以使用在模型外部檢查的 Run only when 條件;應以可信任的中繼資料設置關卡,並保留目的地 API 的授權檢查。Human Handoff 暫停 AI 回覆,並將對話放入 Inbox;路由選擇團隊成員時會指派,否則保持未指派。指派不保證真人立即回覆。上述退貨流程需要合適的外部服務及設定,並非承諾提供原生退貨或退款履行功能。
成本與效能取捨
選擇 chatbot 或 AI agent,部分是架構決策,部分是經濟決策。
Chatbot 經濟性
腳本式工作流程可以避免 LLM 推論,但邊際成本不一定為零。應納入主機、平台授權、下游 API、監控及任何人工處理。兩種架構的簡單查詢都可能成本不高;應測量實際部署。
維護包括流程、範本、整合和測試覆蓋。Agent 系統還有提示、檢索、工具和評估方面的工作。應在相同任務範圍和期間估算兩者,不要假設其中一種維護負擔較低。
AI agent 經濟性
模型推論和工具執行會消耗資源,但平台帳單可能按點數、對話、解決件數、席次或訂閱計價。底層 token 成本不一定是客戶的計費單位。
直接比較現行條款:Quickchat AI 定價、Intercom 定價 和 Salesforce Agentforce 定價 使用各產品特定的單位和條件。檢查基本費、最低承諾、包含用量、超額費及可計費結果的定義。對話和經驗證的解決結果不能互換。AI agent 定價模式指南 說明如何比較這些範圍,而不將宣傳費率當成等值。
使用自己的合格請求群組估算每個經驗證結果的成本。納入失敗嘗試、重複聯絡、人工重工、持續支出及一次性設定。人工客服成本也取決於通路和成本範圍;寬泛的產業數字不是與你的部署相符的基準。釋出的員工時間代表可用產能,除非實際成本降低或避免原定支出,否則不等於現金節省。
相同期間的計算方式可參閱如何計算 Chatbot ROI。本文不預設解決率優勢或節省百分比。應測量首次有用回應時間及經驗證的完成時間,包括下游服務和轉交;兩種架構都沒有通用的延遲範圍。
以不同方式衡量成功
比較架構時採用共同的結果標準,再加入針對不同失敗模式的診斷。
工作流程診斷包括辨識出的意圖、備援原因、狀態轉換、API 錯誤,以及必要步驟的完成情況。流程完成不一定表示客戶問題已解決。
結果指標包括合格請求中的經驗證解決、重複聯絡、人工重工、附問卷回覆數的滿意度,以及每個經驗證結果的成本。對於 agent,還應檢查缺乏依據的主張、工具選擇、存取拒絕和不確定的寫入結果。不要把產生的回答、已受理的退貨申請和已完成的退款算成同一種結果。
Chatbot Analytics 指南 區分產品原生可觀察資料與需要外部證據的衡量方式,並附有使用合成資料的工作表。比較結果前,先定義分母與觀察期間;這份工作表不是效能基準。
保留足夠證據,分別稽核政策回答、授權查詢、外部狀態變更和轉交。檢索來源、工具回應及具權威性的系統狀態各有不同用途。評估時使用合成或經適當保護的紀錄,不要在共用範例中揭露客戶私密資料。
FAQ
我可以將現有 chatbot 轉換成 AI agent 嗎?
通常可以逐步加入語言理解或選定工具,同時保留有用的工作流程、知識和整合。由模型選擇工具是一項需要評估的架構變更。應保留授權、必要核准及可靠的確定性步驟,不要只為了使用 agent 名稱而捨棄它們。
AI agent 比 chatbot 更貴嗎?
沒有通用答案。應針對相同的合格任務和期間,比較訂閱、計費單位、用量、設定、維護及人工重工。模型呼叫增加資源成本,但實際售價模式不同。較高的解決率和現金節省都必須測量;釋出的員工時間不會自動變成省下的錢。
AI agent 會產生幻覺嗎?
會。檢索可以提供相關來源,但不保證回答正確。應檢查主張是否有來源支持,以及工具結果是否真的確認所述結果。對僅回答問題的 LLM chatbot 也應採用同樣的檢查,證據不足時轉交人工。
AI agent 能處理 chatbot 無法處理的任務嗎?
Agent 可能為既有流程未涵蓋的多樣請求選出有用步驟。腳本式 chatbot 也可以呼叫 API、保留狀態並完成多步驟任務。實際能力取決於整合、權限、政策和證據,不是介面名稱。退貨申請仍需要獨立的寫入授權。
延遲如何?
應以具代表性的任務測量首次有用回應時間和經驗證的完成時間,包括緩慢或失敗的下游呼叫。報告中位數、第 95 百分位數等分布,並與需求比較。更多模型或工具步驟可能增加延遲,但任一名稱都不能確立通用回應時間,也不會自動使延遲變得可接受。
「AI agent」只是「chatbot」的行銷改名嗎?
這些名稱有所重疊。Chatbot 描述互動介面,agent 協調通常表示模型在執行時選擇步驟或工具。應檢查實際流程、授權檢查、停止條件及結果證據。產品名稱本身不能證明更高的自主性、準確度或業務價值。