


Під час вибору розмовного AI для підтримки, продажів або внутрішніх інструментів помітно, що постачальники по-різному вживають назви «чатбот» і «AI-агент». Деякі продукти з назвою агент є лише інтерфейсом мовної моделі без інструментів. Деякі чатботи самостійно вибирають більше кроків, ніж продукти, які продають як агентів.
Чатбот є інтерфейсом розмови; AI-агент є одним зі способів керування роботою за ним. Сценарний чатбот може викликати API та зберігати стан. Агент може вибрати наступний крок із дозволених інструментів, але це не підтверджує особу користувача, право запису чи успішне завершення. Порівняймо три архітектури на гіпотетичній заявці на повернення товару.
Примітка щодо термінології
Галузь не має узгоджених визначень. Тому використовуємо три робочі категорії, а не сприймаємо назву продукту як специфікацію:
-
Чатбот на правилах: Наступний крок визначають класифікація намірів, виділення сутностей і заданий сценарій діалогу. Відповіді походять із шаблонів, а не LLM. Процес може зберігати стан, викликати API та вимагати погодження.
-
LLM-чатбот лише для відповідей: Модель відповідає з наданого контексту, часто знайденого в базі знань. У нашому прикладі вона не має інструментів дій. Інші продукти з назвами чатбот або копілот можуть мати інструменти, кілька викликів моделі та погодження людиною.
-
AI-агент: LLM вибирає кроки й інструменти в налаштованому циклі, використовуючи спостереження для наступного рішення. Пам’ять, права, умови зупинки та людська перевірка залежать від реалізації. Автономію обмежують фактично надані інструменти й повноваження.
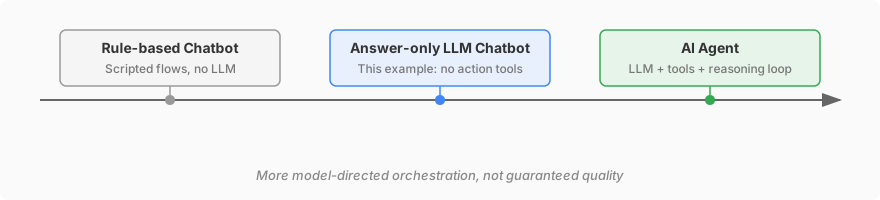 Це схематичні приклади. Більша роль моделі в керуванні не гарантує точності, нижчої вартості чи завершеного бізнес-результату.
Корисна відмінність полягає в тому, хто вибирає наступний крок: заздалегідь задана логіка застосунку чи модель. Посібник Anthropic про процеси й агентів описує це та радить починати з найпростішого рішення, яке виконує завдання. Гібридні системи можуть поєднувати обидва підходи.
Припустімо, клієнт пише: «Я отримав не той товар. Які правила повернення й чи можете ви почати повернення?» Нижче наведено гіпотетичний проєкт, а не запис роботи Quickchat AI чи вбудований процес виплати коштів.
| Етап | Дозволена робота | Доказ перед підтвердженням успіху |
|---|---|---|
| Відповісти про правила | Знайти опубліковані умови без розкриття приватних даних замовлення | Застосовне джерело правил; відповідь не доводить, що конкретне замовлення підходить |
| Прочитати замовлення | Використати автентифікований контекст клієнта й API з перевіркою доступу до потрібного замовлення | Авторизована відповідь із потрібними полями; e-mail або номер у чаті не є автентифікацією |
| Подати заявку | Окремо перевірити право запису, умови й необхідне підтвердження клієнта | Підтверджений результат системи повернень, наприклад ID прийнятої заявки; це не виплата коштів і не завершене повернення |
| Передати виняток | Зупинитися за відсутності прав, непідтримуваного винятку чи невизначеного результату запису | Запис запиту передачі та відомий отримувач або черга; без обіцянки, що людина вже відповіла |
Детермінований процес може реалізувати всі чотири етапи. Система лише для відповідей може пояснити правила й спрямувати клієнта до автентифікованого сервісу. Агент може вибирати налаштовані кроки, проте має виконати ті самі вимоги доступу й підтвердження.
Що таке чатбот на основі правил?
Чатбот на правилах веде текстову чи голосову розмову за наперед заданою логікою. Він поєднує класифікацію намірів, виділення сутностей і сценарії діалогу.
Як працюють чатботи на основі правил
Типова архітектура має три складники:
-
Розуміння природної мови (NLU): Аналізує повідомлення, визначає намір і виділяє дані, зокрема дати, назви товарів та номери замовлень. NLU зазвичай поєднує регулярні вирази, ключові слова й навчені класифікатори.
-
Менеджер діалогу: Автомат станів визначає наступний крок за станом розмови й наміром. Кожен стан має можливі переходи, якими рухається процес.
-
Генератор відповідей: Добирає шаблон поточного стану. У простій системі це таблиця відповідей; складніші шаблони мають поля для виділених значень.
Спрощений гіпотетичний перебіг після автентифікації клієнта й перевірки доступу до замовлення:
Користувач: «Який статус замовлення #12345?»
  → NLU: intent=order_status, entity={order_id: 12345}
  → Менеджер діалогу: state=check_order → авторизований order_status_api(12345)
  → Відповідь: «Замовлення #12345 надіслано 7 квітня, доставка очікується 11 квітня».
Схема архітектури:

Це підходить для завдань з обмеженою областю, де набір намірів невеликий і чіткий. Так можна побудувати FAQ, запис на зустріч або перевірку статусу замовлення.
Обмеження архітектури на основі правил
Автомат станів потребує явної обробки підтримуваних шляхів. Практичні обмеження залежать від класифікатора, проєкту процесу та інтеграцій:
-
Покриття намірів: Запит має потрапити до підтримуваного наміру чи fallback. Незвичне формулювання може класифікуватися хибно, хоча навчений класифікатор узагальнює поза точними фразами. Наміри, що перетинаються, потрібно оцінювати й підтримувати.
-
Задані розгалуження: Менеджер діалогу може поєднувати збережені дані з кількох реплік і вибирати гілки. Новому типу рішення потрібні правила або інший компонент; граф не створює нового процесу під час виконання.
-
Чутливе виділення сутностей: Заповнення полів працює для структурованих дат, чисел і SKU, але складніше обробляє вільні описи, неоднозначні посилання й багатоскладові прохання.
-
Підтримка процесу: Нові завдання можуть потребувати намірів, гілок, шаблонів або інтеграцій. Повторне використання компонентів допомагає, але трудовитрати варто вимірювати, а не припускати сталий темп їхнього зростання.
Розвиток архітектур описано в матеріалі Від NLP-чатботів до генеративного AI.
Що таке AI-агент?
Тут AI-агент означає систему, у якій LLM вибирає наступний крок або інструмент за завданням і спостереженнями. Вона може працювати в ширшому сценарному процесі. Постійна пам’ять і право змінювати зовнішні системи є додатковими можливостями, а не наслідками назви.
Термін «агент» має й ширшу історію в дослідженнях AI: система сприймає середовище та діє для досягнення мети. Ця стаття розглядає керування через LLM, де спостереження, планування, інструменти й оцінювання повторюються до виконання умови зупинки.
Як працюють AI-агенти
Основою описаної архітектури є цикл міркування, який іноді називають ReAct за роботою ReAct, що формалізувала цей підхід. Він має чотири фази:
-
Спостереження: Агент отримує повідомлення, історію розмови, системні інструкції й знайдений контекст, наприклад статті бази знань.
-
Міркування: LLM за контекстом вибирає відповідь, уточнення чи інструмент. На відміну від сталого переходу в графі вибір відбувається під час роботи. Він може бути помилковим і потребує оцінювання.
-
Дія: Модель пропонує структурований виклик, наприклад
search_knowledge_base(query="return policy")абоcreate_return_request(order_id=12345). Застосунок і цільове API перед виконанням мають забезпечити дозволену операцію та її область. Пропозиція виклику не є авторизацією. -
Оцінювання: Система розглядає результат і вирішує продовжити, відповісти чи зупинитися для людської перевірки. Висновок моделі «готово» не є незалежним доказом успішної бізнес-операції. Обмежуйте цикл і за потреби перевіряйте зовнішній стан.

Той самий сценарій повернення можна записати як запропонований процес. Жодних наведених нижче викликів і результатів не виконували й не спостерігали. Назви операцій ілюстративні; це не конфігурація Quickchat AI для вставлення в обліковий запис.
Клієнт: «Я отримав не той товар. Можете почати повернення?»

[Правила] Знайдіть застосовні умови повернення й укажіть обмеження.
[Читання] Вимагайте автентифікованого клієнта й доступу до замовлення.
          Отримайте потрібне замовлення через авторизований сервіс.
          «Не той товар» вважайте повідомленням клієнта, доки його не перевірено.
[Контроль] Перевірте правила, право запису й потрібне підтвердження.
           За відсутності умови уточніть запит або передайте людині.
[Запис]   Надішліть заявку лише після окремої перевірки права запису.
[Результат] Підтверджуйте прийняття лише за підтвердженням зовнішньої системи.
            Прийнята заявка не означає виплачені кошти.
            За невизначеності перевірте стан або передайте справу; не повторюйте наосліп.
[Передача] Запишіть невирішені факти й відому чергу або отримувача.
           Не стверджуйте, що людина вже відповіла.
Агентна частина полягає у виборі наступного дозволеного кроку за контекстом. Сервіс усе одно потребує визначених інструментів, правил, перевірки особи й обробки помилок. Сталий процес може виконувати ті самі операції; архітектура змінює керування, а не права клієнта.
Використання інструментів і виклик функцій
Використання інструментів, або виклик функцій, з’єднує модель із пошуком чи зовнішніми операціями. LLM отримує схеми назв, типів і описів параметрів. Вона може запропонувати доступний виклик; застосунок вирішує, чи дозволений він і як показати результат.
Типові категорії інструментів для клієнтського агента:
| Категорія | Приклади |
|---|---|
| Пошук знань | База знань, FAQ і документація продукту |
| Читання даних | Статус замовлення, відомості облікового запису й залишки |
| Запис | Заявка на повернення чи звернення, зміна дозволеного поля клієнта; кожна операція потребує власного права |
| Комунікація | Надсилання e-mail, SMS або повідомлення в Slack |
| Ескалація | Запит людської перевірки з потрібним контекстом і відомою чергою чи отримувачем |
Схема описує форму виклику, але не автентифікує клієнта й не застосовує бізнес-правила. Перевіряйте параметри та доступ у цільовій системі, обмежуйте поля й відокремлюйте читання від зміни стану. Самі інструкції промпту не утворюють межі безпеки.
Посібник зі створення агента, що виконує реальні дії, пояснює описаний HTTP-запит під час розмови. Продовження про порядок Actions, умови й збережені результати показує Run only when і Save to memory. Ці налаштування не підтверджують особу й не роблять запис ідемпотентним; потрібні довірені метадані й авторизація в цільовому сервісі. Демонстрації за посиланнями мають власний контекст; наведене тут повернення не тестували.
Пам’ять і керування контекстом
Сценарний чатбот може зберігати поля order_id=12345 і intent=order_status, історію й інший стан. Агенти часто поєднують кілька видів контексту для відкритих запитів. Жодна архітектура автоматично не надає безпечної пам’яті між сесіями.
Корисні шари контексту:
- Історія розмови: Послідовність повідомлень поточної сесії.
- Робоча пам’ять: Проміжні результати інструментів і міркувань, що впливають на наступні рішення.
- Знайдений контекст: Статті бази знань, документація чи записи клієнта, отримані через RAG за поточним запитом.
- Довготривала пам’ять (необов’язкова): Факти між сесіями, наприклад мова, попередні проблеми й тариф.
Контекстне вікно LLM є технічним обмеженням. Підсумовування, ковзні вікна й вибірковий пошук зменшують обсяг, але можуть пропустити важливі подробиці. Особу, права й достовірний стан транзакцій зберігайте в довірених системах, а не лише в підсумку моделі.
Середній варіант: LLM-чатботи та копілоти
LLM-чатбот лише для відповідей може знайти знання, передати їх моделі з повідомленням і повернути відповідь. Цей простий проєкт не має керованого моделлю циклу дій. Це один спосіб реалізації, а не визначення всіх чатботів і копілотів.
Для питань про правила пошуку й відповіді може вистачити. Модель обробляє різні формулювання без окремого наміру для кожного. Якість пошуку, мов і джерел усе одно потрібно оцінювати.
У прикладі повернення така система пояснює опубліковані умови, але не читає приватне замовлення й не створює заявку. Якщо операції потрібні, додайте автентифікований процес або належно обмежені інструменти. Їх може виконувати й сценарна інтеграція.
Можливі гібриди: LLM класифікує прохання, детермінований процес застосовує перевірки, а модель пише відповідь. Оцінюйте місце рішень, дозволені операції та повернені підтвердження, а не виводьте їх із назв чатбот, копілот чи агент.
Пряме порівняння
Середній стовпець описує використаний тут приклад лише для відповідей. RAG, постійний стан і доступ до API можна поєднувати з іншими архітектурами.
| Вимір | Чатбот на правилах | LLM-чатбот лише для відповідей | AI-агент |
|---|---|---|---|
| Основа | Класифікатор намірів і задана логіка | LLM із процесом пошуку й відповіді | LLM вибирає кроки в контрольованому циклі |
| Відповіді | Шаблони й збережені значення | Генерація з наданого контексту | Генерація з контексту й результатів інструментів |
| Діалог | Визначені переходи, включно зі станом кількох реплік | Відповідь чи уточнення за конфігурацією | Модель вибирає наступний дозволений крок |
| Інструменти | API можуть бути частиною сценарію | У цьому прикладі інструментів дій немає | Модель пропонує виклики, застосунок перевіряє доступ |
| Кілька кроків | Явна послідовність і гілки | Зовнішнім операціям потрібен додатковий процес | Може вибирати послідовність у межах обмежень |
| Нові запити | Залежить від класифікатора й fallback | Відповідь лише за підтримки контекстом | Може вибрати корисний шлях або помилкове рішення |
| Знання | Налаштований пошук, API чи готові відповіді | Часто RAG, залежить від реалізації | Часто RAG та інструменти, залежить від реалізації |
| Підтримка | Процеси, шаблони, інтеграції й тести | Джерела, пошук та оцінювання | Джерела, інструменти, правила й оцінювання |
| Вартість | Хостинг, інтеграції, ліцензії та праця людей | Платформа чи модель і праця людей | Платформа чи модель, інструменти й праця людей |
| Помилки | Хибний маршрут, стан чи помилка API | Непідтверджена відповідь або помилка пошуку | Непідтверджена відповідь, хибний інструмент чи невизначений запис |
| Затримка | Залежить від процесу й зовнішніх сервісів | Залежить від пошуку, моделі й доставки | Залежить від вибраних кроків, сервісів і доставки |
Чи досі мають сенс чатботи на основі правил?
Так. Вибирайте найпростішу архітектуру, що відповідає вимогам якості, контролю й часу відповіді. Сценарію може вистачити для стабільної форми, затверджених відповідей чи авторизованого читання з фіксованими кроками. Модель не усуває підтримки інтеграцій і правил.
Кілька умов можуть сприяти наперед визначеним процесам:
Відповідям потрібне затверджене формулювання. Шаблони зберігають перевірений текст. Це один контроль, не доказ правової відповідності; застосовність, повідомлення, доступ і перевірки залежать від впровадження.
Прості повторювані операції. Відома послідовність може уникати зайвих викликів моделі за будь-якого трафіку. Порівнюйте реальні витрати хостингу, ліцензій, API й підтримки замість універсального порогу обсягу.
Інтеграції, які вже працюють. Зберігайте надійні процеси, додаючи мовне розуміння чи інструменти там, де оцінювання показує користь. Заміна всіх намірів і сценаріїв не є передумовою LLM.
Агентний підхід варто оцінювати, коли кроки змінюються й вибір моделлю додає цінності. Перевіряйте це на представницьких завданнях і помилках; назва архітектури не задає типової успішності.
Де AI-агенти найсильніші
Керування моделлю варто досліджувати для достатньо різноманітних запитів, де вибір наступного кроку під час роботи може допомогти. Це можливі застосування, а не виміряна перевага:
Підтримка через кілька систем. Повернення поєднує правила, авторизоване читання й окремо дозволену заявку. Модель може допомогти вибрати крок, тоді як сталий процес залишається повноцінною альтернативою.
Відкриті питання про продукт. Розмір команди, канали й ліміти плану можуть вимагати кількох документованих фактів. Пошук допомагає і чатботу лише для відповідей, і агенту. Жоден не має виводити юридичну відповідність чи недокументовані можливості з опису продукту.
Продажі. Модель може зібрати заявлені вимоги й дозволений контекст CRM. Перед твердженням про більшу ефективність порівняйте точність рекомендацій, згоду й корисні результати з поточним процесом.
Кілька мов. Моделі можуть зменшити потребу в окремо написаних відповідях, але підтримка й якість мов різняться. Оцінюйте термінологію, тон, вірність правилам і ескалацію для кожної мови. Багатомовні відповіді не потребують агентного циклу й не усувають локалізації.
Рішення про ескалацію. Правила та судження моделі можуть помітити брак знань чи прохання про людину. Впевненість моделі або тональність не доводять правильність рішення. Перевіряйте передачу й роботу команди окремо від відповіді AI.
Компоненти платформ описує посібник із розмовних AI-платформ.
Як AI-агенти працюють у production
Робочі системи поєднують поведінку моделі з контролями застосунку. Схожі контролі підтримують сценарні процеси; вони не є винятковими для агентів.
Обмеження й поведінкові правила. Інструкції визначають область, тон та ескалацію. Застосунок обмежує операції й умови зупинки. Тестуйте відмови й помилки поряд зі звичними запитами; промпт не гарантує виконання правил кожною відповіддю.
Опора на знання (RAG). Пошук надає джерела перед генерацією й може зменшити непідтверджені відповіді. Правильності він не гарантує. Перевіряйте джерело та висновок із нього через фактично доступне відстеження. Докладніше в матеріалі про галюцинації AI.
Доступ до інструментів і повноваження. API або сервери MCP можуть надавати читання й запис. Обмежуйте облікові дані та операції, перевіряйте доступ клієнта в цільовій системі й сприймайте повернений текст як дані. Інструмент або параметри моделі не дають права на чуже замовлення чи непогоджену виплату.
Quickchat AI Agents підтримує відповіді з Knowledge Base і налаштовані API та MCP Actions. API Actions можуть застосовувати Run only when, які перевіряються поза моделлю; використовуйте довірені метадані й зберігайте авторизацію цільового API. Human Handoff призупиняє відповіді AI й розміщує розмову в Inbox: призначеною, якщо маршрутизація вибрала колегу, інакше непризначеною. Призначення не гарантує негайної людської відповіді. Для наведеного повернення потрібні відповідні зовнішні сервіси й конфігурація; це не обіцянка вбудованого виконання повернень або виплат.
Компроміси вартості та продуктивності
Вибір чатбота чи AI-агента є частково архітектурним, частково економічним рішенням.
Економіка чатботів
Сценарій може обійтися без інференсу LLM, але його гранична вартість не обов’язково нульова. Включайте хостинг, ліцензії, зовнішні API, моніторинг і роботу людей. Просте читання може бути дешевим в обох архітектурах; вимірюйте конкретне впровадження.
Підтримка охоплює процеси, шаблони, інтеграції й тести. Агенти додають роботу з промптами, пошуком, інструментами та оцінюванням. Оцінюйте обидва рішення для однакових завдань і періоду, не припускаючи менших витрат на одне з них.
Економіка AI-агентів
Інференс та інструменти споживають ресурси, але платформа може рахувати кредити, розмови, вирішені звернення, місця чи підписку. Внутрішня ціна токенів не обов’язково є одиницею розрахунку з клієнтом.
Порівнюйте актуальні умови безпосередньо: Quickchat AI, Intercom і Salesforce Agentforce мають власні одиниці й правила. Перевіряйте базову плату, мінімальне зобов’язання, включене використання, перевищення та визначення оплачуваного результату. Розмова й перевірене вирішення не є взаємозамінними. Посібник із моделей цін AI-агентів пояснює порівняння областей без прирівнювання рекламованих ставок.
Вартість підтвердженого результату оцінюйте на своїй групі відповідних запитів. Ураховуйте невдалі спроби, повторні звернення, виправлення людьми, поточні витрати й запуск. Вартість людської підтримки також залежить від каналу та складу витрат; широка галузева цифра не є порівнянним початковим рівнем. Вивільнений час є спроможністю, не грошовою економією, поки реальний видаток не зменшиться або не буде уникнено запланованого.
Розрахунок за спільний період описано в посібнику з ROI чатбота. Тут не припускається переваги частки вирішених справ чи відсотка економії. Вимірюйте час до першої корисної відповіді й підтвердженого завершення, включно із зовнішніми сервісами та передачею; жодна архітектура не має універсального діапазону затримки.
Успіх вимірюється по-різному
Порівнюйте архітектури за спільними критеріями результату, додаючи діагностику різних помилок.
Діагностика процесу охоплює розпізнані наміри, причини fallback, переходи станів, помилки API й виконання обов’язкових кроків. Завершений процес не обов’язково означає вирішену проблему клієнта.
Метрики результату включають перевірені вирішення серед відповідних запитів, повторні контакти, виправлення людьми, задоволеність разом із кількістю відповідей в опитуванні та вартість підтвердженого результату. Для агента перевіряйте також непідтверджені твердження, вибір інструмента, відмови доступу й невизначені записи. Згенерована відповідь, прийнята заявка й виконана виплата не є однаковими результатами.
Посібник з аналітики чатботів відокремлює власні спостереження продукту від метрик із зовнішніми доказами й містить синтетичний робочий аркуш. До порівняння визначте знаменник і період; аркуш не є бенчмарком.
Зберігайте докази для окремої перевірки відповіді про правила, авторизованого читання, зовнішньої зміни й передачі. Джерела, результати інструментів і достовірний стан системи мають різні ролі. Використовуйте синтетичні або належно захищені записи й не розкривайте приватні дані клієнтів у спільних прикладах.
FAQ
Чи можу я перетворити наявного чатбота на AI-агента?
Часто можна поступово додати мовне розуміння чи вибрані інструменти, зберігаючи корисні процеси, знання й інтеграції. Вибір інструментів моделлю змінює архітектуру й потребує оцінювання. Зберігайте авторизацію, потрібні погодження й надійні детерміновані кроки, а не відкидайте їх лише заради назви агент.
Чи AI-агенти дорожчі за чатботів?
Універсальної відповіді немає. Порівнюйте підписки, одиниці оплати, використання, впровадження, підтримку й людські виправлення для однакових завдань і періоду. Виклики моделі додають ресурсні витрати, але роздрібне ціноутворення різниться. Частку вирішень і грошову економію потрібно вимірювати; вивільнений час автоматично не стає заощадженими коштами.
Чи галюцинують AI-агенти?
Так. Пошук може дати відповідні джерела, але не гарантує правильної відповіді. Перевіряйте, чи твердження випливають із джерел і чи результат інструмента підтверджує заявлений підсумок. Так само оцінюйте LLM-чатботи лише для відповідей і передавайте людині справи з недостатніми доказами.
Чи може AI-агент виконувати завдання, які не може чатбот?
Агент може вибирати корисні кроки для змінних запитів поза наявним процесом. Сценарні чатботи теж можуть викликати API, зберігати стан і виконувати кілька кроків. Можливості залежать від інтеграцій, прав, правил і доказів, а не назви інтерфейсу. Заявці на повернення все одно потрібне окреме право запису.
А як щодо затримки?
Вимірюйте час до першої корисної відповіді й підтвердженого завершення на представницьких завданнях, включно з повільними та невдалими викликами. Порівнюйте розподіли, наприклад медіану й 95-й перцентиль, зі своїми вимогами. Додаткові кроки моделі чи інструментів можуть збільшити затримку, але назва не встановлює універсального часу й не робить його прийнятним.
Чи є «AI-агент» лише маркетинговим ребрендингом «чатбота»?
Назви перетинаються. Чатбот описує інтерфейс взаємодії, а агентне керування зазвичай означає вибір кроків чи інструментів моделлю під час роботи. Перевіряйте процес, права, умови зупинки й докази результату. Назва продукту сама не встановлює більшої автономії, точності чи бізнес-цінності.