

หากคุณกำลังประเมิน conversational AI สำหรับงานซัพพอร์ต งานขาย หรือเครื่องมือภายใน คุณน่าจะสังเกตเห็นว่าแต่ละผู้ให้บริการใช้คำว่า “chatbot” และ “AI agent” ในความหมายที่ต่างกันมาก ขึ้นอยู่กับสิ่งที่ตนขายอยู่ ผลิตภัณฑ์บางตัวที่ระบุว่าเป็น “AI agent” เป็นเพียงชั้นบาง ๆ ที่ครอบ language model โดยไม่มีการเข้าถึงเครื่องมือ ผลิตภัณฑ์บางตัวที่ระบุว่าเป็น “chatbot” กลับมีการให้เหตุผลแบบอัตโนมัติมากกว่าระบบที่เรียกตัวเองว่า agent
บทความนี้นิยามระบบ conversational AI เป็น 3 หมวดตามสถาปัตยกรรม อธิบายว่าระบบแต่ละแบบทำอะไรได้จริง และควรใช้แบบใดในสถานการณ์ใด เป้าหมายคือให้พื้นฐานทางเทคนิคที่เพียงพอสำหรับการประเมินผลิตภัณฑ์จากสถาปัตยกรรมจริง ไม่ใช่จากการตั้งชื่อแบรนด์
หมายเหตุเรื่องคำศัพท์
อุตสาหกรรมนี้ยังไม่มีนิยามที่เป็นมาตรฐานเดียวกัน บทความนี้จึงใช้ 3 หมวดดังนี้:
-
Chatbot แบบ rule-based: ระบบที่สร้างจาก intent classification, entity extraction และ scripted dialogue flows ไม่มี language model เข้ามาเกี่ยวข้องในการสร้างคำตอบ นี่คือสถาปัตยกรรม chatbot แบบดั้งเดิมที่มีมาตั้งแต่ทศวรรษ 2010
-
LLM chatbot (หรือ copilot): ระบบที่ใช้ large language model เพื่อทำความเข้าใจและสร้างคำตอบ แต่ทำงานในรูปแบบ request-response โดยไม่มีการใช้เครื่องมือแบบอัตโนมัติหรือการให้เหตุผลหลายขั้นตอน ผลิตภัณฑ์ “AI chatbot” จำนวนมากในตลาดอยู่ในหมวดนี้ ระบบเหล่านี้ยืดหยุ่นกว่า chatbot แบบ rule-based เพราะ LLM จัดการภาษาปลายเปิดได้ แต่ไม่ได้ลงมือทำในระบบภายนอกหรือวางแผนเวิร์กโฟลว์หลายขั้นตอน
-
AI agent: ระบบที่สร้างรอบ LLM ซึ่งสามารถให้เหตุผลเกี่ยวกับงาน ใช้เครื่องมือ รักษาหน่วยความจำข้ามการโต้ตอบ และดำเนินเวิร์กโฟลว์หลายขั้นตอนแบบอัตโนมัติ LLM ทำงานอยู่ภายใน loop ที่สังเกต ให้เหตุผล ลงมือทำ และประเมินว่างานเสร็จสมบูรณ์หรือไม่
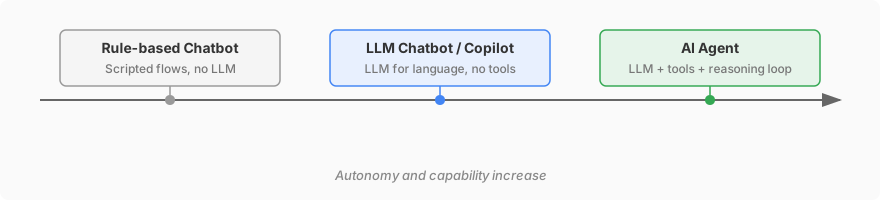 Autonomy และความสามารถเพิ่มขึ้นจากซ้ายไปขวา ผลิตภัณฑ์ “AI chatbot” ส่วนใหญ่ในปี 2026 อยู่บริเวณใดบริเวณหนึ่งบนสเปกตรัมนี้
ส่วนที่เหลือของบทความนี้ครอบคลุมทั้ง 3 หมวด แม้ว่ารายละเอียดเชิงสถาปัตยกรรมส่วนใหญ่จะอยู่ที่ chatbot แบบ rule-based และ AI agent เพราะสองแบบนี้มีช่องว่างกว้างที่สุด ส่วน LLM chatbot จะสั้นกว่า เพราะในเชิงสถาปัตยกรรมเป็น AI agent เวอร์ชันที่ถูกจำกัด: ใช้ language model แบบเดียวกัน แต่ไม่มี tool-use loop
Chatbot แบบ rule-based คืออะไร?
Chatbot แบบ rule-based ดำเนินบทสนทนากับผู้ใช้ผ่านข้อความหรือเสียงโดยใช้ตรรกะที่กำหนดไว้ล่วงหน้า สร้างขึ้นจากการผสมผสานระหว่าง intent classification, entity extraction และ scripted dialogue flows
Chatbot แบบ rule-based ทำงานอย่างไร
สถาปัตยกรรม chatbot ทั่วไปมี 3 องค์ประกอบ:
-
Natural Language Understanding (NLU): แยกวิเคราะห์ข้อความของผู้ใช้เพื่อระบุ intent (สิ่งที่ผู้ใช้ต้องการ) และดึง entities (ข้อมูลเฉพาะ เช่น วันที่ ชื่อสินค้า หรือหมายเลขคำสั่งซื้อ) ระบบ NLU ส่วนใหญ่ใช้ regex patterns, keyword matching และ classifiers ที่ผ่านการเทรนร่วมกัน
-
Dialogue Manager: state machine ที่กำหนดขั้นตอนถัดไปตามสถานะปัจจุบันของบทสนทนาและ intent ที่รู้จำได้ แต่ละ state มีชุดของ transitions ที่เป็นไปได้ และ dialogue manager จะเดินตาม flow ที่กำหนดไว้
-
Response Generator: ดึงคำตอบแบบ template ที่เชื่อมกับ state ปัจจุบัน ใน chatbot แบบง่าย นี่คือ lookup table ในระบบที่ซับซ้อนขึ้นเล็กน้อย template จะมี slots ที่ถูกเติมด้วย entities ที่ดึงมาได้
Flow แบบย่อมีลักษณะดังนี้:
ผู้ใช้: "สถานะของคำสั่งซื้อ #12345 เป็นอย่างไร?"
  → NLU: intent=order_status, entity={order_id: 12345}
  → Dialogue Manager: state=check_order → call order_status_api(12345)
  → Response: "คำสั่งซื้อ #12345 จัดส่งเมื่อวันที่ 7 เมษายน และคาดว่าจะถึงภายในวันที่ 11 เมษายน"
สถาปัตยกรรมมีลักษณะดังนี้:
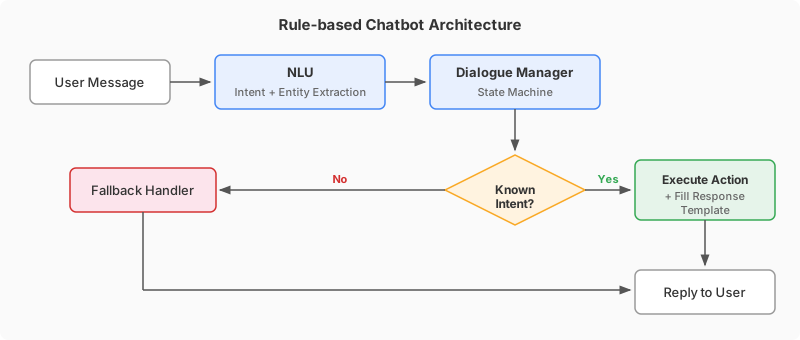
วิธีนี้ใช้ได้ดีสำหรับ ปัญหาแบบ closed-domain ที่ชุด intent ที่เป็นไปได้มีขนาดเล็กและนิยามชัดเจน FAQ bot, ระบบนัดหมาย หรือระบบตรวจสอบสถานะคำสั่งซื้อสามารถสร้างด้วยวิธีนี้ได้ทั้งหมด
ข้อจำกัดของสถาปัตยกรรมแบบ rule-based
โมเดล state machine เริ่มล้มเหลวเมื่อบทสนทนาคาดเดาไม่ได้ โดยเฉพาะอย่างยิ่ง:
-
Intent taxonomy ที่ตายตัว: ทุกคำขอของผู้ใช้ต้อง map ไปยัง intent ที่กำหนดไว้ล่วงหน้า หากผู้ใช้ใช้ถ้อยคำในแบบที่โมเดล NLU ไม่เคยเห็น คำขอนั้นจะตกไปยัง fallback handler เมื่อจำนวน intent เพิ่มขึ้น การดูแล taxonomy และการหลีกเลี่ยงความซ้ำซ้อนระหว่าง intent ที่คล้ายกันจะกลายเป็นภาระทางวิศวกรรมที่สำคัญ
-
ไม่มีการให้เหตุผลข้าม turn: Dialogue manager เดินตามกราฟที่ตายตัว ไม่สามารถรวมข้อมูลจากหลาย turn เพื่อใช้วิจารณญาณ ชั่งน้ำหนัก trade-offs หรือปรับแนวทางตามบริบทได้
-
Entity extraction เปราะบาง: slot-filling แบบดั้งเดิมทำงานได้ดีกับ input ที่มีโครงสร้าง (วันที่ ตัวเลข SKU สินค้า) แต่มีปัญหากับคำอธิบายปลายเปิด การอ้างอิงที่กำกวม หรือคำขอที่มีหลายส่วน
-
ความพยายามเพิ่มขึ้นแบบเชิงเส้น: การรองรับ use case ใหม่หมายถึงการนิยาม intent ใหม่ dialogue flow ใหม่ response template ใหม่ และ integration code ใหม่ การเพิ่มแต่ละครั้งเพิ่มพื้นผิวการดูแลรักษาตามสัดส่วน
สำหรับรายละเอียดเพิ่มเติมเกี่ยวกับวิวัฒนาการของสถาปัตยกรรม chatbot ตลอดหลายปีที่ผ่านมา โปรดดู จาก NLP Chatbots สู่ Generative AI
AI agent คืออะไร?
AI agent คือระบบที่สร้างรอบ large language model (LLM) ซึ่งสามารถให้เหตุผลเกี่ยวกับงาน ใช้เครื่องมือ รักษาหน่วยความจำข้ามการโต้ตอบ และตัดสินใจว่าจะดำเนินการต่ออย่างไรโดยไม่ต้องเดินตาม flow ที่เป็นสคริปต์
คำว่า “agent” ในบริบทนี้มาจากสายงานวิจัย AI ซึ่ง agent หมายถึงระบบใดก็ตามที่รับรู้สภาพแวดล้อมและดำเนินการเพื่อบรรลุเป้าหมาย ในคลื่นแอปพลิเคชัน LLM ช่วงปี 2024-2026 คำว่า “AI agent” หมายถึงระบบที่ใช้ LLM เป็น reasoning engine ภายใน loop ที่ประกอบด้วย observation, planning, tool execution และ evaluation โดยเฉพาะ
AI agent ทำงานอย่างไร
สถาปัตยกรรมหลักของ AI agent คือ reasoning loop (บางครั้งเรียกว่า ReAct loop ตาม บทความ ReAct ที่ทำให้รูปแบบนี้เป็นทางการ) loop มี 4 ระยะ:
-
Observe: Agent รับข้อความของผู้ใช้พร้อมประวัติการสนทนา system instructions และ context ที่ดึงมาได้ (เช่น บทความจาก knowledge base ที่เกี่ยวข้อง)
-
Reason: LLM ประมวลผล context ทั้งหมดที่มีและตัดสินใจว่าจะทำอะไรต่อไป อาจเป็นการตอบผู้ใช้โดยตรง ถามคำถามเพื่อความชัดเจน หรือเรียกเครื่องมือ ขั้นตอน reasoning คือจุดที่ agent แตกต่างจาก chatbot มากที่สุด: แทนที่จะเดินตาม state graph, LLM จะสร้างแผนจากความเข้าใจของตนเกี่ยวกับงานนั้น
-
Act: หาก agent ตัดสินใจใช้เครื่องมือ ระบบจะสร้าง structured function call (เช่น
search_knowledge_base(query="refund policy for damaged items")หรือcreate_ticket(customer_id=456, issue="shipping delay")) ระบบดำเนินการ function และส่งผลลัพธ์กลับให้ agent -
Evaluate: Agent ตรวจสอบ output ของเครื่องมือและตัดสินใจว่างานเสร็จแล้วหรือยังต้องมีอีกขั้นตอน หากยังต้องทำต่อ loop จะเริ่มซ้ำจากระยะ reasoning
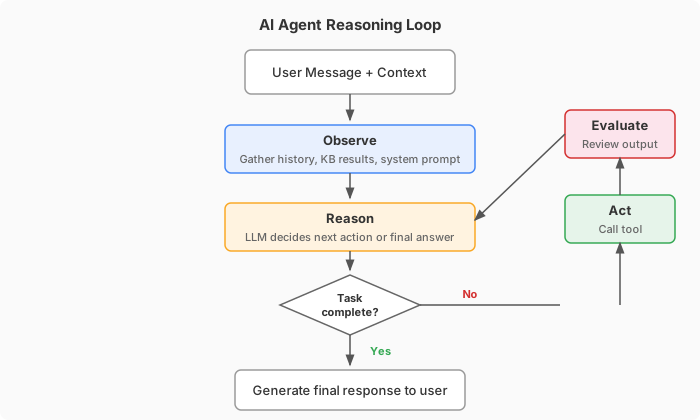
นี่คือตัวอย่างที่เป็นรูปธรรมของ loop นี้ในการทำงาน:
ผู้ใช้: "ฉันสั่งแล็ปท็อปเมื่อสัปดาห์ที่แล้ว แต่ได้รับจอภาพแทน
       ฉันต้องการให้ส่งสินค้าที่ถูกต้องและต้องการใบปะหน้าส่งคืนสำหรับจอภาพ"

Agent reasoning loop:
  [Reason] ผู้ใช้มีความต้องการสองอย่าง: การจัดส่งสินค้าที่ถูกต้อง + ใบปะหน้าส่งคืน
           ต้องค้นหาคำสั่งซื้อก่อน
  [Act]    lookup_order(customer_email="user@example.com", timeframe="7d")
           → Returns: คำสั่งซื้อ #7891, laptop SKU-A100, ส่ง monitor SKU-B200
  [Reason] พบคำสั่งซื้อแล้ว ยืนยันว่าจัดส่งสินค้าผิด ต้องเริ่มกระบวนการเปลี่ยนสินค้า
           และสร้างใบปะหน้าส่งคืน
  [Act]    initiate_exchange(order_id=7891, correct_sku="SKU-A100")
           → Returns: สร้าง Exchange #EX-442 แล้ว จัดส่งภายใน 1-2 วัน
  [Act]    generate_return_label(order_id=7891, item_sku="SKU-B200")
           → Returns: Label URL https://...
  [Evaluate] งานทั้งสองส่วนเสร็จแล้ว เขียนคำตอบ

Agent: "ฉันพบคำสั่งซื้อ #7891 ของคุณแล้ว แล็ปท็อปที่ถูกต้อง (SKU-A100) จะถูกจัดส่ง
        ภายใน 1-2 วันทำการ นี่คือใบปะหน้าส่งคืนสำหรับจอภาพ:
        [link] คุณสามารถนำไปส่งที่จุดรับของผู้ให้บริการขนส่งใดก็ได้"
ความแตกต่างหลักจากแนวทาง chatbot คือไม่จำเป็นต้องมีใครกำหนด intent “order_wrong_item_exchange_and_return” ล่วงหน้า หรือสร้าง dialogue flow เฉพาะสำหรับสถานการณ์นี้ Agent แยกปัญหาออกเป็นส่วน ๆ เรียกเครื่องมือที่ถูกต้องตามลำดับที่ถูกต้อง และเขียนคำตอบเอง
การใช้เครื่องมือและ function calling
การใช้เครื่องมือ (เรียกอีกอย่างว่า function calling) คือสิ่งที่ทำให้ AI agent สามารถลงมือทำกับโลกจริงได้ แทนที่จะสร้างข้อความเพียงอย่างเดียว LLM ได้รับรายการเครื่องมือที่มีอยู่พร้อม schemas (ชื่อ parameter, types, descriptions) และสามารถเลือกเรียกใช้เครื่องมือใดก็ได้ระหว่าง reasoning loop
หมวดเครื่องมือที่พบบ่อยสำหรับ AI agent ที่ติดต่อกับลูกค้า ได้แก่:
| Category | Examples |
|---|---|
| การดึงความรู้ | ค้นหา knowledge base, ค้นหา FAQ, ดึงเอกสารผลิตภัณฑ์ |
| การค้นหาข้อมูล | ตรวจสอบสถานะคำสั่งซื้อ, ดึงรายละเอียดบัญชี, query inventory |
| การเขียนข้อมูล | สร้าง support ticket, อัปเดต customer record, process refund |
| การสื่อสาร | ส่ง email, trigger SMS, post to Slack |
| Escalation | โอนต่อให้ human agent พร้อมบริบทบทสนทนาทั้งหมด |
Tool schema ทำหน้าที่เป็นสัญญาระหว่าง LLM และระบบภายนอก schema ที่ออกแบบดีให้ข้อมูลเพียงพอแก่ LLM เพื่อเลือกเครื่องมือที่ถูกต้องและให้ parameters ที่ถูกต้องโดยไม่ต้อง prompt เพิ่มเติม
หากต้องการดูการสร้างการใช้เครื่องมือตั้งแต่ต้น คู่มือทีละขั้นตอนของเราเกี่ยวกับ การสร้าง AI agent ที่ลงมือทำจริงได้ เพิ่มเครื่องมือประเภทนี้เพียงหนึ่งตัว คือ HTTP request ที่อธิบายไว้และ agent เรียกใช้กลางบทสนทนา ฟรีและไม่ต้องเขียนโค้ด เพื่อให้ write actions เหล่านั้น ทำงานตามลำดับที่ถูกต้อง และเพียงครั้งเดียวหลังจากค้นหาคำสั่งซื้อแล้ว คุณเพิ่ม run-condition และส่ง id ต่อไป
หน่วยความจำและการจัดการ context
Chatbot มักเก็บสถานะบทสนทนาเป็นชุดของ slots ที่เติมแล้ว (เช่น order_id=12345, intent=order_status) AI agent ต้องการโมเดลหน่วยความจำที่สมบูรณ์กว่า เพราะจัดการบทสนทนาปลายเปิดที่ข้อมูลสำคัญอาจปรากฏ ณ จุดใดก็ได้
การใช้งาน AI agent ส่วนใหญ่ใช้ context หลายชั้น:
- ประวัติการสนทนา: ลำดับข้อความดิบใน session ปัจจุบัน
- Working memory: ผลลัพธ์ระหว่างทางจาก tool calls และ reasoning steps ที่ใช้ประกอบการตัดสินใจถัดไป
- Retrieved context: บทความ knowledge base, เอกสารผลิตภัณฑ์ หรือ customer records ที่ดึงเข้ามาผ่าน retrieval-augmented generation (RAG) ตาม query ปัจจุบัน
- Long-term memory (ไม่บังคับ): ข้อเท็จจริงถาวรเกี่ยวกับผู้ใช้หรือบัญชีที่ส่งต่อข้าม sessions (เช่น ภาษาที่ต้องการ ปัญหาในอดีต subscription tier)
การจัดการ context ภายใน token window ของ LLM เป็นความท้าทายทางวิศวกรรมจริง เมื่อบทสนทนายาวขึ้นและมีการเรียกเครื่องมือมากขึ้น context อาจเกินความจุของโมเดล กลยุทธ์อย่าง summarization, sliding windows และ selective retrieval ช่วยให้ agent ยังทำงานได้โดยไม่สูญเสียข้อมูลสำคัญ
จุดกึ่งกลาง: LLM chatbots และ copilots
ผลิตภัณฑ์ส่วนใหญ่ที่ทำตลาดว่าเป็น “AI chatbots” ในปี 2026 อยู่ในหมวดระหว่าง chatbot แบบ rule-based และ AI agent เต็มรูปแบบ ระบบเหล่านี้ใช้ LLM เพื่อทำความเข้าใจ input ของผู้ใช้และสร้างคำตอบด้วยภาษาธรรมชาติ แต่ไม่มีสิทธิ์เข้าถึงเครื่องมือและไม่ได้ดำเนินเวิร์กโฟลว์หลายขั้นตอนแบบอัตโนมัติ
LLM chatbot ทั่วไปทำงานดังนี้: ผู้ใช้ส่งข้อความ ระบบดึง context ที่เกี่ยวข้องจาก knowledge base (ผ่าน RAG) ส่งข้อความและ context ไปยัง LLM แล้วส่งคำตอบที่สร้างขึ้นกลับมา ไม่มี reasoning loop ไม่มี tool selection และไม่มีการดำเนินการแบบวนซ้ำ ข้อความผู้ใช้แต่ละรายการกระตุ้น LLM call เพียงครั้งเดียว
สถาปัตยกรรมนี้เป็นการปรับปรุงที่สำคัญเมื่อเทียบกับ chatbot แบบ rule-based LLM จัดการภาษาปลายเปิดได้โดยไม่ต้องมี intent taxonomy ที่กำหนดไว้ล่วงหน้า สร้างคำตอบที่เป็นธรรมชาติแทนการเติม template และทำงานได้ในทุกภาษาที่โมเดลรองรับ สำหรับ use case แบบ Q&A ล้วน ๆ ที่เป้าหมายคือการตอบคำถามจาก knowledge base, LLM chatbot อาจเป็นสิ่งที่คุณต้องการทั้งหมด
ข้อจำกัดจะปรากฏเมื่อผู้ใช้ต้องการให้ระบบ ทำ บางอย่าง: ค้นหาคำสั่งซื้อ สร้าง ticket ดำเนินการ refund ตรวจสอบ inventory หรือประสานข้อมูลจากหลายแหล่ง LLM chatbot ทำได้เพียงแนะนำให้ผู้ใช้ทำสิ่งเหล่านี้เองหรือ escalate ไปยังมนุษย์ AI agent สามารถดำเนินการเหล่านั้นโดยตรง
ในทางปฏิบัติ เส้นแบ่งระหว่าง LLM chatbot และ AI agent ไม่ได้คมชัดเสมอไป การเพิ่มเครื่องมือเพียงตัวเดียว (เช่น order lookup) ให้ LLM chatbot จะขยับระบบไปทางปลายด้าน agent ของสเปกตรัม ความแตกต่างเป็นเรื่องของระดับ autonomy มากกว่าขอบเขตที่ตายตัว อย่างไรก็ตาม ความแตกต่างเชิงสถาปัตยกรรมมีความสำคัญ: LLM chatbot ที่ไม่มี reasoning loop ประมวลผลคำขอทีละครั้ง ขณะที่ agent สามารถเชื่อม observations และ actions หลายรายการเพื่อแก้ปัญหาที่ซับซ้อนได้
การเปรียบเทียบแบบเคียงข้างกัน
| Dimension | Rule-based Chatbot | LLM Chatbot / Copilot | AI Agent |
|---|---|---|---|
| Core engine | NLU classifier + state machine | LLM (single-turn) | LLM พร้อม reasoning loop |
| Response generation | Template lookup / slot filling | สร้างจาก context | สร้างจาก context + ผลลัพธ์เครื่องมือ |
| Conversation flow | Dialogue graph ที่กำหนดไว้ล่วงหน้า | ปลายเปิด แต่ทีละ exchange | Dynamic, multi-step, กำหนดขณะ runtime |
| Tool use | API calls ที่ hardcode ต่อ intent | ไม่มี | LLM เลือกเครื่องมือจากชุดที่มี |
| Multi-step tasks | ต้องมี flow ที่ระบุชัดสำหรับแต่ละ path | ไม่สามารถ chain actions | แยกงานเป็นส่วน ๆ แบบอัตโนมัติ |
| Handling novel requests | Fallback / “ฉันไม่เข้าใจ” | ตอบได้หากมี context ใน KB | ให้เหตุผลจาก context + ลงมือทำ |
| Knowledge access | Keyword search หรือ exact match | RAG พร้อม semantic search | RAG พร้อม semantic search และ reranking |
| Maintenance model | เพิ่ม intents, flows, templates ต่อ use case | อัปเดต knowledge base | ขยาย tool set และ knowledge base |
| Cost structure | Compute ต่ำ (ไม่มี LLM inference) | ต้นทุน LLM ต่อ token | ต้นทุน LLM ต่อ token + tool execution |
| Failure mode | Misrouting แบบเงียบหรือ fallback | Hallucination | Hallucination, การใช้เครื่องมือผิด |
| Latency | เร็ว (อิง lookup) | 1-3 วินาที (LLM call เดียว) | แปรผัน (ขึ้นกับ reasoning steps) |
Chatbot แบบ rule-based ยังสมเหตุสมผลหรือไม่?
สำหรับ use case ส่วนใหญ่ในปี 2026 คำตอบคือไม่ AI agent ดีพอ ถูกพอ และเชื่อถือได้พอ จนการเริ่มโปรเจกต์ใหม่ด้วย chatbot แบบ rule-based ยากที่จะให้เหตุผลสนับสนุน AI agent จัดการทุกอย่างที่ chatbot ทำได้ (FAQ, การค้นหาข้อมูลง่าย ๆ, การเก็บข้อมูล) พร้อมกับจัดการ long tail ของคำขอที่ chatbot ทำไม่ได้ ภาระการดูแลรักษาก็ต่ำกว่าเช่นกัน: แทนที่จะนิยาม intents และ flows สำหรับ use case ใหม่ทุกครั้ง คุณขยาย knowledge base และเพิ่มเครื่องมือ
มีสถานการณ์แคบ ๆ บางอย่างที่ chatbot แบบ rule-based อาจยังเป็นตัวเลือกที่เหมาะสมในเชิงปฏิบัติ:
ข้อกำหนดด้านกฎระเบียบที่ต้องใช้คำตอบแบบ deterministic และผ่านการอนุมัติล่วงหน้า ในอุตสาหกรรมที่มีการกำกับดูแลบางประเภท (การเปิดเผยข้อมูลด้านสุขภาพ การปฏิบัติตามกฎด้านการเงิน) ทุกคำตอบต้องผ่านการตรวจสอบและอนุมัติก่อน deployment Chatbot ที่มีคำตอบแบบ template ตอบโจทย์นี้โดยธรรมชาติ AI agent สามารถถูกจำกัดด้วย guardrails ได้ แต่ output ยังคงถูกสร้างขึ้น ไม่ใช่ข้อความที่อนุมัติล่วงหน้าแบบคำต่อคำ
ความไวต่อต้นทุนอย่างรุนแรงในสเกลขนาดใหญ่ หากคุณประมวลผล interactions แบบ single-turn หลายสิบล้านครั้งต่อเดือน และ use case เรียบง่ายจริง ๆ (เช่น ตรวจสอบยอดเงิน ยืนยันการจอง) ต้นทุน LLM inference ต่อ interaction อาจไม่คุ้มค่า เกณฑ์นี้ลดลงเรื่อย ๆ เมื่อค่าต้นทุนโมเดลลดลง แต่ ณ ต้นปี 2026 ยังมีอยู่ในปริมาณที่สูงมาก
Legacy systems ที่ไม่มีเส้นทาง migration บางองค์กรมี chatbot แบบ rule-based ที่ผสานลึกเข้ากับโครงสร้างพื้นฐานโดยไม่มีงบประมาณหรือไทม์ไลน์เพื่อเปลี่ยนระบบ ในกรณีเหล่านี้ คำถามไม่ใช่ “แบบไหนดีกว่า” แต่เป็น “ตอนนี้เราทำอะไรได้บ้าง”
นอกเหนือจาก edge cases เหล่านี้ AI agent เป็นค่าเริ่มต้นที่ดีกว่า คำถามเปลี่ยนจาก “เราควรใช้ AI agent หรือ chatbot” เป็น “เราจะ configure และ constrain AI agent ให้เหมาะกับ domain เฉพาะของเราอย่างไร”
จุดที่ AI agent แข็งแกร่งที่สุด
AI agent เหมาะอย่างชัดเจนสำหรับโปรเจกต์ conversational AI ใหม่ส่วนใหญ่ในปี 2026 ตัวอย่างสถานการณ์ที่ช่องว่างระหว่าง agent และ chatbot แบบ rule-based ใหญ่ที่สุด ได้แก่:
คำขอซัพพอร์ตที่ซับซ้อนและครอบคลุมหลายระบบ ตัวอย่างการเปลี่ยนคำสั่งซื้อด้านบนเป็นกรณีทั่วไป ผู้ใช้มีปัญหาแบบ compound ที่ต้องค้นหาข้อมูล ตัดสินใจ และลงมือทำหลายอย่าง Chatbot จะต้องมี flow เฉพาะสำหรับทุกชุดผสมที่เป็นไปได้ของปัญหา
คำถามเกี่ยวกับผลิตภัณฑ์แบบปลายเปิด “แผนใดเหมาะกับทีม 15 คนที่ต้องการ WhatsApp integration และ HIPAA compliance?” ต้องใช้การให้เหตุผลข้ามเอกสารผลิตภัณฑ์ กฎราคา และข้อกำหนด compliance Agent สามารถดึงเอกสารที่เกี่ยวข้องและสังเคราะห์คำตอบได้ Chatbot ต้องใช้ intent taxonomy ขนาดใหญ่เกินจริงเพื่อครอบคลุมคำถามผลิตภัณฑ์ทั้งหมดที่เป็นไปได้
บทสนทนาด้านการขาย การคัดกรอง leads, การตอบข้อโต้แย้ง และการแนะนำผลิตภัณฑ์ตามความต้องการที่ prospect อธิบาย ล้วนเป็นสิ่งที่ไม่เหมาะกับสคริปต์ตายตัว Agent ที่เข้าใจผลิตภัณฑ์และเข้าถึงข้อมูล CRM ได้มีประสิทธิภาพมากกว่า chatbot ที่เดินตาม branching script อย่างมาก
การซัพพอร์ตหลายภาษาในสเกลใหญ่ LLM จัดการหลายภาษาได้โดยธรรมชาติ AI agent จึงให้บริการลูกค้าในหลายสิบภาษาได้โดยไม่ต้องมีโมเดล NLU หรือ response templates แยกสำหรับแต่ละภาษา Chatbot แบบ rule-based ต้องมีข้อมูลเทรนหลายภาษาและ template เฉพาะสำหรับทุกภาษาที่รองรับ อย่างไรก็ตาม การ deploy LLM หลายภาษายังคงต้องมีงานเพิ่มเติม: ความสอดคล้องของคำศัพท์ การปรับ tone ต่อ locale, QA สำหรับภาษาที่มีทรัพยากรน้อย และการตรวจสอบ compliance สำหรับกฎระเบียบเฉพาะภูมิภาค Language model ลดภาระทางวิศวกรรมรายภาษา แต่ไม่ได้ตัดความจำเป็นของการกำกับดูแลด้าน localization
สถานการณ์ที่ต้องใช้วิจารณญาณและ escalation AI agent สามารถประเมินว่าตนมีความมั่นใจในคำตอบเพียงพอหรือไม่ ตรวจจับความไม่พอใจของลูกค้าผ่าน sentiment analysis และตัดสินใจ escalate ไปยังมนุษย์พร้อมบริบททั้งหมด พฤติกรรมแบบปรับตัวนี้เข้ารหัสใน state machine ได้ยาก
สำหรับพื้นฐานเกี่ยวกับการพัฒนาแพลตฟอร์ม conversational AI เพื่อรองรับ use case เหล่านี้ โปรดดู คู่มือแพลตฟอร์ม Conversational AI
AI agent ทำงานใน production อย่างไร
LLM ดิบที่ไม่มีข้อจำกัดไม่สามารถใช้งานได้ในสภาพแวดล้อมที่ติดต่อกับลูกค้า AI agent สำหรับ production ถูก configure ด้วยชั้นการควบคุมหลายชั้นที่กำหนดว่า agent พูดอะไรได้ ทำอะไรได้ และเมื่อใดควรหยุดและ hand off ไปยังมนุษย์ สิ่งเหล่านี้ไม่ได้ยืมมาจากสถาปัตยกรรม chatbot แต่เป็นคุณสมบัติพื้นฐานของวิธีที่แพลตฟอร์ม agent ทำงาน
Guardrails และกฎพฤติกรรม Agent ทำงานภายในขอบเขตที่ configure ได้: หัวข้อที่อนุญาต ข้อจำกัดด้าน tone และ personality, escalation thresholds และชุดเครื่องมือที่อนุมัติ หากลูกค้าถามหัวข้อที่อยู่นอก scope ของ agent, guardrails จะกำหนดว่า agent ควรปฏิเสธ เปลี่ยนเส้นทาง หรือ escalate สิ่งนี้ให้ความคาดเดาได้ที่ทีม operations ต้องการโดยไม่ต้อง hard-code dialogue flows
Knowledge grounding (RAG) เพื่อลด hallucination คำตอบของ agent จะถูก ground กับ knowledge base ที่คัดสรรผ่าน RAG (retrieval-augmented generation) Agent ดึงเอกสารที่เกี่ยวข้องก่อนสร้างคำตอบ และระบบสามารถ trace ได้ว่าเอกสารต้นทางใดมีอิทธิพลต่อคำตอบแต่ละรายการ สำหรับรายละเอียดเพิ่มเติมเกี่ยวกับการลด hallucination ในทางปฏิบัติ โปรดดู AI Hallucinations คืออะไร?
การเข้าถึงเครื่องมือและสิทธิ์ในการลงมือทำ Agent สามารถดำเนินการในระบบภายนอก (สร้าง tickets, process refunds, อัปเดต records, trigger workflows) ผ่าน APIs หรือ servers MCP เครื่องมือที่ agent เข้าถึงได้จะถูก configure ต่อ deployment support agent อาจมีสิทธิ์อ่านข้อมูลคำสั่งซื้อและสิทธิ์เขียนใน ticketing system แต่ไม่มีสิทธิ์แก้ไข billing สิทธิ์เหล่านี้เป็นสิ่งเทียบเท่ากับหลักการ least privilege ใน production
Quickchat AI Agents เป็นตัวอย่างหนึ่งของแพลตฟอร์มที่รวมทั้ง 3 ชั้น: guardrails ที่ configure ได้ คำตอบที่ ground ด้วย RAG พร้อม traceability ของแหล่งที่มา และการใช้เครื่องมือผ่าน APIs และ MCP
Trade-offs ด้านต้นทุนและประสิทธิภาพ
การเลือกระหว่าง chatbot และ AI agent เป็นทั้งการตัดสินใจด้านสถาปัตยกรรมและด้านเศรษฐศาสตร์
เศรษฐศาสตร์ของ chatbot
Chatbot แบบ rule-based มี marginal cost ต่อ interaction ใกล้ศูนย์ ต้นทุนโครงสร้างพื้นฐานคือการโฮสต์แอปพลิเคชันขนาดเบาพร้อมฐานข้อมูล intents และ responses สำหรับ use case ที่มีปริมาณสูงและความซับซ้อนต่ำ วิธีนี้เอาชนะด้านต้นทุนได้ยาก
ต้นทุนแฝงอยู่ในการดูแลรักษา use case ใหม่ทุกกรณีต้องใช้เวลาวิศวกรรมเพื่อกำหนด intents, สร้าง flows, เขียน templates และผสาน APIs เมื่อ chatbot มี scope กว้างขึ้น ต้นทุนการดูแลรักษานี้จะทบต้น องค์กรที่มี intents หลายร้อยรายการมักใช้จ่ายกับการดูแล chatbot มากกว่าที่จะใช้กับแพลตฟอร์ม AI agent
เศรษฐศาสตร์ของ AI agent
AI agent มีต้นทุนต่อ interaction เพราะทุกบทสนทนาต้องใช้ LLM inference (คิดราคาตาม token) รวมถึง overhead ของการเรียกเครื่องมือใด ๆ ต้นทุนต่อ resolved conversation แตกต่างกันตามความยาวบทสนทนา จำนวน tool calls และโมเดลพื้นฐาน
ต้นทุนต่อบทสนทนาที่ AI agent แก้ไขได้แตกต่างกันมากตามความยาวบทสนทนา การเลือกโมเดล และจำนวน tool calls แต่ผู้ให้บริการส่วนใหญ่ตั้งราคาระหว่าง $0.30 ถึง $2.00 ต่อ resolved conversation เพื่อเปรียบเทียบ Gartner ประเมิน ว่าต้นทุนเฉลี่ยของ support interaction ที่มนุษย์จัดการอยู่ที่ $5-$15 ขึ้นกับช่องทางและความซับซ้อน ตัวอย่างราคาต่อ resolution ที่เผยแพร่ ณ ต้นปี 2026: Intercom Fin คิด $0.99 ต่อ resolution, Quickchat AI คิด $0.50 ต่อ resolution ในแผน Enterprise และ Salesforce Agentforce คิด $2.00 ต่อ conversation
การคำนวณทางเศรษฐศาสตร์จะเอนเอียงไปทาง AI agent มากขึ้นเมื่อความซับซ้อนของบทสนทนาเพิ่มขึ้น Chatbot แบบ rule-based ที่จัดการคำขอขาเข้าได้เพียง 40% ยังต้อง route อีก 60% ที่เหลือไปยัง human agents AI agent ที่มี resolution rate สูงกว่า (ผู้ให้บริการรายงานตัวเลขตั้งแต่ 60% ถึง 90%+ ขึ้นกับ domain และคุณภาพของ knowledge base) ลดต้นทุนรวมของ support operations แม้ว่า AI interaction แต่ละรายการจะมีต้นทุนสูงกว่า chatbot interaction
สำหรับกรอบการทำงานโดยละเอียดในการคำนวณ trade-offs เหล่านี้ โปรดดู วิธีคำนวณ ROI ของ Chatbot
การวัดความสำเร็จต่างกัน
Chatbot และ AI agent ต้องใช้แนวทาง analytics ที่ต่างกัน เพราะล้มเหลวในวิธีที่ต่างกัน
Metrics ของ chatbot เน้น coverage: มี intents กี่รายการที่รู้จำได้ ข้อความกี่เปอร์เซ็นต์เข้าสู่ fallback และผู้ใช้ทำ flow ที่กำหนดไว้จนเสร็จบ่อยเพียงใด เครื่องมือ diagnostic หลักคือ fallback log ซึ่งแสดงว่าผู้ใช้ถามอะไรที่ chatbot จัดการไม่ได้
Metrics ของ AI agent เน้นคุณภาพของ outcome: agent แก้ปัญหาได้จริงหรือไม่ ลูกค้าพอใจหรือไม่ มีต้นทุนเท่าใด และคำตอบ grounded อยู่ในแหล่งข้อมูลที่ถูกต้องหรือไม่ metrics สำคัญได้แก่ AI resolution rate, cost per resolution, CSAT by AI interaction และ sentiment trends by topic
สำหรับคู่มือแบบครอบคลุมเกี่ยวกับ metrics เหล่านี้ รวมถึงวิธีตั้งค่า dashboards และ benchmarks ที่ควรตั้งเป้า โปรดดู Chatbot Analytics: คู่มือ KPIs, Dashboards และ Metrics
Traceability เป็นอีกมิติหนึ่งที่สำคัญต่อ AI agent มากกว่า chatbot เพราะ agent สร้างคำตอบแทนที่จะ lookup คุณต้องมีวิธีตรวจสอบว่าคำตอบของมัน grounded อยู่ใน knowledge base ของคุณและไม่ได้แต่งขึ้นเอง มองหาแพลตฟอร์มที่แสดงว่าเอกสารต้นทางใดมีอิทธิพลต่อคำตอบแต่ละรายการ เพื่อให้ทีมซัพพอร์ต audit และปรับปรุงพฤติกรรมของ agent ได้เมื่อเวลาผ่านไป
FAQ
ฉันสามารถแปลง chatbot เดิมให้เป็น AI agent ได้หรือไม่?
ไม่ได้โดยตรง เพราะสถาปัตยกรรมแตกต่างกันโดยพื้นฐาน อย่างไรก็ตาม assets จำนวนมากที่คุณสร้างไว้สำหรับ chatbot (เนื้อหา knowledge base, API integrations, ฐานข้อมูล FAQ) สามารถย้ายเข้าสู่การตั้งค่า AI agent ได้โดยตรง Knowledge base จะกลายเป็น RAG corpus และ API integrations จะกลายเป็นเครื่องมือที่ agent เรียกใช้ได้ สิ่งที่คุณทิ้งไปคือ intent taxonomy และนิยาม dialogue flow ซึ่ง LLM จะแทนที่ด้วย runtime reasoning
AI agent แพงกว่า chatbot หรือไม่?
ต่อ interaction ใช่ AI agent มีต้นทุน LLM inference ที่ chatbot แบบ rule-based ไม่มี อย่างไรก็ตาม AI agent มักแก้คำขอได้ในสัดส่วนที่สูงกว่ามากโดยไม่ต้องมีมนุษย์แทรกแซง (80%+ เทียบกับ 40-60% สำหรับ chatbot แบบดั้งเดิม) ซึ่งลดต้นทุนซัพพอร์ตโดยรวม ต้นทุนรวมในการเป็นเจ้าของขึ้นกับปริมาณบทสนทนาและสัดส่วนความซับซ้อนของคุณ
AI agent hallucinate หรือไม่?
อาจเกิดขึ้นได้ LLM อาจสร้างคำตอบที่ฟังดูสมเหตุสมผลแต่ไม่ถูกต้องตามข้อเท็จจริง นี่คือเหตุผลที่ AI agent สำหรับ production ใช้ RAG (retrieval-augmented generation) เพื่อ ground คำตอบกับวัสดุต้นทางที่ตรวจสอบแล้ว และเหตุผลที่ฟีเจอร์ traceability ซึ่งแสดงว่าเอกสารใดให้ข้อมูลสำหรับแต่ละคำตอบ มีความสำคัญต่อ production deployments
AI agent จัดการงานที่ chatbot ทำไม่ได้หรือไม่?
ได้ โดยเฉพาะงานที่ต้องใช้การให้เหตุผลข้ามแหล่งข้อมูลหลายแห่ง การดำเนินการหลายขั้นตอน การจัดการคำขอใหม่ที่ไม่ครอบคลุมโดย intent ที่กำหนดไว้ล่วงหน้า และการปรับพฤติกรรมตามบริบทบทสนทนา Chatbot จัดการได้เฉพาะงานที่ผู้ออกแบบคาดการณ์ไว้ชัดเจนและสร้าง flows รองรับ
แล้ว latency เป็นอย่างไร?
Chatbot ตอบในระดับมิลลิวินาทีเพราะทำ lookup AI agent มักตอบใน 1-5 วินาที ขึ้นกับจำนวน reasoning steps และ tool calls ที่ต้องใช้ สำหรับ use case ด้าน customer support และ sales ส่วนใหญ่ latency นี้ยอมรับได้ สำหรับแอปพลิเคชัน real-time ที่ต้องตอบต่ำกว่าหนึ่งวินาที chatbot หรือ cached response layer อาจจำเป็น
”AI agent” เป็นเพียงการ rebrand ทางการตลาดของ “chatbot” หรือไม่?
ไม่ใช่ ความแตกต่างอยู่ที่สถาปัตยกรรม Chatbot เดินตามสคริปต์ที่กำหนดไว้ล่วงหน้า AI agent ให้เหตุผลเกี่ยวกับงานขณะ runtime และตัดสินใจว่าจะทำอะไร สิ่งนี้คล้ายกับความแตกต่างระหว่างโปรแกรม if/else ที่ hardcode กับระบบที่ใช้ machine learning model ในการตัดสินใจ ทั้งสองอาจดูคล้ายกันจากภายนอก (ต่างก็สนทนาด้วยข้อความ) แต่กลไกภายในและความสามารถแตกต่างกัน