

إذا كنت تقيّم الذكاء الاصطناعي الحواري للدعم أو المبيعات أو الأدوات الداخلية، فمن المرجح أنك لاحظت أن المورّدين يستخدمون مصطلحي “الشات بوت” و”وكيل الذكاء الاصطناعي” بمعان مختلفة جدا حسب ما يبيعونه. بعض المنتجات التي تحمل تسمية “وكيل ذكاء اصطناعي” ليست سوى أغلفة بسيطة حول نموذج لغوي بلا وصول إلى الأدوات. وبعض المنتجات التي تحمل تسمية “شات بوت” تنفذ استدلالا ذاتيا أكثر من أنظمة تسمي نفسها وكلاء.
تعرّف هذه المقالة ثلاث فئات من أنظمة الذكاء الاصطناعي الحواري بناء على بنيتها، وتشرح ما تستطيع كل فئة فعله فعلا، وتوضح متى تستخدم كل واحدة. الهدف هو تزويدك بأساس تقني كاف لتقييم المنتجات وفق بنيتها الفعلية لا وفق علامتها التسويقية.
ملاحظة حول المصطلحات
لم تستقر الصناعة على تعريفات موحدة، لذلك تستخدم هذه المقالة ثلاث فئات:
-
شات بوت قائم على القواعد: نظام مبني على تصنيف المقاصد، واستخراج الكيانات، وتدفقات حوارية مكتوبة مسبقا. لا يشارك نموذج لغوي في توليد الردود. هذه هي البنية التقليدية للشات بوت، وهي موجودة منذ عقد 2010.
-
شات بوت قائم على LLM (أو copilot): نظام يستخدم نموذجا لغويا كبيرا لفهم الردود وتوليدها، لكنه يعمل وفق نمط طلب واستجابة من دون استخدام ذاتي للأدوات أو استدلال متعدد الخطوات. تندرج كثير من منتجات “شات بوت الذكاء الاصطناعي” في السوق ضمن هذه الفئة. وهي أكثر مرونة من الشات بوتات القائمة على القواعد لأن LLM يتعامل مع اللغة المفتوحة، لكنها لا تنفذ أفعالا في أنظمة خارجية ولا تخطط لتدفقات عمل متعددة الخطوات.
-
وكيل ذكاء اصطناعي: نظام مبني حول LLM يستطيع الاستدلال بشأن المهام، واستخدام الأدوات، والحفاظ على الذاكرة عبر التفاعلات، وتنفيذ تدفقات عمل متعددة الخطوات ذاتيا. يعمل LLM داخل حلقة يلاحظ فيها، ويستدل، ويتصرف، ويقيّم ما إذا كانت المهمة قد اكتملت.
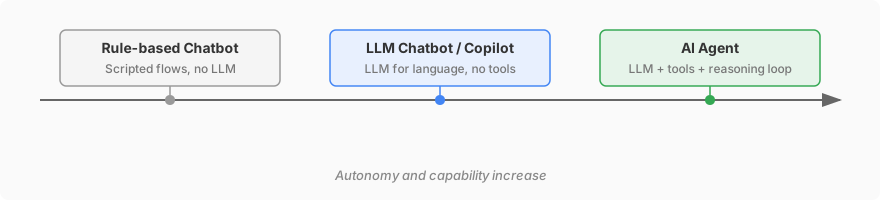 تزداد الاستقلالية والقدرة من اليسار إلى اليمين. تقع معظم منتجات “شات بوت الذكاء الاصطناعي” في 2026 في موضع ما ضمن هذا الطيف.
تغطي بقية هذه المقالة الفئات الثلاث كلها، لكن معظم التفصيل البنيوي يركز على الشات بوتات القائمة على القواعد ووكلاء الذكاء الاصطناعي لأنهما يمثلان الفجوة الأوسع. قسم شات بوت LLM أقصر لأن بنيته هي نسخة مقيدة من وكيل ذكاء اصطناعي: النموذج اللغوي نفسه، لكن من دون حلقة استخدام الأدوات.
ما الشات بوت القائم على القواعد؟
يجري الشات بوت القائم على القواعد محادثات مع المستخدمين عبر النص أو الصوت باستخدام منطق محدد مسبقا. وهو مبني على مزيج من تصنيف المقاصد، واستخراج الكيانات، وتدفقات حوارية مكتوبة مسبقا.
كيف تعمل الشات بوتات القائمة على القواعد
تتكون بنية الشات بوت النموذجية من ثلاثة مكونات:
-
فهم اللغة الطبيعية (NLU): يحلل رسالة المستخدم لتحديد مقصد (ما يريده المستخدم) واستخراج كيانات (بيانات محددة مثل التواريخ، أو أسماء المنتجات، أو أرقام الطلبات). تستخدم معظم أنظمة NLU مزيجا من أنماط regex، ومطابقة الكلمات المفتاحية، والمصنفات المدربة.
-
مدير الحوار: آلة حالات تحدد الخطوة التالية بناء على حالة المحادثة الحالية والمقصد المتعرّف عليه. لكل حالة مجموعة من الانتقالات الممكنة، ويتبع مدير الحوار التدفق المحدد.
-
مولد الردود: يسترجع ردا قالبيا مرتبطا بالحالة الحالية. في الشات بوتات البسيطة، يكون هذا جدول بحث. وفي الأنظمة الأكثر تطورا قليلا، يتضمن القالب خانات تمتلئ بالكيانات المستخرجة.
يبدو التدفق المبسط هكذا:
المستخدم: "ما حالة الطلب #12345؟"
  → NLU: intent=order_status, entity={order_id: 12345}
  → مدير الحوار: state=check_order → call order_status_api(12345)
  → الرد: "تم شحن الطلب #12345 في 7 أبريل ومن المتوقع وصوله بحلول 11 أبريل."
تبدو البنية هكذا:
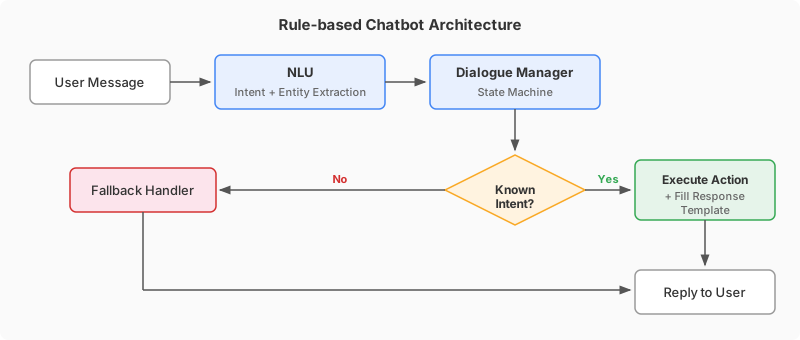
ينجح هذا جيدا في المشكلات ذات النطاق المغلق حيث تكون مجموعة المقاصد الممكنة صغيرة ومحددة جيدا. يمكن بناء بوت للأسئلة الشائعة، أو مجدول مواعيد، أو مدقق حالة الطلبات بهذه الطريقة.
قيود البنية القائمة على القواعد
ينهار نموذج آلة الحالات عندما تصبح المحادثات غير قابلة للتنبؤ. وتحديدا:
-
تصنيف مقاصد جامد: يجب أن يرتبط كل طلب مستخدم بمقصد محدد مسبقا. إذا صاغ المستخدم شيئا بطريقة لم يرها نموذج NLU من قبل، فإنه ينتقل إلى معالج fallback. ومع نمو عدد المقاصد، تصبح صيانة التصنيف وتجنب التداخل بين المقاصد المتشابهة عبئا هندسيا كبيرا.
-
لا يوجد استدلال عبر أدوار المحادثة: يتبع مدير الحوار رسما بيانيا ثابتا. لا يستطيع دمج المعلومات من عدة أدوار لاتخاذ حكم، أو موازنة المفاضلات، أو تكييف نهجه بناء على السياق.
-
استخراج كيانات هش: يعمل ملء الخانات التقليدي مع المدخلات المهيكلة (التواريخ، الأرقام، رموز SKU للمنتجات)، لكنه يواجه صعوبة مع الأوصاف المفتوحة، أو الإشارات الملتبسة، أو الطلبات متعددة الأجزاء.
-
توسع خطي في الجهد: دعم حالة استخدام جديدة يعني تعريف مقاصد جديدة، وتدفقات حوارية جديدة، وقوالب ردود جديدة، وكود تكامل جديد. كل إضافة تزيد سطح الصيانة بنسبة مماثلة.
للاطلاع بتفصيل أعمق على كيفية تطور بنيات الشات بوت على مر السنين، راجع من شات بوتات NLP إلى الذكاء الاصطناعي التوليدي.
ما وكيل الذكاء الاصطناعي؟
وكيل الذكاء الاصطناعي هو نظام مبني حول نموذج لغوي كبير (LLM) يستطيع الاستدلال بشأن المهام، واستخدام الأدوات، والحفاظ على الذاكرة عبر التفاعلات، واتخاذ قرارات حول كيفية المتابعة من دون اتباع تدفق مكتوب مسبقا.
يأتي مصطلح “agent” في هذا السياق من تقليد أبحاث الذكاء الاصطناعي حيث يكون الوكيل أي نظام يدرك بيئته ويتخذ أفعالا لتحقيق أهداف. في موجة تطبيقات LLM بين 2024 و2026، يشير “وكيل الذكاء الاصطناعي” تحديدا إلى الأنظمة التي تستخدم LLM كمحرك استدلال داخل حلقة تشمل الملاحظة، والتخطيط، وتنفيذ الأدوات، والتقييم.
كيف يعمل وكلاء الذكاء الاصطناعي
البنية الأساسية لوكيل الذكاء الاصطناعي هي حلقة استدلال (تسمى أحيانا حلقة ReAct، نسبة إلى ورقة ReAct التي صاغت النمط رسميا). تتكون الحلقة من أربع مراحل:
-
الملاحظة: يتلقى الوكيل رسالة المستخدم مع سجل المحادثة، وتعليمات النظام، وأي سياق مسترجع (مثل مقالات Knowledge Base ذات الصلة).
-
الاستدلال: يعالج LLM كل السياق المتاح ويقرر ما يجب فعله بعد ذلك. قد يكون ذلك الرد على المستخدم مباشرة، أو طرح سؤال توضيحي، أو استدعاء أداة. خطوة الاستدلال هي أكثر ما يميز الوكيل عن الشات بوت: بدلا من اتباع رسم حالات، يولد LLM خطة بناء على فهمه للمهمة.
-
التصرف: إذا قرر الوكيل استخدام أداة، فإنه يولد استدعاء دالة مهيكلا (مثل
search_knowledge_base(query="refund policy for damaged items")أوcreate_ticket(customer_id=456, issue="shipping delay")). ينفذ النظام الدالة ويعيد النتيجة إلى الوكيل. -
التقييم: يراجع الوكيل مخرجات الأداة ويقرر ما إذا كانت المهمة مكتملة أو إن كانت هناك حاجة إلى خطوة أخرى. إذا كان مطلوبا المزيد من العمل، تتكرر الحلقة من مرحلة الاستدلال.
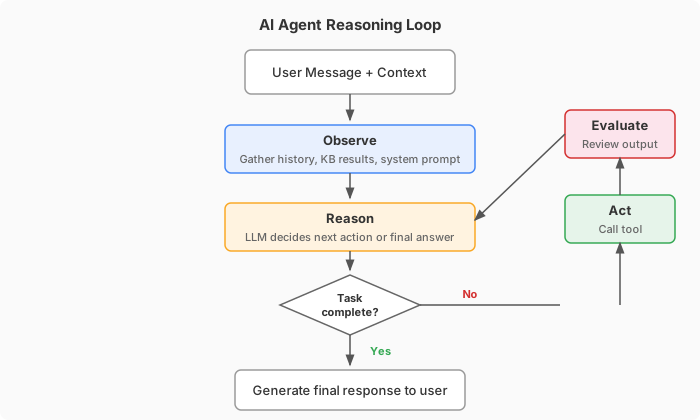
إليك مثالا ملموسا على هذه الحلقة أثناء العمل:
المستخدم: "طلبت حاسوبا محمولا الأسبوع الماضي لكنني استلمت شاشة بدلا منه.
       أحتاج إلى شحن المنتج الصحيح وملصق إرجاع للشاشة."

حلقة استدلال الوكيل:
  [الاستدلال] لدى المستخدم حاجتان: شحن المنتج الصحيح + ملصق إرجاع.
           يجب البحث عن الطلب أولا.
  [التصرف]    lookup_order(customer_email="user@example.com", timeframe="7d")
           → يعيد: الطلب #7891، الحاسوب المحمول SKU-A100، تم شحن الشاشة SKU-B200
  [الاستدلال] تم العثور على الطلب. تم تأكيد المنتج الخطأ. يجب بدء الاستبدال
           وإنشاء ملصق الإرجاع.
  [التصرف]    initiate_exchange(order_id=7891, correct_sku="SKU-A100")
           → يعيد: تم إنشاء الاستبدال #EX-442، الشحن خلال 1-2 أيام
  [التصرف]    generate_return_label(order_id=7891, item_sku="SKU-B200")
           → يعيد: رابط الملصق https://...
  [التقييم] اكتملت المهمتان. صياغة الرد.

الوكيل: "وجدت طلبك #7891. سيتم شحن الحاسوب المحمول الصحيح (SKU-A100)
        خلال 1-2 يوم عمل. إليك ملصق الإرجاع الخاص بالشاشة:
        [رابط]. سلّمه في أي موقع تابع لشركة شحن."
الفرق الأساسي عن نهج الشات بوت: لم يكن على أحد أن يعرّف مسبقا مقصدا باسم “order_wrong_item_exchange_and_return” أو يبني تدفقا حواريا محددا لهذا السيناريو. فكك الوكيل المشكلة، واستدعى الأدوات الصحيحة بالترتيب الصحيح، وصاغ ردا.
استخدام الأدوات واستدعاء الدوال
استخدام الأدوات (ويسمى أيضا استدعاء الدوال) هو ما يمنح وكلاء الذكاء الاصطناعي القدرة على الفعل في العالم بدلا من مجرد توليد النص. يتلقى LLM قائمة بالأدوات المتاحة مع مخططاتها (أسماء المعاملات، الأنواع، الأوصاف) ويمكنه اختيار استدعاء أي منها أثناء حلقة الاستدلال.
تشمل فئات الأدوات الشائعة لوكلاء الذكاء الاصطناعي الموجهين للعملاء:
| الفئة | أمثلة |
|---|---|
| استرجاع المعرفة | البحث في Knowledge Base، البحث في الأسئلة الشائعة، استرجاع وثائق المنتج |
| البحث عن البيانات | التحقق من حالة الطلب، جلب تفاصيل الحساب، الاستعلام عن المخزون |
| عمليات الكتابة | إنشاء تذكرة دعم، تحديث سجل العميل، معالجة استرداد |
| الاتصال | إرسال بريد إلكتروني، تشغيل SMS، النشر إلى Slack |
| التصعيد | التحويل إلى وكيل بشري مع سياق المحادثة الكامل |
يعمل مخطط الأداة كعقد بين LLM والنظام الخارجي. يمنح المخطط المصمم جيدا LLM معلومات كافية لاختيار الأداة الصحيحة وتقديم المعاملات الصحيحة من دون توجيه إضافي.
لرؤية استخدام الأدوات مبنيا من الصفر، يضيف دليلنا التفصيلي حول بناء وكيل ذكاء اصطناعي ينفذ أفعالا حقيقية أداة واحدة بالضبط من هذه الأدوات، وهي طلب HTTP موصوف يستدعيه الوكيل في منتصف المحادثة، مجانا ومن دون كود. ولجعل إجراءات الكتابة تلك تنفذ بالترتيب الصحيح، ومرة واحدة فقط بعد العثور على الطلب، تضيف شرط تشغيل وتنقل المعرّف إلى الأمام.
الذاكرة وإدارة السياق
تخزن الشات بوتات عادة حالة المحادثة كمجموعة من الخانات المملوءة (مثل order_id=12345، وintent=order_status). يحتاج وكلاء الذكاء الاصطناعي إلى نموذج ذاكرة أغنى لأنهم يتعاملون مع محادثات مفتوحة يمكن أن تظهر فيها المعلومات ذات الصلة في أي نقطة.
تستخدم معظم تطبيقات وكلاء الذكاء الاصطناعي طبقات متعددة من السياق:
- سجل المحادثة: التسلسل الخام للرسائل في الجلسة الحالية.
- ذاكرة العمل: النتائج الوسيطة من استدعاءات الأدوات وخطوات الاستدلال التي توجه القرارات اللاحقة.
- السياق المسترجع: مقالات Knowledge Base، أو وثائق المنتج، أو سجلات العملاء التي تُسحب عبر التوليد المعزز بالاسترجاع (RAG) بناء على الاستعلام الحالي.
- الذاكرة طويلة الأجل (اختيارية): حقائق مستمرة عن المستخدم أو الحساب تنتقل عبر الجلسات (مثل اللغة المفضلة، أو المشكلات السابقة، أو فئة الاشتراك).
إدارة السياق ضمن نافذة الرموز الخاصة بـ LLM تحد هندسي حقيقي. مع ازدياد طول المحادثات واستدعاء المزيد من الأدوات، يمكن أن يتجاوز السياق سعة النموذج. تساعد استراتيجيات مثل التلخيص، والنوافذ المنزلقة، والاسترجاع الانتقائي في إبقاء الوكيل قادرا على العمل من دون فقدان معلومات حرجة.
المنطقة الوسطى: شات بوتات LLM ومساعدو copilot
تقع معظم المنتجات التي تُسوّق بوصفها “شات بوتات ذكاء اصطناعي” في 2026 ضمن فئة بين الشات بوتات القائمة على القواعد ووكلاء الذكاء الاصطناعي الكاملين. تستخدم هذه الأنظمة LLM لفهم مدخلات المستخدم وتوليد ردود باللغة الطبيعية، لكنها لا تملك وصولا إلى الأدوات ولا تنفذ تدفقات عمل متعددة الخطوات ذاتيا.
يعمل شات بوت LLM النموذجي هكذا: يرسل المستخدم رسالة، فيسترجع النظام السياق ذي الصلة من Knowledge Base (عبر RAG)، ويمرر الرسالة والسياق إلى LLM، ثم يعيد الرد المولّد. لا توجد حلقة استدلال، ولا اختيار أدوات، ولا تنفيذ تكراري. تؤدي كل رسالة مستخدم إلى استدعاء LLM واحد.
هذه البنية تحسن كبير مقارنة بالشات بوتات القائمة على القواعد. يتعامل LLM مع اللغة المفتوحة من دون الحاجة إلى تصنيف مقاصد محدد مسبقا، ويولد ردودا طبيعية بدلا من ملء القوالب، ويمكنه العمل بأي لغة يدعمها النموذج. في حالات الاستخدام الخاصة بالأسئلة والأجوبة البحتة، حيث يكون الهدف الإجابة عن الأسئلة من Knowledge Base، قد يكون شات بوت LLM كل ما تحتاج إليه.
يظهر القيد عندما يحتاج المستخدم إلى أن يفعل النظام شيئا: البحث عن طلب، أو إنشاء تذكرة، أو معالجة استرداد، أو التحقق من المخزون، أو التنسيق بين عدة مصادر بيانات. لا يستطيع شات بوت LLM إلا أن يقترح على المستخدم تنفيذ هذه الأفعال بنفسه أو التصعيد إلى شخص. يستطيع وكيل الذكاء الاصطناعي تنفيذها مباشرة.
عمليا، ليس الحد الفاصل بين شات بوت LLM ووكيل الذكاء الاصطناعي حادا دائما. إضافة أداة واحدة (مثل البحث عن الطلبات) إلى شات بوت LLM تنقله نحو طرف الوكلاء في الطيف. يتعلق التمييز بدرجة الاستقلالية أكثر من كونه حدا صارما. ومع ذلك، يهم الفرق البنيوي: يعالج شات بوت LLM من دون حلقة استدلال طلبا واحدا في كل مرة، بينما يستطيع الوكيل ربط عدة ملاحظات وأفعال لحل مشكلات مركبة.
مقارنة جنبا إلى جنب
| البعد | الشات بوت القائم على القواعد | شات بوت LLM / Copilot | وكيل الذكاء الاصطناعي |
|---|---|---|---|
| المحرك الأساسي | مصنف NLU + آلة حالات | LLM (دور واحد) | LLM مع حلقة استدلال |
| توليد الردود | البحث في القوالب / ملء الخانات | مولّد من السياق | مولّد من السياق + نتائج الأدوات |
| تدفق المحادثة | رسم حواري محدد مسبقا | مفتوح، لكن تبادل واحد في كل مرة | ديناميكي، متعدد الخطوات، يتحدد وقت التشغيل |
| استخدام الأدوات | استدعاءات API مبرمجة لكل مقصد | لا شيء | يختار LLM الأدوات من المجموعة المتاحة |
| المهام متعددة الخطوات | تتطلب تدفقا صريحا لكل مسار | لا يستطيع ربط الأفعال | يفكك المهام ذاتيا |
| التعامل مع الطلبات الجديدة | Fallback / “لا أفهم” | يستطيع الإجابة إذا كان السياق موجودا في KB | يستدل من السياق + ينفذ فعلا |
| الوصول إلى المعرفة | بحث بالكلمات المفتاحية أو مطابقة تامة | RAG مع بحث دلالي | RAG مع بحث دلالي وإعادة ترتيب |
| نموذج الصيانة | إضافة مقاصد وتدفقات وقوالب لكل حالة استخدام | تحديث Knowledge Base | توسيع مجموعة الأدوات وKnowledge Base |
| بنية التكلفة | حوسبة منخفضة (لا استدلال LLM) | تكلفة LLM لكل رمز | تكلفة LLM لكل رمز + تنفيذ الأدوات |
| نمط الفشل | توجيه خاطئ صامت أو fallback | هلوسة | هلوسة، استخدام غير صحيح للأدوات |
| زمن الاستجابة | سريع (قائم على البحث) | 1-3 ثوان (استدعاء LLM واحد) | متغير (يعتمد على خطوات الاستدلال) |
هل ما زالت الشات بوتات القائمة على القواعد منطقية؟
في معظم حالات الاستخدام في 2026، لا. أصبح وكلاء الذكاء الاصطناعي جيدين بما يكفي، ورخيصين بما يكفي، وموثوقين بما يكفي بحيث يصعب تبرير بدء مشروع جديد بشات بوت قائم على القواعد. يتعامل وكيل الذكاء الاصطناعي مع كل ما يستطيع الشات بوت التعامل معه (الأسئلة الشائعة، عمليات البحث البسيطة، جمع البيانات)، إضافة إلى تعامله مع الذيل الطويل من الطلبات التي لا تستطيع الشات بوتات التعامل معها. عبء الصيانة أقل أيضا: بدلا من تعريف المقاصد والتدفقات لكل حالة استخدام جديدة، توسع Knowledge Base وتضيف أدوات.
هناك بعض الحالات الضيقة التي قد يظل فيها الشات بوت القائم على القواعد خيارا عمليا:
قيود تنظيمية تتطلب ردودا حتمية ومعتمدة مسبقا. في بعض القطاعات المنظمة (إفصاحات الرعاية الصحية، الامتثال المالي)، يجب مراجعة كل رد واعتماده قبل النشر. يحقق الشات بوت ذو الردود القالبية ذلك بحكم التصميم. يمكن تقييد وكلاء الذكاء الاصطناعي بحواجز، لكن المخرجات تظل مولّدة وليست معتمدة مسبقا كلمة بكلمة.
حساسية تكلفة قصوى على نطاق هائل. إذا كنت تعالج عشرات الملايين من التفاعلات ذات الدور الواحد شهريا وكانت حالة الاستخدام بسيطة فعلا (مثل التحقق من الرصيد، أو تأكيد حجز)، فقد لا تكون تكلفة استدلال LLM لكل تفاعل مبررة. يستمر هذا الحد في التحرك مع انخفاض تكاليف النماذج، لكنه لا يزال موجودا عند أحجام عالية جدا في أوائل 2026.
أنظمة قديمة بلا مسار ترحيل. لدى بعض المؤسسات شات بوتات قائمة على القواعد مدمجة بعمق في البنية التحتية من دون ميزانية أو جدول زمني لاستبدالها. في هذه الحالات لا يكون السؤال “أيهما أفضل” بل “ماذا يمكننا أن نفعل الآن.”
خارج هذه الحالات الطرفية، يكون وكيل الذكاء الاصطناعي هو الخيار الافتراضي الأفضل. انتقل السؤال من “هل نستخدم وكيل ذكاء اصطناعي أم شات بوت” إلى “كيف نهيئ وكيل الذكاء الاصطناعي ونقيده لمجالنا المحدد.”
أين يكون وكلاء الذكاء الاصطناعي أقوى؟
وكلاء الذكاء الاصطناعي هم الخيار الواضح لمعظم مشاريع الذكاء الاصطناعي الحواري الجديدة في 2026. فيما يلي بعض السيناريوهات التي تكون فيها الفجوة بين الوكلاء والشات بوتات القائمة على القواعد أكبر:
طلبات دعم معقدة تمتد عبر عدة أنظمة. مثال استبدال الطلب أعلاه نموذجي. لدى المستخدم مشكلة مركبة تتطلب البحث عن بيانات، واتخاذ قرارات، وتنفيذ عدة أفعال. سيحتاج الشات بوت إلى تدفق مخصص لكل تركيبة ممكنة من المشكلات.
أسئلة منتجات مفتوحة. “أي خطة تناسب فريقا من 15 شخصا يحتاج إلى تكامل WhatsApp وامتثال HIPAA؟” يتطلب ذلك استدلالا عبر وثائق المنتج، وقواعد التسعير، ومتطلبات الامتثال. يستطيع الوكيل استرجاع المستندات ذات الصلة وتركيب إجابة. سيحتاج الشات بوت إلى تصنيف مقاصد هائل إلى حد غير عملي لتغطية كل أسئلة المنتجات الممكنة.
محادثات المبيعات. تأهيل العملاء المحتملين، والرد على الاعتراضات، وتوصية المنتجات بناء على الاحتياجات التي يصفها العميل المحتمل كلها بطبيعتها غير مكتوبة مسبقا. الوكيل الذي يفهم المنتج ويمكنه الوصول إلى بيانات CRM أكثر فعالية بكثير من شات بوت يتبع نصا متفرعا.
دعم متعدد اللغات على نطاق واسع. تتعامل LLMs مع لغات متعددة بطبيعتها، لذلك يستطيع وكيل الذكاء الاصطناعي خدمة العملاء بعشرات اللغات من دون نماذج NLU منفصلة أو قوالب ردود لكل لغة. يتطلب الشات بوت القائم على القواعد بيانات تدريب متعددة اللغات وقوالب صريحة لكل لغة مدعومة. ومع ذلك، ما زالت عمليات نشر LLM متعددة اللغات تتطلب عملا: اتساق المصطلحات، وضبط النبرة لكل Locale، وضمان الجودة للغات الأقل موارد، ومراجعة الامتثال للوائح الخاصة بكل منطقة. يزيل النموذج اللغوي العبء الهندسي لكل لغة، لكنه لا يلغي الحاجة إلى إشراف التوطين.
سيناريوهات تتطلب الحكم والتصعيد. يستطيع وكيل الذكاء الاصطناعي تقييم ما إذا كانت لديه ثقة كافية في إجابته، واكتشاف إحباط العميل عبر تحليل المشاعر، واتخاذ قرار بالتصعيد إلى شخص مع السياق الكامل. يصعب ترميز هذا السلوك التكيفي في آلة حالات.
للاطلاع على خلفية حول كيفية تطور منصات الذكاء الاصطناعي الحواري لدعم حالات الاستخدام هذه، راجع دليل منصات الذكاء الاصطناعي الحواري.
كيف يعمل وكلاء الذكاء الاصطناعي في الإنتاج
سيكون LLM خام بلا قيود غير قابل للاستخدام في بيئة موجهة للعملاء. تُهيأ وكلاء الذكاء الاصطناعي في الإنتاج بطبقات تحكم تحدد ما يستطيع الوكيل قوله، وما يستطيع فعله، ومتى يجب أن يتوقف ويحوّل إلى شخص. هذه الطبقات ليست مستعارة من بنية الشات بوت، بل هي أصلية في طريقة عمل منصات الوكلاء.
الحواجز والقواعد السلوكية. يعمل الوكيل ضمن حدود قابلة للتهيئة: الموضوعات المسموح بها، وقيود النبرة والشخصية، وحدود التصعيد، ومجموعات الأدوات المعتمدة. إذا سأل العميل عن موضوع خارج نطاق الوكيل، تحدد الحواجز ما إذا كان الوكيل سيرفض، أو يعيد التوجيه، أو يصعّد. يمنح ذلك فرق العمليات القدرة على التنبؤ التي تحتاج إليها من دون كتابة تدفقات حوارية صلبة.
ترسيخ المعرفة (RAG). لتقليل الهلوسة، تُرسّخ ردود الوكيل في Knowledge Base منسقة عبر RAG (التوليد المعزز بالاسترجاع). يسترجع الوكيل المستندات ذات الصلة قبل توليد الرد، ويمكن للنظام تتبع أي مستندات مصدر أثرت في كل إجابة. للمزيد حول كيفية عمل تخفيف الهلوسة عمليا، راجع ما هلوسات الذكاء الاصطناعي؟.
الوصول إلى الأدوات وأذونات الأفعال. يستطيع الوكيل تنفيذ أفعال في أنظمة خارجية (إنشاء تذاكر، معالجة استردادات، تحديث سجلات، تشغيل تدفقات عمل) عبر APIs أو خوادم MCP. تُهيأ الأدوات التي يستطيع الوكيل الوصول إليها لكل نشر. قد يمتلك وكيل الدعم وصول قراءة إلى بيانات الطلبات ووصول كتابة إلى نظام التذاكر، لكن من دون وصول إلى تعديلات الفوترة. هذه الأذونات هي المكافئ الإنتاجي لمبدأ أقل صلاحية.
Quickchat AI Agents مثال لمنصة تجمع الطبقات الثلاث كلها: حواجز قابلة للتهيئة، وردود مرتكزة على RAG مع إمكانية تتبع المصادر، واستخدام أدوات عبر APIs وMCP.
مفاضلات التكلفة والأداء
الاختيار بين الشات بوت ووكيل الذكاء الاصطناعي قرار بنيوي جزئيا واقتصادي جزئيا.
اقتصاديات الشات بوت
تكاد تكون التكلفة الحدية لكل تفاعل في الشات بوتات القائمة على القواعد صفرا. تكلفة البنية التحتية هي استضافة تطبيق خفيف مع قاعدة بيانات للمقاصد والردود. في حالات الاستخدام عالية الحجم ومنخفضة التعقيد، يصعب التفوق على ذلك من ناحية التكلفة.
التكلفة المخفية في الصيانة. تتطلب كل حالة استخدام جديدة وقتا هندسيا لتعريف المقاصد، وبناء التدفقات، وكتابة القوالب، ودمج APIs. مع اتساع نطاق الشات بوت، تتراكم تكلفة الصيانة هذه. غالبا ما تنفق المؤسسات التي لديها مئات المقاصد على صيانة الشات بوت أكثر مما كانت ستنفقه على منصة وكيل ذكاء اصطناعي.
اقتصاديات وكيل الذكاء الاصطناعي
يتحمل وكلاء الذكاء الاصطناعي تكاليف لكل تفاعل لأن كل محادثة تتضمن استدلال LLM (مفوترة بالرموز) إضافة إلى أي عبء لتنفيذ الأدوات. تختلف تكلفة كل محادثة محلولة حسب طول المحادثة، وعدد استدعاءات الأدوات، والنموذج الأساسي.
تختلف تكلفة كل محادثة يحلها وكيل ذكاء اصطناعي اختلافا واسعا حسب طول المحادثة، واختيار النموذج، وعدد استدعاءات الأدوات، لكن معظم المورّدين يسعرون بين $0.30 و$2.00 لكل محادثة محلولة. للمقارنة، تقدر Gartner متوسط تكلفة تفاعل الدعم الذي يتولاه شخص بين $5-$15 حسب القناة والتعقيد. بعض الأسعار المنشورة لكل حل في أوائل 2026: تفرض Intercom Fin مبلغ $0.99 لكل حل، وتفرض Quickchat AI مبلغ $0.50 لكل حل في خطة Enterprise، وتفرض Salesforce Agentforce مبلغ $2.00 لكل محادثة.
يتحول الحساب الاقتصادي لصالح وكلاء الذكاء الاصطناعي مع زيادة تعقيد المحادثات. الشات بوت القائم على القواعد الذي لا يستطيع التعامل إلا مع 40% من الطلبات الواردة لا يزال يوجه 60% المتبقية إلى وكلاء بشريين. وكيل الذكاء الاصطناعي ذو معدل حل أعلى (يبلغ المورّدون عن أرقام تتراوح بين 60% و90%+ حسب المجال وجودة Knowledge Base) يقلل التكلفة الإجمالية لعمليات الدعم، حتى لو كانت تكلفة كل تفاعل ذكاء اصطناعي فردي أعلى من تفاعل الشات بوت.
لإطار مفصل حول حساب هذه المفاضلات، راجع كيفية حساب عائد الاستثمار للشات بوت.
قياس النجاح بطريقة مختلفة
تتطلب الشات بوتات ووكلاء الذكاء الاصطناعي مناهج تحليلية مختلفة لأنهم يفشلون بطرق مختلفة.
مقاييس الشات بوت تركز على التغطية: كم عدد المقاصد التي تُتعرّف، وما نسبة الرسائل التي تصل إلى fallback، وكم مرة يكمل المستخدمون التدفق المحدد. أداة التشخيص الأساسية هي سجل fallback، الذي يوضح ما يسأل عنه المستخدمون ولا يستطيع الشات بوت التعامل معه.
مقاييس وكيل الذكاء الاصطناعي تركز على جودة النتيجة: هل حل الوكيل المشكلة فعلا، وهل كان العميل راضيا، وكم كلف ذلك، وهل كان الرد مستندا إلى مصادر دقيقة. تشمل المقاييس الرئيسية معدل الحل بالذكاء الاصطناعي، وتكلفة كل حل، وCSAT حسب تفاعل الذكاء الاصطناعي، واتجاهات المشاعر حسب الموضوع.
للاطلاع على دليل شامل لهذه المقاييس، بما في ذلك كيفية إعداد لوحات المعلومات وما المعايير التي يجب استهدافها، راجع تحليلات الشات بوت: دليل KPIs ولوحات المعلومات والمقاييس.
قابلية التتبع بعد آخر يهم وكلاء الذكاء الاصطناعي أكثر من الشات بوتات. لأن الوكيل يولد الردود بدلا من البحث عنها، تحتاج إلى طريقة للتحقق من أن إجاباته مرتكزة على Knowledge Base وليست مختلقة. ابحث عن منصات تعرض أي مستندات مصدر أثرت في كل رد، حتى تتمكن فرق الدعم من تدقيق سلوك الوكيل وتحسينه بمرور الوقت.
الأسئلة الشائعة
هل يمكنني تحويل الشات بوت الحالي إلى وكيل ذكاء اصطناعي؟
ليس مباشرة، لأن البنيتين مختلفتان جوهريا. ومع ذلك، تنتقل كثير من الأصول التي بنيتها للشات بوت (محتوى Knowledge Base، وتكاملات API، وقواعد بيانات الأسئلة الشائعة) مباشرة إلى إعداد وكيل ذكاء اصطناعي. تصبح Knowledge Base مجموعة RAG، وتصبح تكاملات API أدوات يمكن للوكيل استدعاؤها. ما تستغني عنه هو تصنيف المقاصد وتعريفات تدفقات الحوار، التي يستبدلها LLM بالاستدلال وقت التشغيل.
هل وكلاء الذكاء الاصطناعي أغلى من الشات بوتات؟
نعم، لكل تفاعل. يتحمل وكلاء الذكاء الاصطناعي تكاليف استدلال LLM لا تتحملها الشات بوتات القائمة على القواعد. ومع ذلك، عادة ما يحل وكلاء الذكاء الاصطناعي نسبة أعلى بكثير من الطلبات من دون تدخل بشري (80%+ مقابل 40-60% للشات بوتات التقليدية)، ما يقلل تكاليف الدعم الإجمالية. تعتمد التكلفة الإجمالية للملكية على حجم محادثاتك ومزيج التعقيد.
هل يهلوس وكلاء الذكاء الاصطناعي؟
يمكن أن يحدث ذلك. قد يولد LLM ردا يبدو معقولا لكنه غير صحيح واقعيا. لهذا السبب يستخدم وكلاء الذكاء الاصطناعي في الإنتاج RAG (التوليد المعزز بالاسترجاع) لترسيخ الردود في مواد مصدر موثقة، ولهذا تكون ميزات قابلية التتبع التي تعرض أي مستندات استندت إليها كل إجابة ضرورية في عمليات النشر الإنتاجية.
هل يستطيع وكيل الذكاء الاصطناعي التعامل مع مهام لا يستطيع الشات بوت التعامل معها؟
نعم، وتحديدا المهام التي تتطلب الاستدلال عبر عدة مصادر بيانات، والتنفيذ متعدد الخطوات، والتعامل مع طلبات جديدة لا يغطيها مقصد محدد مسبقا، وتكييف السلوك بناء على سياق المحادثة. لا يستطيع الشات بوت إلا التعامل مع المهام التي توقعها مصمموه صراحة وبنوا لها تدفقات.
ماذا عن زمن الاستجابة؟
ترد الشات بوتات خلال أجزاء من الثانية لأنها تنفذ عملية بحث. عادة ما يرد وكلاء الذكاء الاصطناعي خلال 1-5 ثوان حسب عدد خطوات الاستدلال واستدعاءات الأدوات المطلوبة. في معظم حالات استخدام دعم العملاء والمبيعات، يكون زمن الاستجابة هذا مقبولا. في التطبيقات الفورية التي تكون فيها الردود دون الثانية إلزامية، قد يكون الشات بوت أو طبقة ردود مخزنة مؤقتا ضروريا.
هل “وكيل الذكاء الاصطناعي” مجرد إعادة تسمية تسويقية لـ “الشات بوت”؟
لا. الفرق بنيوي. يتبع الشات بوت نصا محددا مسبقا. أما وكيل الذكاء الاصطناعي فيستدل بشأن المهمة وقت التشغيل ويقرر ما يجب فعله. يشبه هذا الفرق بين برنامج if/else مبرمج بشكل صلب ونظام يستخدم نموذج تعلم آلي لاتخاذ القرارات. قد يبدوان متشابهين من الخارج (كلاهما يجري محادثات نصية)، لكن الآليات الداخلية والقدرات مختلفة.