


Si vous évaluez l’IA conversationnelle pour le support, la vente ou des outils internes, vous avez sans doute remarqué que les fournisseurs donnent des sens très différents aux termes « chatbot » et « agent IA ». Certains produits présentés comme des agents sont de simples interfaces de modèle de langage sans outils. Certains chatbots prennent davantage de décisions autonomes que des systèmes appelés agents.
Un chatbot est une interface conversationnelle. Un agent IA est une manière de piloter le travail effectué derrière cette interface. Un chatbot à flux programmé peut appeler des API et conserver un état. Un agent peut choisir son étape suivante parmi les outils autorisés, mais cela ne prouve ni l’identité de l’utilisateur, ni son droit d’écriture, ni la réussite d’une tâche. Cet article compare trois architectures et illustre ces limites par une demande de retour hypothétique.
Note sur la terminologie
Le secteur n’a pas adopté de définitions uniformes. Cet article utilise donc trois catégories de travail, sans prendre les étiquettes commerciales pour des spécifications :
-
Chatbot à règles : La classification d’intentions, l’extraction d’entités et les dialogues programmés choisissent l’étape suivante. Les réponses utilisent des modèles de texte plutôt qu’un LLM. Le flux peut conserver un état, appeler des API et imposer des approbations.
-
Chatbot LLM limité aux réponses : Un modèle de langage répond à partir du contexte fourni, souvent extrait d’une base de connaissances. Dans l’exemple de cet article, il ne possède aucun outil d’action. D’autres produits appelés chatbots ou copilotes peuvent disposer d’outils, de plusieurs appels au modèle et d’approbations humaines.
-
Agent IA : Un LLM sélectionne des étapes et des outils dans une boucle configurée, puis utilise les observations pour décider de la suite. Mémoire, permissions, conditions d’arrêt et revue humaine dépendent de l’implémentation. L’autonomie reste limitée par les outils et les droits réellement fournis par le système.
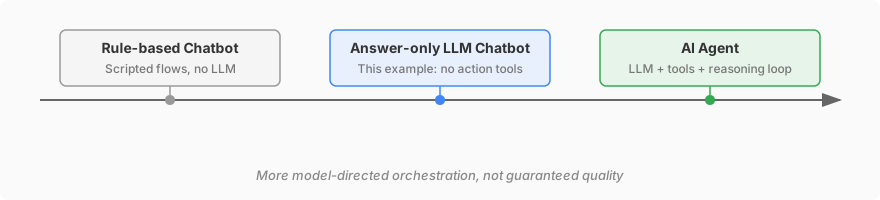 Ces exemples sont schématiques. Une orchestration davantage pilotée par le modèle ne garantit ni une meilleure exactitude, ni un coût inférieur, ni l’achèvement d’une opération métier.
Une distinction architecturale utile concerne le choix de l’étape suivante : logique applicative prédéfinie ou modèle. Le guide d’Anthropic sur les workflows et les agents emploie cette distinction et recommande de commencer par la solution la plus simple qui répond au besoin. Les systèmes hybrides peuvent combiner les deux.
Imaginons un client disant : « J’ai reçu le mauvais article. Quelle est votre politique de retour, et pouvez-vous lancer un retour ? » Voici un exemple de conception hypothétique, et non une exécution enregistrée de Quickchat AI ou un processus de remboursement intégré.
| Étape | Travail autorisé | Preuve nécessaire avant d’annoncer une réussite |
|---|---|---|
| Répondre sur la politique | Récupérer la politique publiée sans exposer les données privées de commande | La source applicable ; une réponse ne démontre pas l’éligibilité de cette commande |
| Lire la commande | Utiliser un contexte client authentifié et une API imposant l’accès à la commande correspondante | Une réponse autorisée contenant les champs nécessaires ; un e-mail ou numéro de commande saisi dans le chat n’authentifie pas le client |
| Demander un retour | Vérifier séparément le droit d’écriture, les conditions de la politique et toute confirmation client requise | Un résultat confirmé du système de retours, comme l’identifiant d’une demande acceptée ; cela ne signifie ni remboursement versé ni retour achevé |
| Transférer une exception | S’arrêter si les droits manquent, si l’exception n’est pas prise en charge ou si le résultat d’une écriture est incertain | Une demande de transfert enregistrée avec son destinataire ou sa file connus ; aucune promesse qu’une personne a déjà répondu |
Un workflow déterministe peut mettre en œuvre ces quatre étapes. Un système limité aux réponses peut expliquer la politique et orienter le client vers un service authentifié. Un agent peut choisir parmi les étapes configurées, tout en respectant les mêmes exigences d’accès et de preuve.
Qu’est-ce qu’un chatbot à règles ?
Un chatbot à règles mène des conversations écrites ou vocales à partir d’une logique prédéfinie. Il combine classification d’intentions, extraction d’entités et flux de dialogue programmés.
Fonctionnement des chatbots à règles
Une architecture classique comporte trois composants :
-
Compréhension du langage naturel (NLU) : Analyse le message pour identifier l’intention et extraire des entités, comme une date, un produit ou un numéro de commande. De nombreux systèmes NLU combinent expressions régulières, mots-clés et classificateurs entraînés.
-
Gestionnaire de dialogue : Une machine à états détermine l’étape suivante selon l’état courant de la conversation et l’intention reconnue. Chaque état possède des transitions possibles ; le gestionnaire suit le flux défini.
-
Générateur de réponses : Récupère un texte modèle associé à l’état courant. Dans un chatbot simple, il s’agit d’une table de correspondance. Des versions plus élaborées remplissent les champs du modèle avec les entités extraites.
Après authentification du client et vérification de son accès à la commande par le service, un flux hypothétique simplifié serait :
Utilisateur : « Quel est le statut de la commande #12345 ? »
  → NLU : intent=order_status, entity={order_id: 12345}
  → Gestionnaire de dialogue : state=check_order → appel autorisé order_status_api(12345)
  → Réponse : « La commande #12345 a été expédiée le 7 avril et est attendue le 11 avril. »
Voici l’architecture :

Cette approche convient aux problèmes à domaine fermé, dont les intentions possibles sont peu nombreuses et bien définies. Un bot de FAQ, une prise de rendez-vous ou une consultation de commande peuvent être construits ainsi.
Limites de l’architecture à règles
Une machine à états doit gérer explicitement les chemins qu’elle prend en charge. Ses limites pratiques dépendent du classificateur, du workflow et de la couverture des intégrations :
-
Couverture des intentions : Une demande doit correspondre à une intention prise en charge ou à un repli. Une formulation inhabituelle peut être mal classée, même si un classificateur entraîné peut généraliser au-delà des phrases exactes. Les intentions qui se recoupent demandent évaluation et entretien.
-
Branches prédéfinies : Le gestionnaire peut combiner des informations stockées sur plusieurs tours et choisir une branche en conséquence. De nouveaux types de décision nécessitent des règles ou un autre composant ; le graphe n’invente pas un workflow à l’exécution.
-
Extraction d’entités fragile : Le remplissage traditionnel de champs fonctionne pour les entrées structurées, comme les dates, nombres et SKU, mais rencontre des difficultés avec les descriptions ouvertes, références ambiguës et demandes multiples.
-
Entretien du workflow : De nouveaux usages peuvent nécessiter des intentions, branches, modèles ou intégrations supplémentaires. Les composants réutilisables aident, mais il faut mesurer l’effort d’entretien plutôt que supposer une progression fixe.
Pour approfondir l’évolution de ces architectures, consultez Des chatbots NLP à l’IA générative.
Qu’est-ce qu’un agent IA ?
Ici, un agent IA désigne un système où un LLM choisit l’étape ou l’outil suivant selon la tâche et les observations. Il peut s’inscrire dans un workflow programmé plus large. La mémoire persistante et le droit de modifier des systèmes externes sont des capacités optionnelles, pas des conséquences du nom.
Le terme « agent » a aussi une histoire plus large dans la recherche : un système perçoit son environnement et agit vers un objectif. Cet article traite de l’orchestration par LLM, où observation, planification, exécution d’outils et évaluation peuvent se répéter jusqu’à une condition d’arrêt.
Fonctionnement des agents IA
L’architecture centrale est une boucle de raisonnement, parfois appelée boucle ReAct d’après l’article ReAct qui a formalisé ce schéma. Elle comporte quatre phases :
-
Observer : L’agent reçoit le message avec l’historique, les instructions système et le contexte récupéré, par exemple des articles pertinents de la base de connaissances.
-
Raisonner : Le LLM utilise le contexte disponible pour choisir une réponse, une clarification ou un appel d’outil. Contrairement à une transition fixe du graphe, ce choix intervient à l’exécution. Il peut être erroné et doit être évalué.
-
Agir : Le modèle propose un appel structuré, comme
search_knowledge_base(query="return policy")oucreate_return_request(order_id=12345). Les contrôles applicatifs et l’API cible doivent imposer l’opération et le périmètre autorisés avant l’exécution. Proposer un appel ne constitue pas une autorisation. -
Évaluer : Le système examine le résultat et décide de continuer, répondre ou s’arrêter pour une revue humaine. L’estimation du modèle selon laquelle il a terminé ne prouve pas indépendamment la réussite d’une opération métier. Borner la boucle et vérifier l’état externe reste nécessaire selon le cas.

Le même scénario de retour peut être présenté comme un flux de contrôle proposé. Aucun appel ci-dessous n’a été exécuté et aucun résultat n’a été observé. Les noms d’opérations sont illustratifs, pas une configuration Quickchat AI à coller dans un compte.
Client : « J'ai reçu le mauvais article. Pouvez-vous lancer un retour ? »

[Politique] Récupérer la politique applicable et citer ses conditions.
[Lecture]   Exiger un contexte client authentifié et l'accès à cette commande.
            Consulter la commande correspondante via le service autorisé.
            Traiter « mauvais article reçu » comme le récit du client avant vérification.
[Contrôle]  Vérifier politique, droit d'écriture et confirmation requise.
            Si une condition manque, demander une précision ou transférer.
[Écriture]  Soumettre la demande seulement après le contrôle d'écriture distinct.
[Vérification] Annoncer l'acceptation uniquement si le résultat externe la confirme.
            Une demande acceptée ne signifie pas qu'un remboursement a été versé.
            Si le résultat est incertain, vérifier l'état ou transférer, sans réessai aveugle.
[Transfert] Consigner les faits non résolus et la file ou le destinataire connus.
            Ne pas affirmer qu'une personne a déjà répondu.
La partie agentique consiste à choisir l’étape suivante autorisée à partir du contexte. Le service a toujours besoin d’outils définis, de règles métier, de contrôles d’identité et de gestion des erreurs. Un workflow fixe pourrait réaliser les mêmes opérations ; l’architecture change l’orchestration, pas les droits du client.
Utilisation d’outils et appels de fonctions
L’utilisation d’outils, ou appel de fonctions, relie un modèle à la recherche d’information ou à des opérations externes. Le LLM reçoit des schémas avec les noms, types et descriptions de paramètres. Il peut proposer un appel parmi les outils disponibles ; l’application décide s’il est autorisé et comment son résultat est exposé.
Les catégories courantes pour les agents en contact avec les clients comprennent :
| Catégorie | Exemples |
|---|---|
| Recherche de connaissances | Rechercher dans la base, consulter une FAQ ou la documentation produit |
| Consultation de données | Vérifier une commande, récupérer des données de compte ou consulter le stock |
| Écritures | Créer une demande de retour ou un ticket, modifier un champ client autorisé ; chaque opération exige ses propres droits |
| Communication | Envoyer un e-mail, déclencher un SMS ou publier sur Slack |
| Escalade | Demander une revue humaine avec le contexte pertinent et une file ou un destinataire connus |
Un schéma décrit la forme de l’appel ; il n’authentifie pas un client et n’applique pas la politique métier. Validez paramètres et accès à destination, limitez les champs exposés et distinguez lecture et changement d’état. Les instructions du prompt ne suffisent pas à établir une frontière de sécurité.
Le tutoriel pour construire un agent IA qui effectue des actions réelles explique une requête HTTP décrite et appelée pendant la conversation. Sa suite sur l’ordonnancement des Actions avec conditions et résultats enregistrés présente Run only when et Save to memory. Ces contrôles n’établissent pas l’identité du client et ne rendent pas une écriture idempotente : métadonnées fiables et autorisation à destination restent indispensables. Ces liens conservent le contexte de leurs propres démonstrations ; le retour hypothétique présenté ici n’a pas été testé.
Mémoire et gestion du contexte
Un chatbot programmé peut stocker des champs tels que order_id=12345 et intent=order_status, ainsi que l’historique ou d’autres états. Les agents combinent souvent plusieurs contextes pour les demandes ouvertes. Aucune architecture ne fournit automatiquement une mémoire sûre entre les sessions.
Les couches de contexte utiles comprennent :
- Historique de conversation : La séquence brute des messages de la session actuelle.
- Mémoire de travail : Les résultats intermédiaires des outils et du raisonnement qui éclairent les décisions suivantes.
- Contexte récupéré : Articles, documentation ou dossiers clients obtenus par génération augmentée par récupération (RAG) pour la requête courante.
- Mémoire à long terme (optionnelle) : Informations persistantes sur l’utilisateur ou le compte, comme langue préférée, problèmes passés ou formule d’abonnement.
La fenêtre de contexte du LLM est une contrainte technique. Résumés, fenêtres glissantes et récupération sélective réduisent le volume, mais peuvent omettre des détails importants. Conservez identité, permissions et état transactionnel faisant autorité dans des systèmes fiables plutôt que dans un résumé du modèle.
Le terrain intermédiaire : chatbots LLM et copilots
Un chatbot LLM limité aux réponses peut récupérer des connaissances, les transmettre au modèle avec le message puis renvoyer la réponse. Ce schéma simple n’a pas de boucle d’action pilotée par le modèle. C’est un mode d’implémentation, pas la définition de tout chatbot ou copilote.
Pour les questions de politique, un système de récupération et de réponse peut suffire. Il peut traiter des formulations variées sans créer une intention par formulation. La qualité de récupération, les langues prises en charge et les sources doivent néanmoins être évaluées.
Dans l’exemple de retour, un système limité aux réponses explique la politique publiée, mais ne lit pas les données privées de commande et ne crée pas de demande. Ajoutez un workflow authentifié ou des outils correctement restreints si ces opérations sont requises. Une intégration programmée peut aussi les réaliser.
Des conceptions hybrides sont également possibles : un LLM classe la demande, un workflow déterministe impose les vérifications et un modèle rédige la réponse. Examinez où se prennent les décisions, quelles opérations sont permises et quelles preuves sont renvoyées, au lieu de le déduire des mots « chatbot », « copilote » ou « agent ».
Comparaison côte à côte
La colonne centrale correspond à l’exemple limité aux réponses de cet article. RAG, état persistant et accès API peuvent être combinés à d’autres architectures.
| Dimension | Chatbot à règles | Chatbot LLM limité aux réponses | Agent IA |
|---|---|---|---|
| Moteur central | Classificateur d’intentions et logique prédéfinie | LLM avec récupération et réponse | LLM sélectionnant les étapes dans une boucle contrôlée |
| Production des réponses | Modèles de texte et valeurs stockées | Génération à partir du contexte fourni | Génération à partir du contexte et des résultats d’outils disponibles |
| Dialogue | Transitions définies avec état sur plusieurs tours | Répondre ou clarifier dans le workflow configuré | Le modèle sélectionne l’étape suivante permise |
| Outils | Appels API intégrables au flux | Aucun outil d’action dans cet exemple | Le modèle propose ; l’application impose les accès |
| Tâches à plusieurs étapes | Séquence et branches explicites | Workflow supplémentaire pour les opérations externes | Sélection d’une séquence dans les limites définies |
| Demandes nouvelles | Comportement lié à la couverture du classificateur et du repli | Réponse seulement si le contexte la justifie | Peut choisir une voie utile ou prendre une mauvaise décision |
| Connaissances | Recherche configurée, API ou réponses stockées | Souvent RAG ; selon l’implémentation | Souvent RAG et outils ; selon l’implémentation |
| Entretien | Maintenir flux, textes, intégrations et tests | Maintenir sources, récupération et évaluation | Maintenir sources, outils, politiques et évaluation |
| Coûts | Hébergement, intégrations, licences et travail humain | Usage de plateforme ou modèle et travail humain | Usage de plateforme ou modèle, outils et travail humain |
| Défaillances | Mauvais routage, état incorrect ou erreur API | Réponse non étayée ou échec de récupération | Réponse non étayée, mauvais outil ou écriture incertaine |
| Latence | Selon le workflow et les services en aval | Selon récupération, modèle et restitution | Selon étapes sélectionnées, services et restitution |
Les chatbots à règles ont-ils encore du sens ?
Oui. Choisissez l’architecture la plus simple qui respecte les exigences de qualité, de contrôle et de délai. Un flux programmé peut suffire pour un formulaire stable, quelques réponses approuvées ou une consultation autorisée à étapes fixes. Ajouter un modèle ne supprime pas l’entretien des intégrations et politiques.
Plusieurs situations peuvent favoriser les workflows prédéfinis :
Réponses exigeant un texte approuvé. Des modèles peuvent préserver une rédaction validée. Il s’agit d’un contrôle, pas d’une preuve de conformité réglementaire ; éligibilité, mentions obligatoires, accès et obligations de revue dépendent toujours du déploiement.
Opérations simples et répétables. Une séquence connue peut éviter des appels inutiles au modèle à n’importe quel volume de trafic. Comparez les coûts réels d’hébergement, licences, API et entretien plutôt que d’imposer un seuil universel.
Intégrations existantes fonctionnelles. Gardez les workflows fiables et ajoutez compréhension du langage ou outils choisis lorsqu’une évaluation démontre une amélioration utile. Remplacer toutes les intentions et tous les flux n’est pas nécessaire pour utiliser un LLM.
Une conception agentique mérite une évaluation lorsque les étapes varient et que leur sélection par le modèle apporte de la valeur. Vérifiez-la sur des tâches représentatives et des défaillances ; le nom de l’architecture ne fournit aucun taux de réussite par défaut.
Là où les agents IA sont les plus efficaces
L’orchestration pilotée par le modèle mérite une évaluation lorsque les demandes varient suffisamment pour que le choix des étapes à l’exécution soit utile. Voici des usages possibles, pas des supériorités mesurées :
Support traversant plusieurs systèmes. L’exemple de retour combine récupération de politique, lecture autorisée de commande et demande autorisée séparément. Le modèle peut aider à choisir l’étape pertinente, tandis qu’un workflow fixe reste valable.
Questions produit ouvertes. Une question sur taille d’équipe, accès aux canaux et limites de formule peut demander plusieurs faits documentés. La récupération peut aider un chatbot limité aux réponses comme un agent. Aucun ne doit déduire une conformité juridique ou des droits non documentés d’une description produit.
Conversations commerciales. Un modèle peut recueillir les besoins exprimés et consulter le contexte CRM permis. Comparez exactitude des recommandations, consentement et résultats utiles au processus existant avant de revendiquer une meilleure efficacité.
Support multilingue. Les modèles de langage peuvent réduire la rédaction séparée de réponses, mais langues prises en charge et qualité varient. Évaluez terminologie, ton, fidélité aux politiques et escalade dans chaque langue cible. Une boucle agentique n’est pas nécessaire pour répondre en plusieurs langues et ne supprime pas la localisation.
Décisions d’escalade. Règles configurées et jugements du modèle peuvent aider à détecter des connaissances manquantes ou une demande de contact humain. La confiance du modèle ou le sentiment ne prouvent pas la justesse de la décision. Vérifiez séparément la demande de transfert, l’organisation de l’équipe et la réponse IA.
Pour les composants des plateformes, consultez le Guide des plateformes d’IA conversationnelle.
Fonctionnement des agents IA en production
Les systèmes en production associent comportement du modèle et contrôles applicatifs. Des contrôles similaires peuvent aussi servir aux workflows programmés ; ils ne sont pas propres aux agents.
Garde-fous et règles de comportement. Les instructions définissent périmètre, ton et escalade. Les contrôles applicatifs limitent opérations et conditions d’arrêt. Testez refus et erreurs autant que demandes attendues ; un prompt ne garantit pas le respect systématique des politiques.
Ancrage documentaire (RAG). La récupération fournit des sources avant génération et peut réduire les réponses non étayées. Elle ne garantit pas l’exactitude factuelle. Examinez source et affirmation avec les moyens de traçabilité réellement exposés. Voir Que sont les hallucinations de l’IA ? pour approfondir.
Accès aux outils et droits d’action. Les API ou serveurs MCP peuvent proposer lectures et écritures. Limitez identifiants et opérations autorisées, contrôlez l’accès client à destination et traitez le texte retourné comme des données. Un outil configuré ou des paramètres proposés ne donnent pas de droits sur la commande d’un autre client ou un remboursement non approuvé.
Quickchat AI Agents permet des réponses issues de la Knowledge Base et des API et MCP Actions configurées. Les API Actions peuvent utiliser des conditions Run only when vérifiées hors du modèle ; utilisez des métadonnées fiables et conservez l’autorisation de l’API cible. Human Handoff suspend les réponses IA et place la conversation dans Inbox, assignée si le routage choisit un membre ou non assignée sinon. L’assignation ne garantit pas une réponse humaine immédiate. Le retour décrit plus haut exige services externes et configuration adaptés ; ce n’est pas une promesse de traitement natif des retours ou remboursements.
Compromis de coût et de performance
Le choix entre chatbot et agent IA est à la fois architectural et économique.
Économie des chatbots
Un workflow programmé peut éviter l’inférence LLM, mais son coût marginal n’est pas nécessairement nul. Incluez hébergement, licences, API en aval, surveillance et traitement humain. Une consultation simple peut être peu coûteuse avec les deux architectures ; mesurez le déploiement réel.
L’entretien comprend flux, textes, intégrations et couverture de tests. Les systèmes agentiques ajoutent prompts, récupération, outils et évaluation. Estimez les deux sur le même périmètre et la même période, sans supposer que l’un demande moins d’entretien.
Économie des agents IA
L’inférence et les outils consomment des ressources, mais une plateforme peut facturer crédits, conversations, résolutions, sièges ou abonnement. Le coût sous-jacent en tokens n’est pas forcément l’unité facturée au client.
Comparez directement les conditions actuelles : les tarifs Quickchat AI, Intercom et Salesforce Agentforce utilisent des unités et conditions propres à chaque produit. Vérifiez forfait de base, engagement minimum, usage inclus, dépassements et définition du résultat facturable. Une conversation et une résolution vérifiée ne sont pas interchangeables. Le guide des modèles de tarification des agents IA explique comment comparer les périmètres sans assimiler les tarifs annoncés.
Utilisez votre propre cohorte de demandes éligibles pour estimer le coût par résultat vérifié. Incluez tentatives échouées, contacts répétés, reprises humaines, dépenses récurrentes et mise en place initiale. Le coût du support humain dépend aussi du canal et du périmètre comptable ; une moyenne sectorielle large n’est pas une référence équivalente. Le temps libéré est une capacité, pas une économie de trésorerie, sauf si une dépense réelle diminue ou si une dépense prévue est évitée.
Pour un calcul sur une même période, consultez Comment calculer le ROI d’un chatbot. Aucun avantage de résolution ou pourcentage d’économie n’est présumé ici. Mesurez le délai jusqu’à la première réponse utile et jusqu’à l’achèvement vérifié, services en aval et transfert compris ; aucune architecture n’a une plage universelle de latence.
Mesurer le succès différemment
Comparez les architectures avec des critères de résultat communs, puis ajoutez des diagnostics propres à leurs défaillances.
Les diagnostics de workflow incluent intentions reconnues, raisons du repli, transitions, erreurs API et réalisation des étapes requises. Un flux terminé ne signifie pas nécessairement un problème client résolu.
Les mesures de résultat incluent résolution vérifiée parmi les demandes éligibles, contacts répétés, reprises humaines, satisfaction client accompagnée du nombre de réponses à l’enquête et coût par résultat vérifié. Pour un agent, examinez aussi affirmations non étayées, choix d’outils, refus d’accès et écritures incertaines. Ne comptez pas une réponse générée, une demande de retour acceptée et un remboursement achevé comme le même résultat.
Le guide d’analyse des chatbots distingue observations natives du produit et mesures nécessitant une preuve externe, avec une feuille de travail synthétique. Définissez dénominateur et fenêtre d’observation avant comparaison ; la feuille n’est pas un benchmark.
Conservez assez de preuves pour auditer séparément réponse de politique, consultation autorisée, modification externe et transfert. Sources récupérées, réponses d’outils et état faisant autorité remplissent des fonctions différentes. Évaluez avec des dossiers synthétiques ou correctement protégés et n’exposez pas de données clients privées dans les exemples partagés.
FAQ
Puis-je convertir mon chatbot existant en agent IA ?
Vous pouvez souvent ajouter progressivement compréhension du langage ou outils choisis en conservant workflows, connaissances et intégrations utiles. Le choix des outils par le modèle est un changement architectural à évaluer. Conservez autorisation, approbations requises et étapes déterministes fiables, au lieu de les supprimer pour adopter le nom d’agent.
Les agents IA sont-ils plus chers que les chatbots ?
Il n’existe pas de réponse universelle. Comparez abonnements, unités facturées, usage, mise en place, entretien et reprises humaines pour les mêmes tâches éligibles et la même période. Les appels au modèle consomment des ressources, mais les tarifs clients varient. Il faut mesurer les gains de résolution et de trésorerie ; le temps libéré n’est pas automatiquement de l’argent économisé.
Les agents IA hallucinent-ils ?
Oui. La récupération peut fournir des sources pertinentes sans garantir une réponse correcte. Vérifiez que les affirmations découlent des sources et qu’un résultat d’outil confirme réellement l’issue annoncée. Appliquez la même exigence aux chatbots LLM limités aux réponses et transférez lorsque les preuves sont insuffisantes.
Un agent IA peut-il gérer des tâches qu’un chatbot ne peut pas gérer ?
Un agent peut choisir des étapes utiles pour des demandes variées qu’un workflow existant ne couvre pas. Les chatbots programmés peuvent aussi appeler des API, conserver un état et exécuter plusieurs étapes. La capacité réelle dépend des intégrations, permissions, politiques et preuves, pas du nom de l’interface. Une demande de retour exige toujours un droit d’écriture distinct.
Qu’en est-il de la latence ?
Mesurez le délai jusqu’à la première réponse utile et jusqu’à l’achèvement vérifié sur des tâches représentatives, y compris les appels lents ou échoués en aval. Comparez des distributions comme médiane et 95e percentile à vos exigences. Plus d’étapes de modèle ou d’outil peuvent ajouter du délai, mais aucun nom n’impose un temps universel ni ne rend ce délai acceptable.
« Agent IA » est-il simplement un nouveau nom marketing pour « chatbot » ?
Les termes se recoupent. Un chatbot décrit une interface, tandis que l’orchestration agentique désigne généralement le choix d’étapes ou d’outils par un modèle à l’exécution. Examinez workflow réel, contrôles d’autorité, conditions d’arrêt et preuves de résultat. Le nom du produit ne démontre pas davantage d’autonomie, d’exactitude ou de valeur métier.