

Wenn du Conversational AI für Support, Vertrieb oder interne Werkzeuge bewertest, ist dir wahrscheinlich aufgefallen, dass Anbieter mit „Chatbot“ und „KI-Agent“ sehr unterschiedliche Dinge meinen. Manche als „KI-Agent“ bezeichneten Produkte sind dünne Hüllen um ein Sprachmodell ohne Tool-Zugriff. Manche „Chatbots“ entscheiden autonomer als Systeme, die sich Agenten nennen.
Ein Chatbot ist eine Konversationsoberfläche. Ein KI-Agent ist eine mögliche Steuerung der Arbeit dahinter. Ein skriptbasierter Chatbot kann APIs aufrufen und Zustände speichern. Ein Agent kann seinen nächsten Schritt aus erlaubten Tools auswählen. Das bestätigt aber weder die Identität des Nutzers noch die Berechtigung für einen Schreibzugriff oder den Erfolg einer Aufgabe. Dieser Beitrag vergleicht drei Arbeitsarchitekturen und verdeutlicht diese Grenzen an einer hypothetischen Rückgabeanfrage.
Eine Anmerkung zur Terminologie
Die Branche verwendet keine einheitlichen Definitionen. Deshalb dienen hier drei Arbeitskategorien zur Erklärung, ohne Produktbezeichnungen als Spezifikationen zu behandeln:
-
Regelbasierter Chatbot: Intent-Klassifikation, Entitätsextraktion und skriptbasierte Dialogabläufe wählen den nächsten Schritt. Antworten stammen aus Vorlagen statt aus einem LLM. Der Ablauf kann Zustände speichern, APIs aufrufen und Freigaben erzwingen.
-
Nur antwortender LLM-Chatbot: Ein Sprachmodell beantwortet Fragen anhand bereitgestellten Kontexts, oft aus einer Wissensdatenbank. Im Beispiel dieses Beitrags besitzt es keine Aktions-Tools. Andere als Chatbots oder Copilots bezeichnete Produkte können Tools, mehrere Modellaufrufe und menschliche Freigaben enthalten.
-
KI-Agent: Ein LLM wählt Schritte und Tools innerhalb einer konfigurierten Schleife aus und entscheidet anhand von Beobachtungen über das weitere Vorgehen. Gedächtnis, Berechtigungen, Abbruchbedingungen und menschliche Prüfung hängen von der Implementierung ab. Die Autonomie endet bei den tatsächlich verfügbaren Tools und Befugnissen.
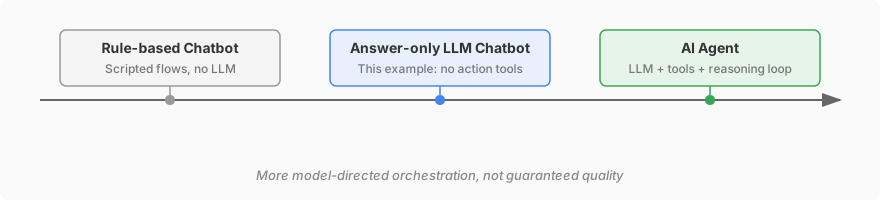 Dies sind schematische Beispiele. Mehr modellgesteuerte Orchestrierung garantiert weder höhere Genauigkeit noch geringere Kosten oder einen abgeschlossenen Geschäftsvorgang.
Eine nützliche architektonische Unterscheidung ist, wer den nächsten Schritt auswählt: vordefinierte Anwendungslogik oder das Modell. Anthropics Leitfaden zu Workflows und Agenten verwendet diese Unterscheidung und empfiehlt, mit der einfachsten ausreichenden Lösung zu beginnen. Hybride Systeme können beides kombinieren.
Ein Kunde sagt beispielsweise: „Ich habe den falschen Artikel erhalten. Welche Rückgaberegeln gelten, und kannst du eine Rückgabe anstoßen?“ Das Folgende ist ein hypothetisches Entwurfsbeispiel, kein aufgezeichneter Quickchat AI-Durchlauf und kein integrierter Erstattungsablauf.
| Phase | Erlaubte Arbeit | Erforderlicher Nachweis vor einer Erfolgsmeldung |
|---|---|---|
| Richtlinienfrage beantworten | Veröffentlichte Richtlinie abrufen, ohne private Bestelldaten offenzulegen | Die einschlägige Richtlinienquelle; eine Antwort belegt nicht die Rückgabeberechtigung dieser Bestellung |
| Bestellung lesen | Authentifizierten Kundenkontext und eine API nutzen, die den Zugriff auf die zugehörige Bestellung durchsetzt | Eine autorisierte Antwort mit den nötigen Bestellfeldern; eine im Chat eingegebene E-Mail-Adresse oder Bestellnummer ist keine Authentifizierung |
| Rückgabe beantragen | Schreibberechtigung, Richtlinienbedingungen und gegebenenfalls erforderliche Kundenbestätigung gesondert prüfen | Ein bestätigtes Ergebnis des Rückgabesystems, etwa die Kennung eines angenommenen Antrags; das ist keine ausgezahlte Erstattung oder abgeschlossene Rückgabe |
| Ausnahme übergeben | Bei fehlender Befugnis, nicht unterstützten Richtlinienausnahmen oder unklarem Schreibergebnis stoppen | Eine dokumentierte Übergabeanfrage mit bekanntem Ziel oder bekannter Warteschlange; keine Zusage, dass bereits ein Mensch geantwortet hat |
Ein deterministischer Workflow kann alle vier Phasen umsetzen. Ein nur antwortendes System kann die Richtlinie erklären und auf einen authentifizierten Dienst verweisen. Ein Agent kann zwischen konfigurierten Schritten wählen, muss aber dieselben Zugriffs- und Nachweisanforderungen erfüllen.
Was ist ein regelbasierter Chatbot?
Ein regelbasierter Chatbot führt Text- oder Sprachgespräche anhand vordefinierter Logik. Er kombiniert Intent-Klassifikation, Entitätsextraktion und skriptbasierte Dialogabläufe.
Wie regelbasierte Chatbots funktionieren
Eine typische Chatbot-Architektur hat drei Komponenten:
-
Natural Language Understanding (NLU): Analysiert die Nachricht, erkennt die Absicht des Nutzers und extrahiert Entitäten wie Daten, Produktnamen oder Bestellnummern. Viele NLU-Systeme kombinieren reguläre Ausdrücke, Schlüsselwortsuche und trainierte Klassifikatoren.
-
Dialogmanager: Eine Zustandsmaschine bestimmt den nächsten Schritt anhand des Gesprächszustands und der erkannten Absicht. Jeder Zustand hat mögliche Übergänge; der Dialogmanager folgt dem definierten Ablauf.
-
Antwortgenerator: Ruft eine zum aktuellen Zustand gehörende Antwortvorlage ab. In einfachen Chatbots ist das eine Nachschlagetabelle. Komplexere Vorlagen enthalten Felder, die mit extrahierten Entitäten gefüllt werden.
Ein vereinfachter hypothetischer Ablauf sieht nach Authentifizierung des Kunden und Prüfung des Bestellzugriffs durch den Dienst so aus:
Nutzer: „Wie ist der Status der Bestellung #12345?“
  → NLU: intent=order_status, entity={order_id: 12345}
  → Dialogmanager: state=check_order → autorisierter Aufruf order_status_api(12345)
  → Antwort: „Bestellung #12345 wurde am 7. April versendet und wird am 11. April erwartet.“
Die Architektur sieht so aus:

Das eignet sich für abgegrenzte Aufgaben, deren mögliche Absichten überschaubar und klar definiert sind. Ein FAQ-Bot, eine Terminbuchung oder eine Bestellstatusabfrage lassen sich so umsetzen.
Grenzen der regelbasierten Architektur
Eine Zustandsmaschine benötigt ausdrückliche Regeln für die unterstützten Pfade. Ihre praktischen Grenzen hängen vom Klassifikator, dem Workflow-Entwurf und den Integrationen ab:
-
Intent-Abdeckung: Anfragen müssen einer unterstützten Absicht oder einem Fallback zugeordnet werden. Ungewohnte Formulierungen können falsch klassifiziert werden, obwohl trainierte Klassifikatoren über exakte Formulierungen hinaus verallgemeinern können. Überschneidende Absichten erfordern Evaluation und Pflege.
-
Vordefinierte Verzweigungen: Der Dialogmanager kann gespeicherte Informationen aus mehreren Gesprächsschritten kombinieren und darauf verzweigen. Neue Entscheidungstypen benötigen weiterhin Regeln oder eine andere Entscheidungskomponente; der Graph erfindet zur Laufzeit keinen neuen Workflow.
-
Anfällige Entitätsextraktion: Traditionelles Slot-Filling funktioniert für strukturierte Eingaben wie Daten, Zahlen oder Produkt-SKUs, hat aber Schwierigkeiten mit offenen Beschreibungen, mehrdeutigen Bezügen oder mehrteiligen Anfragen.
-
Workflow-Pflege: Neue Anwendungsfälle können zusätzliche Intents, Verzweigungen, Vorlagen oder Integrationen erfordern. Wiederverwendbare Komponenten helfen, doch der Wartungsaufwand muss gemessen werden, statt ein festes Wachstum anzunehmen.
Weitere technische Hintergründe bietet Von NLP-Chatbots zu generativer KI.
Was ist ein KI-Agent?
Hier bezeichnet KI-Agent ein System, in dem ein LLM anhand der Aufgabe und seiner Beobachtungen den nächsten Schritt oder das nächste Tool auswählt. Es kann Teil eines übergeordneten skriptbasierten Workflows sein. Dauerhaftes Gedächtnis und die Erlaubnis, externe Systeme zu verändern, sind optionale Fähigkeiten und keine Folgen der Bezeichnung.
Der Begriff „Agent“ hat in der KI-Forschung eine breitere Geschichte: Ein System nimmt seine Umgebung wahr und handelt auf ein Ziel hin. Dieser Beitrag konzentriert sich auf LLM-basierte Orchestrierung, bei der Beobachtung, Planung, Tool-Ausführung und Bewertung bis zu einer Abbruchbedingung wiederholt werden können.
Wie KI-Agenten funktionieren
Das Kernmuster ist eine Reasoning-Schleife, auch ReAct-Schleife genannt, nach dem ReAct-Paper, das dieses Muster formalisierte. Die Schleife hat vier Phasen:
-
Beobachten: Der Agent erhält die Nutzernachricht zusammen mit Gesprächsverlauf, Systemanweisungen und abgerufenem Kontext, etwa relevanten Wissensartikeln.
-
Schlussfolgern: Das LLM wählt anhand des verfügbaren Kontexts eine Antwort, Rückfrage oder einen Tool-Aufruf. Anders als ein fester Übergang im Zustandsgraphen erfolgt diese Auswahl zur Laufzeit. Sie kann falsch sein und muss evaluiert werden.
-
Handeln: Das Modell schlägt einen strukturierten Aufruf vor, etwa
search_knowledge_base(query="return policy")odercreate_return_request(order_id=12345). Anwendungskontrollen und Ziel-API müssen vor der Ausführung die zulässige Operation und ihren Umfang durchsetzen. Ein vorgeschlagener Aufruf ist keine Autorisierung. -
Bewerten: Das System prüft das Ergebnis und entscheidet, ob es fortfährt, antwortet oder für eine menschliche Prüfung stoppt. Die Einschätzung des Modells, fertig zu sein, ist kein unabhängiger Erfolgsnachweis für einen Geschäftsvorgang. Begrenze die Schleife und prüfe bei Bedarf den externen Zustand.

Dasselbe Rückgabeszenario lässt sich als vorgeschlagener Kontrollfluss beschreiben. Keiner der folgenden Aufrufe wurde ausgeführt und keines der Ergebnisse beobachtet. Die Operationsnamen dienen der Veranschaulichung und sind keine Quickchat AI-Konfiguration zum Einfügen in ein Konto.
Kunde: „Ich habe den falschen Artikel erhalten. Kannst du eine Rückgabe anstoßen?“

[Richtlinie] Geltende Rückgaberichtlinie abrufen und ihre Bedingungen nennen.
[Lesen]      Authentifizierten Kundenkontext und Zugriff auf diese Bestellung verlangen.
             Zugehörige Bestellung über den autorisierten Dienst nachschlagen.
             „Falscher Artikel erhalten“ bis zur Prüfung als Kundenbericht behandeln.
[Prüfung]    Rückgaberichtlinie, Schreibbefugnis und nötige Bestätigung prüfen.
             Fehlt eine Bedingung, nachfragen oder an einen Menschen übergeben.
[Schreiben]  Rückgabeantrag erst nach bestandener gesonderter Schreibprüfung senden.
[Kontrolle]  Annahme nur melden, wenn das externe Ergebnis sie bestätigt.
             Ein angenommener Antrag bedeutet nicht, dass eine Erstattung ausgezahlt wurde.
             Bei unklarem Ergebnis Zustand prüfen oder übergeben, nicht blind wiederholen.
[Übergabe]   Offene Tatsachen und bekannte Warteschlange oder Empfänger dokumentieren.
             Nicht behaupten, dass ein Mensch bereits geantwortet hat.
Der agentische Teil besteht darin, anhand des Kontexts den nächsten erlaubten Schritt auszuwählen. Der Dienst benötigt trotzdem definierte Tools, Richtlinienregeln, Identitätsprüfungen und Fehlerbehandlung. Ein fester Workflow könnte dieselben Operationen ausführen; die Architektur verändert die Orchestrierung, nicht die Befugnisse des Kunden.
Tool-Nutzung und Function Calling
Tool-Nutzung oder Function Calling verbindet ein Modell mit Informationsabruf oder externen Operationen. Das LLM erhält Tool-Schemas mit Parameternamen, Typen und Beschreibungen. Es kann einen Aufruf aus dem verfügbaren Satz vorschlagen; die Anwendung entscheidet über Zulässigkeit und Offenlegung des Ergebnisses.
Typische Tool-Kategorien für kundenorientierte Agenten sind:
| Kategorie | Beispiele |
|---|---|
| Wissensabruf | Wissensdatenbank durchsuchen, FAQ nachschlagen, Produktdokumentation abrufen |
| Datenabfrage | Bestellstatus prüfen, Kontodetails abrufen, Bestand abfragen |
| Schreiboperationen | Rückgabeantrag oder Ticket erstellen, ein erlaubtes Kundenfeld aktualisieren; jede Operation benötigt eigene Befugnisse |
| Kommunikation | E-Mail senden, SMS auslösen, in Slack posten |
| Eskalation | Menschliche Prüfung mit relevantem Kontext und bekannter Warteschlange oder bekanntem Empfänger anfordern |
Ein Schema beschreibt die Form des Aufrufs. Es authentifiziert keinen Kunden und setzt keine Geschäftsrichtlinie durch. Prüfe Parameter und Zugriff am Ziel, begrenze offengelegte Felder und unterscheide Lesen von Zustandsänderungen. Prompt-Anweisungen allein sind keine Sicherheitsgrenze.
Die Anleitung zum Bauen eines KI-Agenten mit echten Aktionen erklärt einen beschriebenen HTTP-Aufruf während eines Gesprächs. Der Folgebeitrag zur Reihenfolge von Actions mit Ausführungsbedingungen und gespeicherten Ergebnissen zeigt Run only when und Save to memory. Diese Kontrollen stellen weder die Kundenidentität fest noch machen sie Schreibzugriffe idempotent: Vertrauenswürdige Metadaten und Autorisierung am Ziel bleiben nötig. Die verlinkten Demos behalten ihren eigenen Kontext; der hypothetische Rückgabeablauf hier wurde nicht getestet.
Gedächtnis und Kontextverwaltung
Ein skriptbasierter Chatbot kann ausgefüllte Felder wie order_id=12345 und intent=order_status sowie Gesprächsverlauf oder andere Zustände speichern. Agenten kombinieren oft verschiedene Kontextarten für offene Anfragen. Keine Architektur bietet automatisch sichere sitzungsübergreifende Erinnerung.
Nützliche Kontextebenen sind:
- Gesprächsverlauf: Die unverarbeitete Folge der Nachrichten in der aktuellen Sitzung.
- Arbeitsgedächtnis: Zwischenergebnisse aus Tool-Aufrufen und Denkschritten für spätere Entscheidungen.
- Abgerufener Kontext: Wissensartikel, Produktdokumentation oder Kundendatensätze, die per Retrieval-Augmented Generation (RAG) für die aktuelle Anfrage abgerufen werden.
- Langzeitgedächtnis (optional): Sitzungsübergreifend gespeicherte Fakten zum Nutzer oder Konto, etwa bevorzugte Sprache, frühere Anliegen oder Abonnementstufe.
Das Kontextfenster des LLM begrenzt die technische Umsetzung. Zusammenfassungen, gleitende Fenster und gezielter Abruf können den Kontext verkleinern, dabei aber wichtige Einzelheiten verlieren. Bewahre Identität, Berechtigungen und maßgeblichen Transaktionszustand in vertrauenswürdigen Systemen auf, statt dich auf eine Modellzusammenfassung zu verlassen.
Der Mittelweg: LLM-Chatbots und Copilots
Ein nur antwortender LLM-Chatbot kann relevantes Wissen abrufen, es zusammen mit der Nutzernachricht an ein Modell übergeben und dessen Antwort zurückgeben. Dieser einfache Aufbau enthält keine modellgesteuerte Aktionsschleife. Er ist ein Implementierungsmuster und keine Definition aller Chatbots oder Copilots.
Für Richtlinienfragen kann ein System aus Abruf und Antwort ausreichen. Es kann unterschiedliche Formulierungen verarbeiten, ohne für jede Variante einen eigenen Intent zu benötigen. Abrufqualität, unterstützte Sprachen und Quellenqualität müssen dennoch evaluiert werden.
Im Rückgabebeispiel erklärt ein nur antwortendes System die veröffentlichte Richtlinie, ruft aber keine privaten Bestelldaten ab und erstellt keinen Rückgabeantrag. Ergänze bei Bedarf einen authentifizierten Workflow oder entsprechend eingeschränkte Tools. Auch eine skriptbasierte Integration kann diese Operationen ausführen.
Hybride Designs sind ebenfalls möglich: Ein LLM klassifiziert die Anfrage, ein deterministischer Workflow erzwingt die erforderlichen Prüfungen, und ein Modell formuliert die Antwort. Prüfe, wo Entscheidungen getroffen werden, welche Operationen erlaubt sind und welche Nachweise zurückkommen, statt diese Eigenschaften aus „Chatbot“, „Copilot“ oder „Agent“ abzuleiten.
Vergleich nebeneinander
Die mittlere Spalte beschreibt das nur antwortende Beispiel dieses Beitrags. RAG, persistenter Zustand und API-Zugriff lassen sich auch mit anderen Architekturen kombinieren.
| Dimension | Regelbasierter Chatbot | Nur antwortender LLM-Chatbot | KI-Agent |
|---|---|---|---|
| Kern | Intent-Klassifikator und vordefinierte Logik | LLM mit Abruf-und-Antwort-Workflow | LLM wählt Schritte in einer kontrollierten Schleife |
| Antworterzeugung | Vorlagen und gespeicherte Werte | Aus bereitgestelltem Kontext erzeugt | Aus Kontext und verfügbaren Tool-Ergebnissen erzeugt |
| Gesprächsablauf | Definierte Übergänge mit Zustand über mehrere Gesprächsschritte | Antworten oder Nachfragen innerhalb des Workflows | Modell wählt den nächsten erlaubten Schritt |
| Tool-Nutzung | API-Aufrufe können im Ablauf enthalten sein | In diesem Beispiel keine Aktions-Tools | Modell schlägt Aufrufe vor; Anwendung erzwingt Zugriffskontrollen |
| Mehrstufige Aufgaben | Ausdrückliche Reihenfolge und Verzweigungen | Externe Operationen brauchen einen zusätzlichen Workflow | Kann eine Reihenfolge innerhalb der Grenzen wählen |
| Neue Anfragen | Verhalten hängt von Klassifikator und Fallback-Abdeckung ab | Nur bei ausreichendem Kontext antworten | Kann einen nützlichen Weg wählen oder falsch entscheiden |
| Wissenszugriff | Konfigurierte Suche, APIs oder gespeicherte Antworten | Oft RAG; implementierungsabhängig | Oft RAG und Tools; implementierungsabhängig |
| Wartung | Abläufe, Vorlagen, Integrationen und Tests pflegen | Quellen, Abruf und Evaluation pflegen | Quellen, Tools, Richtlinien und Evaluation pflegen |
| Kostenstruktur | Hosting, Integrationen, Lizenzen und menschliche Arbeit | Plattform- oder Modellnutzung plus menschliche Arbeit | Plattform- oder Modellnutzung, Tools und menschliche Arbeit |
| Fehlerarten | Fehlleitung, falscher Zustand oder API-Fehler | Unbelegte Antwort oder Abruffehler | Unbelegte Antwort, falsche Tool-Nutzung oder unklarer Schreibzugriff |
| Latenz | Abhängig von Workflow und nachgelagerten Diensten | Abhängig von Abruf, Modell und Auslieferung | Abhängig von gewählten Schritten, Diensten und Auslieferung |
Sind regelbasierte Chatbots noch sinnvoll?
Ja. Wähle die einfachste Architektur, die die Anforderungen an Qualität, Kontrolle und Antwortzeit erfüllt. Ein skriptbasierter Ablauf kann für ein stabiles Formular, einige freigegebene Antworten oder eine autorisierte Abfrage mit festen Schritten genügen. Ein Modell ersetzt nicht die Pflege von Integrationen und Richtlinien.
Mehrere Bedingungen können für vordefinierte Workflows sprechen:
Antworten mit vorgeschriebenem Wortlaut. Vorlagen können geprüfte Texte bewahren. Das ist eine Kontrolle, kein Nachweis regulatorischer Konformität. Berechtigung, Pflichtinformationen, Zugriff und Prüfpflichten hängen weiterhin vom Einsatz ab.
Einfache, wiederholbare Operationen. Eine bekannte Reihenfolge kann bei jedem Verkehrsvolumen unnötige Modellaufrufe vermeiden. Vergleiche tatsächliche Hosting-, Lizenz-, API- und Wartungskosten, statt eine allgemeine Volumenschwelle anzunehmen.
Bereits funktionierende Integrationen. Behalte zuverlässige Workflows und ergänze Sprachverständnis oder ausgewählte Tools dort, wo die Evaluation eine sinnvolle Verbesserung zeigt. Alle Intents und Abläufe zu ersetzen ist keine Voraussetzung für ein LLM.
Ein agentisches Design lohnt eine Evaluation, wenn die benötigten Schritte variieren und modellgesteuerte Auswahl Nutzen bringt. Prüfe das an repräsentativen Aufgaben und Fehlerfällen; die Architekturbezeichnung liefert keine vorgegebene Erfolgsquote.
Wo KI-Agenten am stärksten sind
Modellgesteuerte Orchestrierung ist dort eine Evaluation wert, wo Anfragen so unterschiedlich sind, dass die Auswahl des nächsten Schritts zur Laufzeit helfen könnte. Die folgenden Beispiele sind mögliche Einsatzgebiete, keine gemessenen Überlegenheitsbehauptungen:
Systemübergreifender Support. Das Rückgabebeispiel kombiniert Richtlinienabruf, autorisierten Bestellzugriff und einen gesondert autorisierten Antrag. Das Modell kann bei der Auswahl des nächsten relevanten Schritts helfen; ein fester Workflow bleibt eine gültige Alternative.
Offene Produktfragen. Eine Frage zu Teamgröße, Kanalzugang und Tarifgrenzen kann mehrere dokumentierte Fakten erfordern. Abruf hilft sowohl einem nur antwortenden Chatbot als auch einem Agenten. Keiner sollte aus einer Produktbeschreibung rechtliche Konformität oder undokumentierte Ansprüche ableiten.
Vertriebsgespräche. Ein Modell kann genannte Anforderungen sammeln und erlaubten CRM-Kontext abrufen. Vergleiche Empfehlungsgenauigkeit, Einwilligung und nützliche Ergebnisse mit dem bestehenden Ablauf, bevor du höhere Wirksamkeit behauptest.
Mehrsprachiger Support. Sprachmodelle können den Bedarf an separat verfassten Antworten reduzieren, doch unterstützte Sprachen und Qualität variieren. Prüfe Terminologie, Ton, Richtlinientreue und Eskalation für jede Zielsprache. Mehrsprachige Antworten benötigen keine Agentenschleife, und diese beseitigt keine Lokalisierungsarbeit.
Eskalationsentscheidungen. Konfigurierte Regeln und Modellurteile können fehlendes Wissen oder den Wunsch nach einem Menschen erkennen helfen. Modellsicherheit oder Stimmung sind kein verlässlicher Beleg für eine richtige Entscheidung. Prüfe Übergabeanfrage und Personaleinsatz getrennt von der KI-Antwort.
Hintergründe zu Plattformkomponenten findest du im Leitfaden zu Conversational-AI-Plattformen.
Wie KI-Agenten in der Produktion funktionieren
Produktionssysteme verbinden Modellverhalten mit Anwendungskontrollen. Ähnliche Kontrollen können auch skriptbasierte Workflows unterstützen; sie sind nicht exklusiv für Agenten.
Leitplanken und Verhaltensregeln. Anweisungen definieren Aufgabenbereich, Ton und Eskalationsverhalten. Anwendungsprüfungen beschränken Operationen und Abbruchbedingungen. Teste Ablehnungen und Fehler ebenso wie erwartete Anfragen. Ein Prompt garantiert nicht, dass jede Antwort der Richtlinie folgt.
Wissensbasierung (RAG). Abruf stellt vor der Generierung relevantes Quellenmaterial bereit und kann unbelegte Antworten reduzieren. Er garantiert keine sachliche Richtigkeit. Prüfe abgerufene Quelle und daraus abgeleitete Behauptung anhand der tatsächlich verfügbaren Nachvollziehbarkeit. Weitere Hintergründe stehen in Was sind KI-Halluzinationen?.
Tool-Zugriff und Aktionsberechtigungen. APIs oder MCP-Server können Lese- und Schreibzugriffe anbieten. Begrenze Zugangsdaten und erlaubte Operationen, erzwinge Kundenzugriff am Ziel und behandle zurückgegebenen Text als Daten. Ein konfiguriertes Tool oder vorgeschlagene Parameter können keinen Zugriff auf fremde Bestellungen oder eine nicht freigegebene Erstattung gewähren.
Quickchat AI Agents unterstützt Antworten aus der Knowledge Base und konfigurierte API- und MCP-Actions. API-Actions können Run only when-Bedingungen verwenden, die außerhalb des Modells geprüft werden. Nutze vertrauenswürdige Metadaten und behalte die Autorisierung der Ziel-API bei. Human Handoff pausiert KI-Antworten und legt das Gespräch in der Inbox ab, mit Zuweisung bei passendem Routing oder sonst ohne Zuweisung. Eine Zuweisung garantiert keine sofortige menschliche Antwort. Der Rückgabeablauf oben benötigt geeignete externe Dienste und Konfiguration; er verspricht keine native Abwicklung von Rückgaben oder Erstattungen.
Kosten- und Performance-Trade-offs
Die Wahl zwischen Chatbot und KI-Agent ist sowohl eine Architektur- als auch eine wirtschaftliche Entscheidung.
Chatbot-Ökonomie
Ein skriptbasierter Workflow kann LLM-Inferenz vermeiden, hat aber nicht zwingend Grenzkosten von null. Berücksichtige Hosting, Plattformlizenzen, nachgelagerte APIs, Überwachung und menschliche Bearbeitung. Eine einfache Abfrage kann mit beiden Architekturen günstig sein; miss den tatsächlichen Einsatz.
Wartung umfasst Abläufe, Vorlagen, Integrationen und Testabdeckung. Agentische Systeme bringen zusätzliche Arbeit an Prompts, Abruf, Tools und Evaluation mit. Schätze beides für denselben Aufgabenumfang und Zeitraum, statt geringeren Wartungsaufwand vorauszusetzen.
KI-Agent-Ökonomie
Modellinferenz und Tool-Ausführung verbrauchen Ressourcen, doch eine Plattform kann nach Credits, Gesprächen, Lösungen, Sitzen oder Abonnement abrechnen. Die zugrunde liegenden Token-Kosten sind nicht zwingend die Abrechnungseinheit des Kunden.
Vergleiche die aktuellen Bedingungen direkt: Quickchat AI-Preise, Intercom-Preise und Salesforce Agentforce-Preise verwenden produktspezifische Einheiten und Bedingungen. Prüfe Grundgebühr, Mindestabnahme, enthaltene Nutzung, Mehrverbrauch und Definition eines abrechenbaren Ergebnisses. Ein Gespräch und eine verifizierte Lösung sind nicht austauschbar. Der Leitfaden zu Preismodellen für KI-Agenten erklärt den Vergleich dieser Umfänge, ohne beworbene Sätze gleichzusetzen.
Nutze eine eigene Kohorte berechtigter Anfragen, um Kosten je verifiziertem Ergebnis zu schätzen. Berücksichtige fehlgeschlagene Versuche, erneute Kontakte, menschliche Nacharbeit, laufende Ausgaben und einmalige Einrichtung. Auch menschliche Supportkosten hängen von Kanal und Kostenumfang ab; ein allgemeiner Branchenwert ist keine passende Vergleichsbasis für deinen Einsatz. Freigesetzte Arbeitszeit ist Kapazität, keine Geldersparnis, solange keine tatsächlichen Kosten sinken oder geplante Ausgaben entfallen.
Für eine Berechnung über denselben Zeitraum siehe So berechnest du Chatbot-ROI. Hier wird weder ein Vorteil bei der Lösungsquote noch ein Einsparungsprozentsatz vorausgesetzt. Miss Zeit bis zur ersten nützlichen Antwort und bis zum verifizierten Abschluss einschließlich nachgelagerter Dienste und Übergabe. Keine Architektur hat eine allgemeingültige Latenzspanne.
Erfolg unterschiedlich messen
Vergleiche Architekturen anhand gemeinsamer Ergebniskriterien und ergänze Diagnosen für ihre unterschiedlichen Fehlerarten.
Workflow-Diagnosen umfassen erkannte Intents, Fallback-Gründe, Zustandsübergänge, API-Fehler und das Erfüllen vorgeschriebener Schritte. Ein abgeschlossener Ablauf bedeutet nicht unbedingt, dass das Kundenproblem gelöst ist.
Ergebniskennzahlen umfassen verifizierte Lösungen unter berechtigten Anfragen, erneute Kontakte, menschliche Nacharbeit, Zufriedenheit samt Antwortanzahl und Kosten je verifiziertem Ergebnis. Prüfe bei Agenten außerdem unbelegte Aussagen, Tool-Auswahl, Zugriffsverweigerungen und unklare Schreibvorgänge. Zähle generierte Antwort, angenommenen Rückgabeantrag und abgeschlossene Erstattung nicht als dasselbe Ergebnis.
Der Leitfaden zu Chatbot Analytics trennt native Produktbeobachtungen von Kennzahlen mit externem Nachweisbedarf und enthält ein synthetisches Arbeitsblatt. Definiere Nenner und Beobachtungsfenster vor dem Vergleich. Das Arbeitsblatt ist kein Benchmark.
Bewahre genügend Nachweise auf, um Richtlinienantwort, autorisierte Abfrage, externe Zustandsänderung und Übergabe getrennt zu prüfen. Abgerufene Quellen, Tool-Antworten und maßgeblicher Systemzustand erfüllen unterschiedliche Zwecke. Nutze synthetische oder angemessen geschützte Datensätze zur Evaluation und veröffentliche keine privaten Kundendaten in gemeinsamen Beispielen.
FAQ
Kann ich meinen bestehenden Chatbot in einen KI-Agenten umwandeln?
Oft lassen sich Sprachverständnis oder ausgewählte Tools schrittweise ergänzen und nützliche Abläufe, Wissen und Integrationen erhalten. Modellgesteuerte Tool-Auswahl ist eine Architekturänderung, die evaluiert werden muss. Behalte Autorisierung, erforderliche Freigaben und zuverlässige deterministische Schritte bei, statt sie nur wegen der Agentenbezeichnung zu verwerfen.
Sind KI-Agenten teurer als Chatbots?
Das lässt sich nicht allgemein beantworten. Vergleiche Abonnements, Abrechnungseinheiten, Nutzung, Einrichtung, Wartung und menschliche Nacharbeit für dieselben berechtigten Aufgaben und denselben Zeitraum. Modellaufrufe verbrauchen Ressourcen, doch die Kundenabrechnung variiert. Höhere Lösungsquoten und Geldersparnisse müssen gemessen werden; freigesetzte Arbeitszeit ist nicht automatisch gespartes Geld.
Halluzinieren KI-Agenten?
Ja. Abruf kann relevante Quellen liefern, garantiert aber keine richtige Antwort. Prüfe, ob Aussagen aus den Quellen folgen und ob ein Tool-Ergebnis den behaupteten Erfolg bestätigt. Prüfe nur antwortende LLM-Chatbots genauso und übergib an einen Menschen, wenn Nachweise fehlen.
Kann ein KI-Agent Aufgaben bewältigen, die ein Chatbot nicht kann?
Ein Agent kann bei unterschiedlichen Anfragen nützliche Schritte auswählen, die ein vorhandener Workflow nicht abdeckt. Skriptbasierte Chatbots können ebenfalls APIs aufrufen, Zustände speichern und mehrstufige Aufgaben erledigen. Die tatsächlichen Fähigkeiten hängen von Integrationen, Berechtigungen, Richtlinien und Nachweisen ab, nicht vom Oberflächenlabel. Ein Rückgabeantrag braucht weiterhin gesonderte Schreibbefugnisse.
Wie steht es mit Latenz?
Miss die Zeit bis zur ersten nützlichen Antwort und bis zum verifizierten Abschluss an repräsentativen Aufgaben einschließlich langsamer und fehlgeschlagener nachgelagerter Aufrufe. Vergleiche Verteilungen wie Median und 95. Perzentil mit deiner Anforderung. Mehr Modell- oder Tool-Schritte können Verzögerungen verursachen, aber kein Label legt eine allgemeine Antwortzeit fest oder macht die Verzögerung akzeptabel.
Ist “KI-Agent” nur ein Marketing-Rebrand von “Chatbot”?
Die Begriffe überschneiden sich. Chatbot beschreibt eine Interaktionsoberfläche, agentische Orchestrierung meist die Auswahl von Schritten oder Tools durch ein Modell zur Laufzeit. Prüfe den tatsächlichen Ablauf, Befugnisprüfungen, Abbruchbedingungen und Ergebnisnachweise. Ein Produktname belegt weder höhere Autonomie oder Genauigkeit noch größeren Geschäftsnutzen.