


Se você está avaliando IA conversacional para suporte, vendas ou ferramentas internas, provavelmente percebeu que os fornecedores usam «chatbot» e «agente de IA» com sentidos muito diferentes. Alguns produtos chamados agentes são interfaces simples de um modelo de linguagem sem acesso a ferramentas. Alguns chatbots tomam decisões mais autônomas do que sistemas que se apresentam como agentes.
Um chatbot é uma interface de conversa; um agente de IA é uma forma possível de controlar o trabalho por trás dela. Um chatbot com fluxo programado pode chamar APIs e manter estado. Um agente pode escolher o próximo passo entre ferramentas permitidas, mas isso não comprova a identidade do usuário, autoriza uma escrita nem demonstra que uma tarefa deu certo. Este artigo compara três arquiteturas e usa um pedido de devolução hipotético para tornar esses limites concretos.
Uma observação sobre terminologia
O setor não adotou definições uniformes. Por isso, este artigo usa três categorias de trabalho, sem tratar nomes comerciais como especificações:
-
Chatbot baseado em regras: Classificação de intenções, extração de entidades e fluxos de diálogo programados escolhem o próximo passo. As respostas usam modelos de texto em vez de um LLM. O fluxo pode manter estado, chamar APIs e exigir aprovações.
-
Chatbot LLM limitado a respostas: Um modelo de linguagem responde a partir do contexto fornecido, muitas vezes recuperado de uma base de conhecimento. No exemplo deste artigo, ele não tem ferramentas de ação. Outros produtos chamados chatbots ou copilotos podem ter ferramentas, várias chamadas ao modelo e aprovações humanas.
-
Agente de IA: Um LLM seleciona passos e ferramentas dentro de um ciclo configurado, usando observações para decidir como continuar. Memória, permissões, condições de parada e revisão humana dependem da implementação. A autonomia é limitada pelas ferramentas e pela autoridade que o sistema realmente oferece.
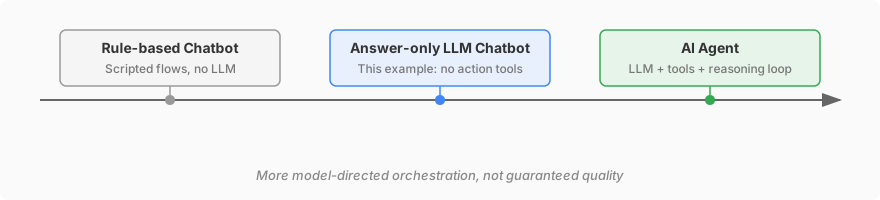 São exemplos esquemáticos. Mais orquestração dirigida pelo modelo não garante maior precisão, menor custo ou um resultado de negócio concluído.
Uma distinção arquitetural útil é quem escolhe o próximo passo: a lógica predefinida da aplicação ou o modelo. O guia da Anthropic sobre fluxos e agentes faz essa distinção e recomenda começar pela solução mais simples que atenda à tarefa. Sistemas híbridos podem combinar as duas abordagens.
Considere um cliente dizendo: «Recebi o item errado. Qual é a política de devolução e vocês podem iniciar uma devolução?» O exemplo abaixo é um projeto hipotético, não uma execução gravada do Quickchat AI nem um fluxo nativo de reembolso.
| Etapa | Trabalho permitido | Evidência necessária antes de declarar sucesso |
|---|---|---|
| Responder sobre a política | Recuperar a política publicada sem expor dados privados do pedido | A fonte da política aplicável; uma resposta não comprova a elegibilidade deste pedido |
| Ler o pedido | Usar um contexto de cliente autenticado e uma API que imponha acesso ao pedido correspondente | Uma resposta autorizada com os campos necessários; e-mail ou número de pedido digitado no chat não é autenticação |
| Solicitar uma devolução | Verificar separadamente permissão de escrita, condições da política e eventual confirmação exigida do cliente | Um resultado confirmado do sistema de devoluções, como o identificador de uma solicitação aceita; isso não é um reembolso pago nem uma devolução concluída |
| Encaminhar uma exceção | Parar quando faltar autoridade, houver exceção não suportada ou o resultado da escrita for incerto | Uma solicitação de encaminhamento registrada e seu destino ou fila conhecidos; sem prometer que uma pessoa já respondeu |
Um fluxo determinístico pode implementar as quatro etapas. Um sistema limitado a respostas pode explicar a política e direcionar o cliente a um serviço autenticado. Um agente pode escolher entre passos configurados, mas precisa cumprir os mesmos requisitos de acesso e evidência.
O que é um chatbot baseado em regras?
Um chatbot baseado em regras conversa por texto ou voz usando lógica predefinida. Ele combina classificação de intenções, extração de entidades e fluxos de diálogo programados.
Como chatbots baseados em regras funcionam
Uma arquitetura típica tem três componentes:
-
Compreensão de linguagem natural (NLU): Analisa a mensagem para identificar a intenção do usuário e extrair entidades, como datas, produtos ou números de pedido. Muitos sistemas NLU combinam expressões regulares, palavras-chave e classificadores treinados.
-
Gerenciador de diálogo: Uma máquina de estados determina o próximo passo a partir do estado da conversa e da intenção reconhecida. Cada estado tem transições possíveis, e o gerenciador segue o fluxo definido.
-
Gerador de respostas: Recupera um modelo de texto associado ao estado atual. Em chatbots simples, isso é uma tabela de consulta. Modelos mais elaborados têm campos preenchidos com as entidades extraídas.
Depois que o serviço autentica o cliente e verifica seu acesso ao pedido, um fluxo hipotético simplificado seria:
Usuário: «Qual é o status do pedido #12345?»
  → NLU: intent=order_status, entity={order_id: 12345}
  → Gerenciador de diálogo: state=check_order → chamada autorizada order_status_api(12345)
  → Resposta: «O pedido #12345 foi enviado em 7 de abril e está previsto para 11 de abril».
A arquitetura é a seguinte:

Isso funciona para problemas de domínio fechado, com um conjunto pequeno e bem definido de intenções. Um bot de perguntas frequentes, agendamento ou consulta de pedidos pode ser construído dessa forma.
Limitações da arquitetura baseada em regras
Uma máquina de estados precisa tratar explicitamente os caminhos que suporta. Seus limites práticos dependem do classificador, do projeto do fluxo e da cobertura das integrações:
-
Cobertura de intenções: As solicitações precisam corresponder a uma intenção suportada ou a uma alternativa. Uma formulação incomum pode ser classificada incorretamente, embora um classificador treinado consiga generalizar além das frases exatas. Intenções sobrepostas exigem avaliação e manutenção.
-
Ramificações predefinidas: O gerenciador pode combinar informações armazenadas de vários turnos e ramificar com base nelas. Novos tipos de decisão ainda precisam de regras ou de outro componente; o grafo não inventa um fluxo durante a execução.
-
Extração de entidades frágil: O preenchimento tradicional de campos funciona com entradas estruturadas, como datas, números e SKUs, mas enfrenta dificuldades com descrições abertas, referências ambíguas e pedidos com várias partes.
-
Manutenção do fluxo: Novos usos podem exigir intenções, ramificações, modelos ou integrações adicionais. Componentes reutilizáveis ajudam, mas o esforço de manutenção precisa ser medido, sem supor crescimento a uma taxa fixa.
Para aprofundar a evolução dessas arquiteturas, veja Dos chatbots de NLP à IA generativa.
O que é um agente de IA?
Aqui, um agente de IA é um sistema em que um LLM seleciona o próximo passo ou ferramenta a partir da tarefa e das observações. Ele pode operar dentro de um fluxo programado mais amplo. Memória persistente e permissão para modificar sistemas externos são capacidades opcionais, não consequências do nome.
O termo «agente» também tem uma história mais ampla na pesquisa em IA: um sistema percebe o ambiente e age em direção a objetivos. Este artigo se concentra na orquestração baseada em LLM, em que observação, planejamento, execução de ferramentas e avaliação podem se repetir até uma condição de parada.
Como agentes de IA funcionam
A arquitetura central é um ciclo de raciocínio, também chamado ciclo ReAct por causa do artigo ReAct, que formalizou o padrão. O ciclo tem quatro fases:
-
Observar: O agente recebe a mensagem com histórico da conversa, instruções do sistema e contexto recuperado, como artigos relevantes da base de conhecimento.
-
Raciocinar: O LLM usa o contexto disponível para selecionar uma resposta, um esclarecimento ou uma chamada de ferramenta. Diferentemente de uma transição fixa do grafo, essa seleção ocorre durante a execução. Ela pode estar errada e precisa de avaliação.
-
Agir: O modelo propõe uma chamada estruturada, como
search_knowledge_base(query="return policy")oucreate_return_request(order_id=12345). Os controles da aplicação e a API de destino devem impor a operação e o escopo permitidos antes da execução. Uma chamada proposta não é autorização. -
Avaliar: O sistema examina o resultado e decide continuar, responder ou parar para revisão humana. A conclusão do modelo de que terminou não é evidência independente de sucesso de uma operação de negócio. Limite o ciclo e verifique o estado externo quando necessário.

O mesmo cenário de devolução pode ser expresso como um fluxo de controle proposto. Nenhuma chamada abaixo foi executada e nenhum resultado foi observado. Os nomes das operações são ilustrativos, não uma configuração do Quickchat AI para colar em uma conta.
Cliente: «Recebi o item errado. Vocês podem iniciar uma devolução?»

[Política] Recuperar a política aplicável e citar suas condições.
[Leitura]  Exigir contexto de cliente autenticado e acesso àquele pedido.
           Consultar o pedido correspondente pelo serviço autorizado.
           Tratar «item errado recebido» como relato do cliente até verificar.
[Controle] Verificar política, autoridade de escrita e confirmação necessária.
           Se faltar uma condição, pedir esclarecimento ou encaminhar.
[Escrita]  Enviar a solicitação somente após passar pelo controle separado de escrita.
[Verificação] Informar aceitação somente se o resultado externo a confirmar.
           Uma solicitação aceita não significa que um reembolso foi pago.
           Se o resultado for incerto, consultar o estado ou encaminhar, sem repetir às cegas.
[Encaminhamento] Registrar fatos pendentes e fila ou destinatário conhecidos.
           Não afirmar que uma pessoa já respondeu.
A parte agêntica é selecionar o próximo passo permitido com base no contexto. O serviço ainda precisa de ferramentas definidas, regras de política, verificações de identidade e tratamento de falhas. Um fluxo fixo poderia executar as mesmas operações; a arquitetura muda a orquestração, não a autoridade do cliente.
Uso de ferramentas e function calling
O uso de ferramentas, ou chamada de funções, conecta um modelo a consultas ou operações externas. O LLM recebe esquemas com nomes, tipos e descrições dos parâmetros. Pode propor uma chamada entre as disponíveis; a aplicação decide se ela é permitida e como o resultado será exposto.
Categorias comuns para agentes voltados ao cliente incluem:
| Categoria | Exemplos |
|---|---|
| Recuperação de conhecimento | Pesquisar a base de conhecimento, consultar perguntas frequentes e documentação |
| Consulta de dados | Verificar pedidos, recuperar dados da conta ou consultar estoque |
| Operações de escrita | Criar solicitação de devolução ou ticket, atualizar um campo permitido; cada operação exige sua própria autoridade |
| Comunicação | Enviar e-mail, disparar SMS ou publicar no Slack |
| Escalonamento | Solicitar revisão humana com contexto relevante e fila ou destinatário conhecidos |
Um esquema descreve o formato da chamada; não autentica o cliente nem aplica a política comercial. Valide parâmetros e acesso no destino, restrinja campos expostos e diferencie leitura de alteração de estado. Instruções de prompt, sozinhas, não são uma fronteira de segurança.
O tutorial para criar um agente de IA que executa ações reais explica uma requisição HTTP descrita e chamada durante a conversa. A continuação sobre ordenar Actions com condições e resultados salvos apresenta Run only when e Save to memory. Esses controles não estabelecem a identidade do cliente nem tornam uma escrita idempotente: metadados confiáveis e autorização no destino continuam necessários. Os links preservam o contexto de suas próprias demonstrações; o fluxo hipotético de devolução deste artigo não foi testado.
Memória e gerenciamento de contexto
Um chatbot programado pode armazenar campos como order_id=12345 e intent=order_status, além do histórico ou de outros estados. Agentes costumam combinar diferentes tipos de contexto para pedidos abertos. Nenhuma arquitetura oferece automaticamente memória segura entre sessões.
Camadas úteis de contexto incluem:
- Histórico da conversa: A sequência original de mensagens na sessão atual.
- Memória de trabalho: Resultados intermediários de ferramentas e raciocínio que orientam decisões posteriores.
- Contexto recuperado: Artigos, documentação ou registros de clientes obtidos por geração aumentada por recuperação (RAG) para a consulta atual.
- Memória de longo prazo (opcional): Fatos persistentes sobre usuário ou conta entre sessões, como idioma preferido, problemas anteriores ou nível de assinatura.
A janela de contexto do LLM é uma restrição técnica. Resumos, janelas deslizantes e recuperação seletiva podem reduzir o tamanho do contexto, mas omitir detalhes importantes. Mantenha identidade, permissões e estado transacional oficial em sistemas confiáveis em vez de depender de um resumo do modelo.
O meio-termo: chatbots com LLM e copilots
Um chatbot LLM limitado a respostas pode recuperar conhecimento, passá-lo ao modelo junto com a mensagem e devolver a resposta. Esse projeto simples não tem um ciclo de ações dirigido pelo modelo. É um padrão de implementação, não a definição de todo chatbot ou copiloto.
Para perguntas sobre políticas, um sistema de recuperação e resposta pode bastar. Ele pode tratar formulações variadas sem criar uma intenção para cada frase. Ainda é preciso avaliar qualidade da recuperação, idiomas suportados e fontes.
No exemplo de devolução, um sistema limitado a respostas explica a política publicada, mas não consulta dados privados do pedido nem cria uma solicitação. Acrescente um fluxo autenticado ou ferramentas devidamente restritas se essas operações forem necessárias. Uma integração programada também pode realizá-las.
Projetos híbridos também são possíveis: um LLM classifica o pedido, um fluxo determinístico impõe as verificações e um modelo redige a resposta. Avalie onde as decisões acontecem, quais operações são permitidas e que evidência retorna, sem deduzir isso das palavras «chatbot», «copiloto» ou «agente».
Comparação lado a lado
A coluna central descreve o exemplo limitado a respostas deste artigo. RAG, estado persistente e acesso a APIs podem ser combinados com outras arquiteturas.
| Dimensão | Chatbot baseado em regras | Chatbot LLM limitado a respostas | Agente de IA |
|---|---|---|---|
| Motor central | Classificador de intenções e lógica predefinida | LLM com fluxo de recuperação e resposta | LLM seleciona passos em um ciclo controlado |
| Geração de respostas | Modelos de texto e valores armazenados | Geradas a partir do contexto fornecido | Geradas a partir do contexto e dos resultados disponíveis |
| Fluxo de conversa | Transições definidas com estado entre turnos | Responder ou esclarecer no fluxo configurado | Modelo escolhe o próximo passo permitido |
| Ferramentas | O fluxo pode incluir chamadas a APIs | Nenhuma ferramenta de ação neste exemplo | Modelo propõe chamadas; aplicação impõe acesso |
| Tarefas de várias etapas | Sequência e ramificações explícitas | Precisa de fluxo adicional para operações externas | Pode selecionar uma sequência dentro dos limites |
| Pedidos novos | Depende da cobertura do classificador e das alternativas | Responde apenas quando o contexto sustenta | Pode escolher um caminho útil ou decidir incorretamente |
| Conhecimento | Busca configurada, APIs ou respostas armazenadas | Frequentemente RAG; depende da implementação | Frequentemente RAG e ferramentas; depende da implementação |
| Manutenção | Manter fluxos, modelos, integrações e testes | Manter fontes, recuperação e avaliação | Manter fontes, ferramentas, políticas e avaliação |
| Estrutura de custos | Hospedagem, integrações, licenças e trabalho humano | Uso de plataforma ou modelo e trabalho humano | Uso de plataforma ou modelo, ferramentas e trabalho humano |
| Falhas | Roteamento incorreto, estado errado ou erro de API | Resposta sem fundamento ou falha de recuperação | Resposta sem fundamento, ferramenta incorreta ou escrita incerta |
| Latência | Depende do fluxo e dos serviços subsequentes | Depende de recuperação, modelo e entrega | Depende dos passos selecionados, serviços e entrega |
Chatbots baseados em regras ainda fazem sentido?
Sim. Escolha a arquitetura mais simples que cumpra qualidade, controle e tempo de resposta exigidos. Um fluxo programado pode bastar para um formulário estável, poucas respostas aprovadas ou uma consulta autorizada com passos fixos. Adicionar um modelo não elimina a manutenção de integrações e políticas.
Várias condições podem favorecer fluxos predefinidos:
Respostas com redação aprovada. Modelos de texto podem preservar um conteúdo revisado. Isso é um controle, não prova de conformidade regulatória; elegibilidade, informações obrigatórias, acesso e deveres de revisão continuam dependendo da implantação.
Operações simples e repetíveis. Uma sequência conhecida pode evitar chamadas desnecessárias ao modelo em qualquer volume de tráfego. Compare custos reais de hospedagem, licenças, APIs e manutenção sem assumir um limite universal de volume.
Integrações existentes que funcionam. Preserve fluxos confiáveis e acrescente compreensão de linguagem ou ferramentas específicas onde a avaliação demonstrar uma melhoria útil. Não é preciso substituir todas as intenções e fluxos para usar um LLM.
Vale avaliar um projeto agêntico quando os passos necessários variam e a seleção pelo modelo agrega valor. Use tarefas representativas e casos de falha para verificar isso; o nome da arquitetura não fornece uma taxa padrão de sucesso.
Onde agentes de IA são mais fortes
A orquestração dirigida pelo modelo merece avaliação quando os pedidos variam o suficiente para tornar útil selecionar o próximo passo durante a execução. Os exemplos abaixo são usos candidatos, não alegações de superioridade medida:
Suporte envolvendo vários sistemas. O exemplo de devolução combina recuperação de política, leitura autorizada do pedido e uma solicitação autorizada separadamente. O modelo pode ajudar a escolher a próxima etapa relevante, enquanto um fluxo fixo continua sendo uma alternativa válida.
Perguntas abertas sobre produtos. Uma pergunta sobre tamanho da equipe, acesso a canais e limites do plano pode exigir vários fatos documentados. A recuperação ajuda tanto chatbots limitados a respostas quanto agentes. Nenhum deve inferir conformidade legal ou direitos não documentados a partir de uma descrição comercial.
Conversas de vendas. Um modelo pode coletar requisitos declarados e recuperar contexto permitido do CRM. Compare precisão das recomendações, consentimento e resultados úteis com o fluxo existente antes de afirmar maior eficácia.
Suporte multilíngue. Modelos de linguagem podem reduzir respostas redigidas separadamente, mas idiomas suportados e qualidade variam. Avalie terminologia, tom, fidelidade às políticas e escalonamento em cada idioma. Um ciclo agêntico não é necessário para respostas multilíngues e não elimina a localização.
Decisões de escalonamento. Regras configuradas e julgamentos do modelo podem ajudar a identificar falta de conhecimento ou pedidos de atendimento humano. Confiança do modelo ou sentimento não são provas confiáveis de uma decisão correta. Verifique solicitação de encaminhamento e processo da equipe separadamente da resposta de IA.
Para conhecer os componentes das plataformas, veja o Guia de plataformas de IA conversacional.
Como agentes de IA funcionam em produção
Sistemas em produção combinam comportamento do modelo com controles de aplicação. Controles semelhantes também podem apoiar fluxos programados; não são exclusivos de agentes.
Limites e regras de comportamento. As instruções definem escopo, tom e escalonamento. Verificações da aplicação restringem operações e condições de parada. Teste recusas e falhas além dos pedidos esperados; um prompt não garante que toda resposta siga a política.
Fundamentação em conhecimento (RAG). A recuperação fornece fontes antes da geração e pode reduzir respostas sem apoio. Não garante correção factual. Examine a fonte recuperada e a afirmação resultante com a rastreabilidade efetivamente exposta pela implementação. Veja O que são alucinações de IA? para aprofundar.
Acesso a ferramentas e permissões de ação. APIs ou servidores MCP podem expor leituras e escritas. Limite credenciais e operações, imponha acesso do cliente no destino e trate textos retornados como dados. Uma ferramenta configurada ou parâmetros propostos não concedem autoridade sobre pedidos alheios ou reembolsos não aprovados.
Quickchat AI Agents oferece respostas pela Knowledge Base e API e MCP Actions configuradas. API Actions podem usar condições Run only when verificadas fora do modelo; use metadados confiáveis e mantenha a autorização da API de destino. Human Handoff pausa respostas de IA e coloca a conversa na Inbox, atribuída quando o roteamento escolhe alguém ou sem atribuição caso contrário. Atribuir não garante resposta humana imediata. O fluxo de devolução acima exige serviços externos e configuração adequados; não promete processamento nativo de devoluções ou reembolsos.
Trade-offs de custo e desempenho
Escolher entre chatbot e agente de IA é uma decisão tanto arquitetural quanto econômica.
Economia de chatbots
Um fluxo programado pode evitar inferência do LLM, mas seu custo marginal não é necessariamente zero. Inclua hospedagem, licenças, APIs subsequentes, monitoramento e atendimento humano. Uma consulta simples pode ser barata nas duas arquiteturas; meça a implantação real.
A manutenção inclui fluxos, modelos de texto, integrações e cobertura de testes. Sistemas agênticos acrescentam trabalho com prompts, recuperação, ferramentas e avaliação. Estime ambos para o mesmo escopo e período, sem presumir menor manutenção para um deles.
Economia de agentes de IA
Inferência e execução de ferramentas consomem recursos, mas a cobrança da plataforma pode usar créditos, conversas, resoluções, assentos ou assinatura. O custo interno por token não é necessariamente a unidade cobrada do cliente.
Compare diretamente os termos atuais: os preços do Quickchat AI, Intercom e Salesforce Agentforce usam unidades e condições específicas. Confira taxa-base, compromisso mínimo, uso incluído, excedentes e definição do resultado faturável. Uma conversa e uma resolução verificada não são intercambiáveis. O guia de modelos de preços de agentes de IA explica como comparar esses escopos sem equiparar tarifas anunciadas.
Use sua própria coorte de pedidos elegíveis para estimar custo por resultado verificado. Inclua tentativas malsucedidas, contatos repetidos, retrabalho humano, gastos recorrentes e configuração inicial. O custo do suporte humano também depende de canal e escopo de custos; um número amplo do setor não é uma base equivalente para sua implantação. Tempo liberado é capacidade, não economia de caixa, a menos que um custo real diminua ou uma despesa prevista seja evitada.
Para calcular no mesmo período, veja Como calcular o ROI de um chatbot. Não se presume aqui vantagem na taxa de resolução nem percentual de economia. Meça o tempo até a primeira resposta útil e até a conclusão verificada, incluindo serviços subsequentes e encaminhamento; nenhuma arquitetura tem uma faixa universal de latência.
Medindo sucesso de forma diferente
Compare as arquiteturas com critérios de resultado comuns e depois acrescente diagnósticos para seus diferentes tipos de falha.
Diagnósticos do fluxo incluem intenções reconhecidas, motivos de respostas alternativas, transições de estado, erros de API e cumprimento de etapas obrigatórias. Um fluxo concluído não significa necessariamente um problema do cliente resolvido.
Métricas de resultado incluem resolução verificada entre pedidos elegíveis, contatos repetidos, retrabalho humano, satisfação acompanhada do número de respostas e custo por resultado verificado. Para agentes, examine também afirmações sem apoio, escolha de ferramentas, acesso negado e escritas incertas. Não conte resposta gerada, solicitação de devolução aceita e reembolso concluído como o mesmo resultado.
O guia de análise de chatbots separa observações nativas do produto de métricas que exigem evidência externa e inclui uma planilha sintética. Defina denominador e janela de observação antes da comparação; a planilha não é um benchmark.
Mantenha evidência suficiente para auditar separadamente resposta sobre política, consulta autorizada, alteração externa e encaminhamento. Fontes recuperadas, respostas de ferramentas e estado oficial do sistema têm finalidades distintas. Use registros sintéticos ou devidamente protegidos na avaliação e não exponha dados privados de clientes em exemplos compartilhados.
FAQ
Posso converter meu chatbot existente em um agente de IA?
Muitas vezes é possível adicionar gradualmente compreensão de linguagem ou ferramentas específicas, mantendo fluxos, conhecimento e integrações úteis. Selecionar ferramentas pelo modelo é uma mudança arquitetural que exige avaliação. Preserve autorização, aprovações obrigatórias e etapas determinísticas confiáveis em vez de descartá-las apenas para usar o nome de agente.
Agentes de IA são mais caros do que chatbots?
Não existe resposta universal. Compare assinaturas, unidades de cobrança, uso, configuração, manutenção e retrabalho humano para as mesmas tarefas elegíveis e o mesmo período. Chamadas ao modelo consomem recursos, mas a cobrança ao cliente varia. Melhorias de resolução e economia de caixa precisam ser medidas; tempo liberado não é automaticamente dinheiro economizado.
Agentes de IA alucinam?
Sim. A recuperação pode fornecer fontes relevantes, mas não garante uma resposta correta. Verifique se as afirmações decorrem das fontes e se um resultado de ferramenta confirma de fato o desfecho declarado. Aplique o mesmo rigor aos chatbots LLM limitados a respostas e encaminhe quando faltarem evidências.
Um agente de IA consegue lidar com tarefas que um chatbot não consegue?
Um agente pode escolher passos úteis para pedidos variados que um fluxo existente não cobre. Chatbots programados também podem chamar APIs, manter estado e concluir tarefas com várias etapas. A capacidade real depende de integrações, permissões, políticas e evidências, não do nome da interface. Uma solicitação de devolução continua exigindo autoridade de escrita separada.
E quanto à latência?
Meça tempo até a primeira resposta útil e até a conclusão verificada em tarefas representativas, incluindo chamadas subsequentes lentas ou malsucedidas. Compare distribuições, como mediana e percentil 95, com seus requisitos. Mais etapas de modelo ou ferramentas podem adicionar atraso, mas nenhum nome estabelece um tempo universal nem torna esse atraso aceitável.
”Agente de IA” é apenas um rebranding de marketing de “chatbot”?
Os nomes se sobrepõem. Chatbot descreve uma interface, enquanto orquestração agêntica normalmente significa que um modelo seleciona passos ou ferramentas durante a execução. Examine fluxo real, controles de autoridade, condições de parada e evidências de resultado. O nome do produto não comprova mais autonomia, precisão ou valor de negócio.