

Если вы оцениваете разговорный ИИ для поддержки, продаж или внутренних инструментов, вы, вероятно, заметили, что поставщики используют термины “чатбот” и “AI-агент” в очень разных значениях в зависимости от того, что они продают. Некоторые продукты с маркировкой “AI-агент” представляют собой тонкие оболочки вокруг языковой модели без доступа к инструментам. Некоторые продукты с маркировкой “чатбот” выполняют больше автономных рассуждений, чем системы, которые называют себя агентами.
В этой статье определяются три категории разговорных ИИ-систем на основе их архитектуры, объясняется, на что каждая из них фактически способна, и рассматривается, когда какую использовать. Цель, дать вам достаточную техническую основу, чтобы оценивать продукты по их фактической архитектуре, а не по брендингу.
Примечание о терминологии
В отрасли пока нет согласованных определений, поэтому в этой статье используются три категории:
-
Чатбот на правилах: Система, построенная на классификации интентов, извлечении сущностей и сценарных диалоговых потоках. Языковая модель не участвует в генерации ответов. Это традиционная архитектура чатботов, которая существует с 2010-х годов.
-
LLM-чатбот (или copilot): Система, которая использует большую языковую модель для понимания и генерации ответов, но работает по схеме запрос-ответ без автономного использования инструментов или многошагового рассуждения. Многие продукты “AI chatbot” на рынке относятся к этой категории. Они гибче чатботов на правилах, потому что LLM обрабатывает открытый язык, но они не выполняют действия во внешних системах и не планируют многошаговые рабочие процессы.
-
AI-агент: Система, построенная вокруг LLM, которая может рассуждать о задачах, использовать инструменты, сохранять память между взаимодействиями и автономно выполнять многошаговые рабочие процессы. LLM работает внутри цикла, где она наблюдает, рассуждает, действует и оценивает, завершена ли задача.
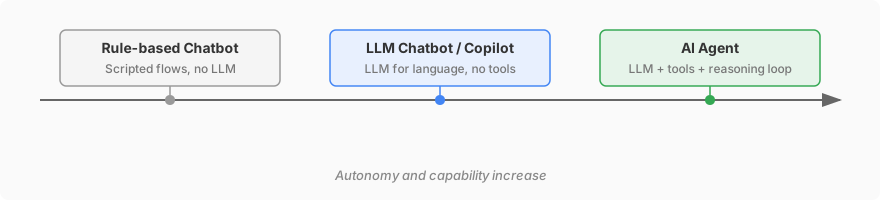 Автономность и возможности возрастают слева направо. Большинство продуктов “AI chatbot” в 2026 году находятся где-то на этом спектре.
Остальная часть статьи рассматривает все три категории, хотя основная часть архитектурных деталей относится к чатботам на правилах и AI-агентам, поскольку между ними самый большой разрыв. Раздел об LLM-чатботах короче, потому что архитектурно это ограниченная версия AI-агента: та же языковая модель, но без цикла использования инструментов.
Что такое чатбот на правилах?
Чатбот на правилах ведет беседы с пользователями через текст или голос, используя заранее заданную логику. Он строится на сочетании классификации интентов, извлечения сущностей и сценарных диалоговых потоков.
Как работают чатботы на правилах
Типичная архитектура чатбота состоит из трех компонентов:
-
Natural Language Understanding (NLU): Разбирает сообщение пользователя, чтобы определить интент (что хочет пользователь) и извлечь сущности (конкретные данные, такие как даты, названия продуктов или номера заказов). Большинство NLU-систем используют сочетание regex-шаблонов, сопоставления ключевых слов и обученных классификаторов.
-
Dialogue Manager: Конечный автомат, который определяет следующий шаг на основе текущего состояния беседы и распознанного интента. У каждого состояния есть набор возможных переходов, и Dialogue Manager следует заданному потоку.
-
Response Generator: Извлекает шаблонный ответ, связанный с текущим состоянием. В простых чатботах это таблица соответствий. В немного более сложных версиях шаблон включает слоты, которые заполняются извлеченными сущностями.
Упрощенный поток выглядит так:
User: "What's the status of order #12345?"
  → NLU: intent=order_status, entity={order_id: 12345}
  → Dialogue Manager: state=check_order → call order_status_api(12345)
  → Response: "Order #12345 shipped on April 7 and is expected by April 11."
Архитектура выглядит так:
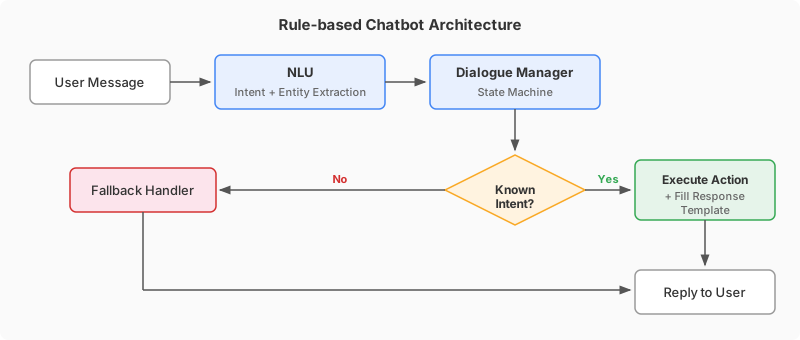
Это хорошо работает для задач в закрытой предметной области, где набор возможных интентов мал и четко определен. FAQ-бот, планировщик встреч или проверка статуса заказа могут быть построены таким образом.
Ограничения архитектуры на правилах
Модель конечного автомата ломается, когда беседы становятся непредсказуемыми. В частности:
-
Жесткая таксономия интентов: Каждый запрос пользователя должен сопоставляться с заранее определенным интентом. Если пользователь формулирует что-то способом, которого NLU-модель не видела, запрос попадает в fallback handler. По мере роста числа интентов поддержание таксономии и предотвращение пересечений между похожими интентами становится значительной инженерной нагрузкой.
-
Нет рассуждения между репликами: Dialogue Manager следует фиксированному графу. Он не может объединять информацию из нескольких реплик, чтобы принять ситуативное решение, взвесить компромиссы или адаптировать подход с учетом контекста.
-
Хрупкое извлечение сущностей: Традиционное заполнение слотов работает для структурированных вводов (даты, числа, SKU продуктов), но плохо справляется с открытыми описаниями, неоднозначными ссылками или составными запросами.
-
Линейный рост трудозатрат: Поддержка нового сценария означает определение новых интентов, новых диалоговых потоков, новых шаблонов ответов и нового интеграционного кода. Каждое добавление пропорционально увеличивает поверхность обслуживания.
Более подробный обзор того, как архитектуры чатботов развивались за годы, см. в статье От NLP-чатботов к генеративному ИИ.
Что такое AI-агент?
AI-агент, это система, построенная вокруг большой языковой модели (LLM), которая может рассуждать о задачах, использовать инструменты, сохранять память между взаимодействиями и принимать решения о том, как продолжать, не следуя сценарному потоку.
Термин “агент” в этом контексте происходит из традиции исследований ИИ, где агентом называется любая система, которая воспринимает среду и выполняет действия для достижения целей. В волне LLM-приложений 2024-2026 годов “AI-агент” конкретно обозначает системы, которые используют LLM как механизм рассуждения внутри цикла, включающего наблюдение, планирование, выполнение инструментов и оценку.
Как работают AI-агенты
Основная архитектура AI-агента, это цикл рассуждения (иногда называется циклом ReAct по названию статьи ReAct, где был формализован этот паттерн). Цикл состоит из четырех фаз:
-
Observe: Агент получает сообщение пользователя вместе с историей беседы, системными инструкциями и любым извлеченным контекстом (например, релевантными статьями базы знаний).
-
Reason: LLM обрабатывает весь доступный контекст и решает, что делать дальше. Это может быть прямой ответ пользователю, уточняющий вопрос или вызов инструмента. Шаг рассуждения, это то, чем агент больше всего отличается от чатбота: вместо следования графу состояний LLM генерирует план на основе своего понимания задачи.
-
Act: Если агент решает использовать инструмент, он генерирует структурированный вызов функции (например,
search_knowledge_base(query="refund policy for damaged items")илиcreate_ticket(customer_id=456, issue="shipping delay")). Система выполняет функцию и возвращает результат агенту. -
Evaluate: Агент просматривает вывод инструмента и решает, завершена ли задача или нужен еще один шаг. Если требуется дополнительная работа, цикл повторяется с фазы рассуждения.
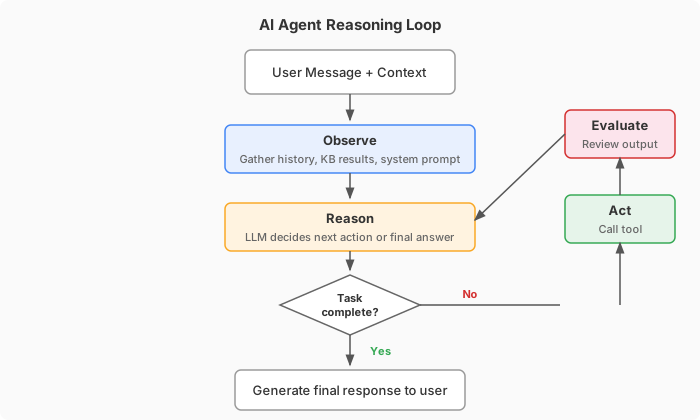
Вот конкретный пример такого цикла в действии:
User: "I ordered a laptop last week but received a monitor instead.
       I need the right item shipped and a return label for the monitor."

Agent reasoning loop:
  [Reason] User has two needs: correct item shipment + return label.
           Need to look up the order first.
  [Act]    lookup_order(customer_email="user@example.com", timeframe="7d")
           → Returns: Order #7891, laptop SKU-A100, shipped monitor SKU-B200
  [Reason] Order found. Wrong item confirmed. Need to initiate exchange
           and generate return label.
  [Act]    initiate_exchange(order_id=7891, correct_sku="SKU-A100")
           → Returns: Exchange #EX-442 created, shipping in 1-2 days
  [Act]    generate_return_label(order_id=7891, item_sku="SKU-B200")
           → Returns: Label URL https://...
  [Evaluate] Both tasks complete. Compose response.

Agent: "I found your order #7891. The correct laptop (SKU-A100) will ship
        within 1-2 business days. Here's your return label for the monitor:
        [link]. Drop it off at any carrier location."
Ключевое отличие от подхода чатбота: никому не пришлось заранее определять интент “order_wrong_item_exchange_and_return” или строить отдельный диалоговый поток для этого сценария. Агент декомпозировал проблему, вызвал нужные инструменты в правильном порядке и составил ответ.
Использование инструментов и вызов функций
Использование инструментов (также называется вызовом функций) дает AI-агентам возможность действовать в мире, а не только генерировать текст. LLM получает список доступных инструментов с их схемами (имена параметров, типы, описания) и может выбрать любой из них во время цикла рассуждения.
Распространенные категории инструментов для AI-агентов, работающих с клиентами, включают:
| Категория | Примеры |
|---|---|
| Извлечение знаний | Поиск по базе знаний, просмотр FAQ, извлечение документации продукта |
| Поиск данных | Проверка статуса заказа, получение данных аккаунта, запрос складских остатков |
| Операции записи | Создание тикета в поддержку, обновление записи клиента, обработка возврата средств |
| Коммуникация | Отправка email, запуск SMS, публикация в Slack |
| Эскалация | Передача человеку-агенту с полным контекстом беседы |
Схема инструмента выступает контрактом между LLM и внешней системой. Хорошо спроектированная схема дает LLM достаточно информации, чтобы выбрать правильный инструмент и передать корректные параметры без дополнительных промптов.
Чтобы увидеть использование инструментов, построенное с нуля, наше пошаговое руководство по созданию AI-агента, который выполняет реальные действия добавляет ровно один такой инструмент, описанный HTTP-запрос, который агент вызывает в середине беседы, бесплатно и без кода. Чтобы эти операции записи срабатывали в правильном порядке и только после поиска заказа, вы добавляете условие запуска и передаете id дальше.
Память и управление контекстом
Чатботы обычно хранят состояние беседы как набор заполненных слотов (например, order_id=12345, intent=order_status). AI-агентам нужна более богатая модель памяти, потому что они обрабатывают открытые беседы, где релевантная информация может появиться в любой момент.
Большинство реализаций AI-агентов используют несколько слоев контекста:
- История беседы: Исходная последовательность сообщений в текущей сессии.
- Рабочая память: Промежуточные результаты вызовов инструментов и шагов рассуждения, которые влияют на последующие решения.
- Извлеченный контекст: Статьи базы знаний, документация продукта или записи клиентов, полученные через retrieval-augmented generation (RAG) на основе текущего запроса.
- Долгосрочная память (необязательно): Постоянные факты о пользователе или аккаунте, которые сохраняются между сессиями (например, предпочтительный язык, прошлые проблемы, уровень подписки).
Управление контекстом в пределах токенового окна LLM, это реальная инженерная задача. По мере того как беседы становятся длиннее и вызывается больше инструментов, контекст может превысить емкость модели. Стратегии вроде суммаризации, скользящих окон и выборочного извлечения помогают сохранить работоспособность агента без потери критически важной информации.
Середина спектра: LLM-чатботы и copilots
Большинство продуктов, которые в 2026 году продвигаются как “AI chatbots”, находятся в категории между чатботами на правилах и полноценными AI-агентами. Эти системы используют LLM для понимания пользовательского ввода и генерации ответов на естественном языке, но у них нет доступа к инструментам и они не выполняют многошаговые рабочие процессы автономно.
Типичный LLM-чатбот работает так: пользователь отправляет сообщение, система извлекает релевантный контекст из базы знаний (через RAG), передает сообщение и контекст в LLM и возвращает сгенерированный ответ. Здесь нет цикла рассуждения, выбора инструментов и итеративного выполнения. Каждое сообщение пользователя запускает один вызов LLM.
Эта архитектура значительно лучше чатботов на правилах. LLM обрабатывает открытый язык без заранее определенной таксономии интентов, генерирует естественные ответы вместо заполнения шаблонов и может работать на любом языке, который поддерживает модель. Для чистых Q&A-сценариев, где цель состоит в ответах на вопросы из базы знаний, LLM-чатбота может быть достаточно.
Ограничение проявляется, когда пользователю нужно, чтобы система что-то сделала: нашла заказ, создала тикет, обработала возврат средств, проверила остатки или скоординировала данные из нескольких источников. LLM-чатбот может только предложить пользователю выполнить эти действия самостоятельно или передать обращение человеку. AI-агент может выполнить их напрямую.
На практике граница между LLM-чатботом и AI-агентом не всегда четкая. Добавление одного инструмента (например, поиска заказа) к LLM-чатботу сдвигает его к агентному концу спектра. Различие больше связано со степенью автономности, чем с жесткой границей. Тем не менее архитектурное различие важно: LLM-чатбот без цикла рассуждения обрабатывает один запрос за раз, тогда как агент может связывать несколько наблюдений и действий для решения составных проблем.
Сравнение рядом
| Измерение | Чатбот на правилах | LLM Chatbot / Copilot | AI-агент |
|---|---|---|---|
| Основной движок | NLU-классификатор + конечный автомат | LLM (один ход) | LLM с циклом рассуждения |
| Генерация ответа | Поиск шаблона / заполнение слотов | Генерируется из контекста | Генерируется из контекста + результатов инструментов |
| Поток беседы | Заранее заданный граф диалога | Открытый, но по одному обмену за раз | Динамический, многошаговый, определяется во время выполнения |
| Использование инструментов | Жестко закодированные API-вызовы на интент | Нет | LLM выбирает инструменты из доступного набора |
| Многошаговые задачи | Требуется явный поток для каждого пути | Не может связывать действия | Автономно декомпозирует задачи |
| Обработка новых запросов | Fallback / “Я не понимаю” | Может ответить, если контекст есть в KB | Рассуждает на основе контекста + выполняет действие |
| Доступ к знаниям | Поиск по ключевым словам или точное совпадение | RAG с семантическим поиском | RAG с семантическим поиском и reranking |
| Модель обслуживания | Добавление интентов, потоков, шаблонов на сценарий | Обновление базы знаний | Расширение набора инструментов и базы знаний |
| Структура затрат | Низкие вычисления (без LLM-инференса) | Стоимость LLM за токены | Стоимость LLM за токены + выполнение инструментов |
| Режим отказа | Тихая неверная маршрутизация или fallback | Галлюцинация | Галлюцинация, неверное использование инструментов |
| Задержка | Быстро (на основе lookup) | 1-3 секунды (один вызов LLM) | Переменная (зависит от шагов рассуждения) |
Имеют ли чатботы на правилах смысл сегодня?
Для большинства сценариев в 2026 году, нет. AI-агенты стали достаточно хорошими, достаточно дешевыми и достаточно надежными, чтобы новый проект на чатботе на правилах было трудно обосновать. AI-агент справляется со всем, с чем справляется чатбот (FAQ, простые lookup-запросы, сбор данных), а также обрабатывает длинный хвост запросов, с которыми чатботы не справляются. Нагрузка на обслуживание тоже ниже: вместо определения интентов и потоков для каждого нового сценария вы расширяете базу знаний и добавляете инструменты.
Есть несколько узких ситуаций, где чатбот на правилах все еще может быть прагматичным выбором:
Регуляторные ограничения, требующие детерминированных, заранее утвержденных ответов. В некоторых регулируемых отраслях (раскрытия в здравоохранении, финансовый комплаенс) каждый ответ должен быть проверен и утвержден до запуска. Чатбот с шаблонными ответами удовлетворяет этому требованию по своей конструкции. AI-агенты можно ограничивать guardrails, но вывод все равно генерируется, а не утверждается заранее слово в слово.
Экстремальная чувствительность к стоимости при очень большом масштабе. Если вы обрабатываете десятки миллионов одношаговых взаимодействий в месяц, а сценарий действительно прост (например, проверка баланса, подтверждение бронирования), стоимость LLM-инференса на взаимодействие может не окупаться. Этот порог продолжает смещаться по мере снижения стоимости моделей, но на начало 2026 года он все еще существует при очень больших объемах.
Унаследованные системы без пути миграции. У некоторых организаций чатботы на правилах глубоко интегрированы в инфраструктуру, а бюджета или сроков на замену нет. В этих случаях вопрос не “что лучше”, а “что мы можем сделать прямо сейчас”.
За пределами этих крайних случаев AI-агент лучше подходит как вариант по умолчанию. Вопрос сместился от “использовать AI-агента или чатбота” к “как настроить и ограничить AI-агента для нашей конкретной предметной области”.
Где AI-агенты сильнее всего
AI-агенты, это очевидный выбор для большинства новых проектов разговорного ИИ в 2026 году. Несколько сценариев, где разрыв между агентами и чатботами на правилах особенно велик:
Сложные запросы в поддержку, охватывающие несколько систем. Пример с обменом заказа выше типичен. У пользователя составная проблема, которая требует поиска данных, принятия решений и выполнения нескольких действий. Чатботу понадобился бы отдельный поток для каждой возможной комбинации проблем.
Открытые вопросы о продукте. “Какой тариф подойдет команде из 15 человек, которой нужна интеграция WhatsApp и соответствие HIPAA?” требует рассуждения по документации продукта, правилам ценообразования и требованиям комплаенса. Агент может извлечь релевантные документы и синтезировать ответ. Чатботу понадобилась бы нереалистично большая таксономия интентов, чтобы покрыть все возможные вопросы о продукте.
Диалоги продаж. Квалификация лидов, ответы на возражения и рекомендации продуктов на основе описанных потребностей потенциального клиента по своей природе не укладываются в сценарий. Агент, который понимает продукт и имеет доступ к данным CRM, намного эффективнее чатбота, следующего ветвящемуся скрипту.
Мультиязычная поддержка в масштабе. LLM нативно обрабатывают несколько языков, поэтому AI-агент может обслуживать клиентов на десятках языков без отдельных NLU-моделей или шаблонов ответов для каждого языка. Чатбот на правилах требует явных многоязычных обучающих данных и шаблонов для каждого поддерживаемого языка. При этом мультиязычные развертывания LLM все равно требуют работы: согласованности терминологии, настройки тона для каждой локали, QA для языков с меньшим объемом ресурсов и проверки комплаенса для региональных требований. Языковая модель снимает инженерную нагрузку на каждый язык, но не устраняет необходимость в контроле локализации.
Сценарии, требующие суждения и эскалации. AI-агент может оценить, достаточно ли он уверен в ответе, обнаружить раздражение клиента через анализ тональности и решить передать обращение человеку с полным контекстом. Такое адаптивное поведение сложно закодировать в конечном автомате.
Подробнее о том, как платформы разговорного ИИ развиваются для поддержки этих сценариев, см. в руководстве по платформам разговорного ИИ.
Как AI-агенты работают в продакшене
Сырая LLM без ограничений была бы непригодна в среде, обращенной к клиентам. Продакшен-AI-агенты настраиваются с несколькими слоями контроля, которые определяют, что агент может говорить, что он может делать и когда должен остановиться и передать диалог человеку. Это не заимствования из архитектуры чатботов, а нативные элементы агентных платформ.
Guardrails и правила поведения. Агент работает в настраиваемых границах: разрешенные темы, ограничения тона и личности, пороги эскалации и утвержденные наборы инструментов. Если клиент спрашивает о теме вне области агента, guardrails определяют, должен ли агент отказать, перенаправить или эскалировать. Это дает операционным командам нужную предсказуемость без жесткого кодирования диалоговых потоков.
Привязка к знаниям (RAG). Чтобы снизить галлюцинации, ответы агента привязываются к курируемой базе знаний через RAG (retrieval-augmented generation). Агент извлекает релевантные документы перед генерацией ответа, а система может отследить, какие исходные документы повлияли на каждый ответ. Подробнее о том, как снижение галлюцинаций работает на практике, см. в статье Что такое галлюцинации ИИ?.
Доступ к инструментам и разрешения на действия. Агент может выполнять действия во внешних системах (создавать тикеты, обрабатывать возвраты средств, обновлять записи, запускать рабочие процессы) через API или серверы MCP. К каким инструментам у агента есть доступ, настраивается для каждого развертывания. Агент поддержки может иметь доступ на чтение к данным заказов и доступ на запись к тикет-системе, но не иметь доступа к изменениям биллинга. Эти разрешения, это продакшен-эквивалент принципа минимальных привилегий.
Quickchat AI Agents, это один из примеров платформы, которая объединяет все три слоя: настраиваемые guardrails, ответы с привязкой к RAG и трассируемостью источников, а также использование инструментов через API и MCP.
Компромиссы стоимости и производительности
Выбор между чатботом и AI-агентом, это отчасти архитектурное решение, а отчасти экономическое.
Экономика чатботов
У чатботов на правилах почти нулевая предельная стоимость на взаимодействие. Инфраструктурная стоимость, это хостинг легкого приложения с базой данных интентов и ответов. Для массовых сценариев низкой сложности по стоимости с этим трудно конкурировать.
Скрытая стоимость находится в обслуживании. Каждый новый сценарий требует инженерного времени на определение интентов, построение потоков, написание шаблонов и интеграцию API. По мере расширения области чатбота эта стоимость обслуживания накапливается. Организации с сотнями интентов часто тратят на обслуживание чатбота больше, чем потратили бы на платформу AI-агента.
Экономика AI-агентов
AI-агенты имеют стоимость на взаимодействие, потому что каждая беседа включает LLM-инференс (оплачиваемый по токенам) плюс накладные расходы на выполнение инструментов. Стоимость одной решенной беседы зависит от длины беседы, числа вызовов инструментов и базовой модели.
Стоимость беседы, решенной AI-агентом, сильно варьируется в зависимости от длины беседы, выбора модели и числа вызовов инструментов, но большинство поставщиков устанавливают цену от $0.30 до $2.00 за решенную беседу. Для сравнения, Gartner оценивает среднюю стоимость обращения в поддержку, обработанного человеком, в $5-$15 в зависимости от канала и сложности. Некоторые опубликованные цены за решение на начало 2026 года: Intercom Fin взимает $0.99 за resolution, Quickchat AI взимает $0.50 за resolution на плане Enterprise, а Salesforce Agentforce взимает $2.00 за conversation.
Экономический расчет смещается в пользу AI-агентов по мере роста сложности бесед. Чатбот на правилах, который может обработать только 40% входящих запросов, все равно направляет оставшиеся 60% людям-агентам. AI-агент с более высоким уровнем решения (поставщики сообщают показатели от 60% до 90%+ в зависимости от домена и качества базы знаний) снижает общую стоимость операций поддержки, даже если каждое отдельное AI-взаимодействие стоит больше, чем взаимодействие с чатботом.
Подробную методику расчета этих компромиссов см. в статье Как рассчитать ROI чатбота.
Измерять успех нужно иначе
Для чатботов и AI-агентов нужны разные подходы к аналитике, потому что они ошибаются по-разному.
Метрики чатботов фокусируются на покрытии: сколько интентов распознается, какой процент сообщений попадает в fallback и как часто пользователи завершают заданный поток. Основной диагностический инструмент, это журнал fallback, который показывает, о чем спрашивают пользователи и с чем чатбот не справляется.
Метрики AI-агентов фокусируются на качестве результата: действительно ли агент решил проблему, был ли клиент удовлетворен, сколько это стоило и был ли ответ основан на точных источниках. Ключевые метрики включают долю решений AI, стоимость одного решения, CSAT по AI-взаимодействиям и тренды тональности по темам.
Подробное руководство по этим метрикам, включая настройку дашбордов и целевые бенчмарки, см. в статье Аналитика чатботов: руководство по KPI, дашбордам и метрикам.
Трассируемость, это еще одно измерение, которое важнее для AI-агентов, чем для чатботов. Поскольку агент генерирует ответы, а не извлекает их из таблицы, вам нужен способ проверить, что его ответы основаны на вашей базе знаний, а не выдуманы. Ищите платформы, которые показывают, какие исходные документы повлияли на каждый ответ, чтобы команды поддержки могли со временем аудировать и улучшать поведение агента.
FAQ
Можно ли преобразовать существующего чатбота в AI-агента?
Не напрямую, потому что архитектуры принципиально различаются. Однако многие активы, которые вы создали для чатбота (контент базы знаний, API-интеграции, базы FAQ), напрямую переносятся в настройку AI-агента. База знаний становится RAG-корпусом, а API-интеграции становятся инструментами, которые агент может вызывать. Вы отказываетесь от таксономии интентов и определений диалоговых потоков, которые LLM заменяет рассуждением во время выполнения.
AI-агенты дороже чатботов?
На одно взаимодействие, да. AI-агенты несут затраты на LLM-инференс, которых нет у чатботов на правилах. Однако AI-агенты обычно решают гораздо больший процент запросов без участия человека (80%+ против 40-60% у традиционных чатботов), что снижает общие затраты на поддержку. Совокупная стоимость владения зависит от объема бесед и смеси по сложности.
Галлюцинируют ли AI-агенты?
Могут. LLM может сгенерировать ответ, который звучит правдоподобно, но фактически неверен. Именно поэтому продакшен-AI-агенты используют RAG (retrieval-augmented generation), чтобы привязать ответы к проверенным исходным материалам, а функции трассируемости, показывающие, какие документы повлияли на каждый ответ, критически важны для продакшен-развертываний.
Может ли AI-агент выполнять задачи, с которыми чатбот не справится?
Да, особенно задачи, которые требуют рассуждения по нескольким источникам данных, многошагового выполнения, обработки новых запросов, не покрытых заранее определенным интентом, и адаптации поведения на основе контекста беседы. Чатбот может выполнять только задачи, которые его разработчики явно предвидели и для которых построили потоки.
Что с задержкой?
Чатботы отвечают за миллисекунды, потому что выполняют lookup. AI-агенты обычно отвечают за 1-5 секунд в зависимости от числа необходимых шагов рассуждения и вызовов инструментов. Для большинства сценариев поддержки клиентов и продаж такая задержка приемлема. Для приложений реального времени, где обязательны ответы менее чем за секунду, может потребоваться чатбот или слой кэшированных ответов.
”AI-агент”, это просто маркетинговый ребрендинг “чатбота”?
Нет. Различие архитектурное. Чатбот следует заранее определенному сценарию. AI-агент рассуждает о задаче во время выполнения и решает, что делать. Это похоже на различие между жестко закодированной программой if/else и системой, которая использует модель машинного обучения для принятия решений. Снаружи они могут выглядеть похоже (обе ведут текстовые беседы), но внутренние механики и возможности различаются.