

Om du utvärderar konversationell AI för support, försäljning eller interna verktyg har du troligen märkt att leverantörer använder “chatbot” och “AI-agent” för att betyda mycket olika saker beroende på vad de säljer. Vissa produkter som kallas “AI-agent” är tunna lager ovanpå en språkmodell utan åtkomst till verktyg. Vissa produkter som kallas “chatbot” gör mer autonomt resonemang än system som kallar sig agenter.
Det här inlägget definierar tre kategorier av konversationella AI-system baserat på deras arkitektur, förklarar vad var och en faktiskt klarar av och går igenom när du ska använda vilken. Målet är att ge dig tillräcklig teknisk grund för att kunna utvärdera produkter utifrån deras faktiska arkitektur i stället för deras varumärkespositionering.
En anmärkning om terminologi
Branschen har inte enats om konsekventa definitioner, så det här inlägget använder tre kategorier:
-
Regelbaserad chatbot: Ett system byggt på intentklassificering, entitetsutvinning och skriptade dialogflöden. Ingen språkmodell används för att generera svar. Det här är den traditionella chatbotarkitekturen som har funnits sedan 2010-talet.
-
LLM-chatbot (eller copilot): Ett system som använder en stor språkmodell för att förstå och generera svar, men som arbetar i ett mönster med förfrågan och svar utan autonom verktygsanvändning eller flerstegsresonemang. Många “AI chatbot”-produkter på marknaden tillhör den här kategorin. De är mer flexibla än regelbaserade chatbotar eftersom LLM:en hanterar öppet språk, men de utför inte åtgärder i externa system och planerar inte flerstegsarbetsflöden.
-
AI-agent: Ett system byggt kring en LLM som kan resonera om uppgifter, använda verktyg, behålla minne mellan interaktioner och köra flerstegsarbetsflöden autonomt. LLM:en arbetar i en loop där den observerar, resonerar, agerar och utvärderar om uppgiften är slutförd.
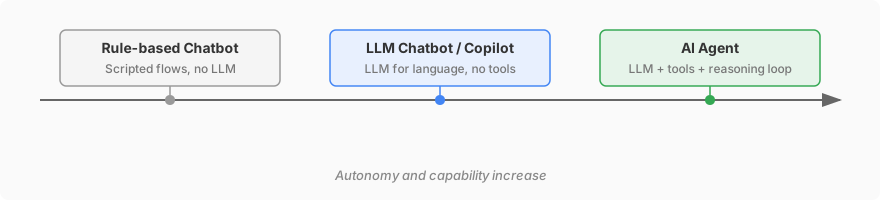 Autonomi och kapacitet ökar från vänster till höger. De flesta “AI chatbot”-produkter 2026 ligger någonstans längs det här spektrumet.
Resten av det här inlägget går igenom alla tre kategorier, även om merparten av den arkitekturella detaljnivån ligger på regelbaserade chatbotar och AI-agenter eftersom de representerar det största gapet. Avsnittet om LLM-chatbotar är kortare eftersom det arkitekturellt är en begränsad version av en AI-agent: samma språkmodell, men utan loopen för verktygsanvändning.
Vad är en regelbaserad chatbot?
En regelbaserad chatbot för samtal med användare via text eller röst med hjälp av fördefinierad logik. Den bygger på en kombination av intentklassificering, entitetsutvinning och skriptade dialogflöden.
Så fungerar regelbaserade chatbotar
Den typiska chatbotarkitekturen har tre komponenter:
-
Natural Language Understanding (NLU): Tolkar användarens meddelande för att identifiera en intent (vad användaren vill) och extrahera entiteter (specifika data som datum, produktnamn eller ordernummer). De flesta NLU-system använder en kombination av regexmönster, nyckelordsmatchning och tränade klassificerare.
-
Dialoghanterare: En tillståndsmaskin som avgör nästa steg baserat på det aktuella konversationstillståndet och den identifierade intenten. Varje tillstånd har en uppsättning möjliga övergångar, och dialoghanteraren följer det definierade flödet.
-
Svarsgenerator: Hämtar ett mallbaserat svar som hör till det aktuella tillståndet. I enkla chatbotar är detta en uppslagstabell. I något mer sofistikerade chatbotar innehåller mallen platser som fylls med extraherade entiteter.
Ett förenklat flöde ser ut så här:
Användare: "Vad är statusen för order #12345?"
  → NLU: intent=order_status, entity={order_id: 12345}
  → Dialoghanterare: state=check_order → call order_status_api(12345)
  → Svar: "Order #12345 skickades den 7 april och väntas framme senast den 11 april."
Arkitekturen ser ut så här:
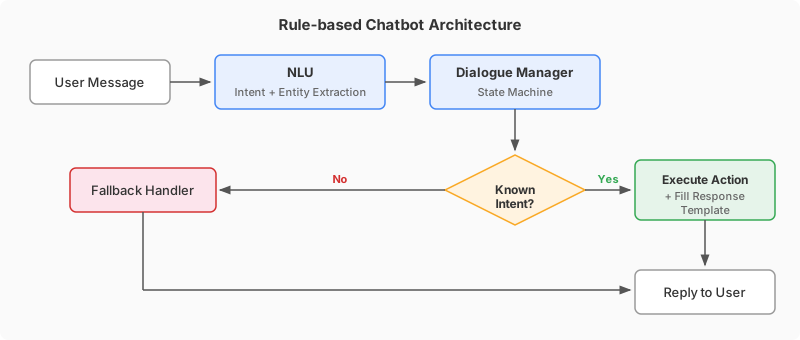
Det här fungerar bra för slutna domänproblem där mängden möjliga intents är liten och väldefinierad. En FAQ-bot, en tidsbokare eller en kontroll av orderstatus kan alla byggas på det här sättet.
Begränsningar i den regelbaserade arkitekturen
Tillståndsmaskinmodellen faller sönder när konversationer blir oförutsägbara. Mer specifikt:
-
Rigid intenttaxonomi: Varje användarförfrågan måste mappas till en fördefinierad intent. Om användaren uttrycker något på ett sätt som NLU-modellen inte har sett hamnar det i en fallback-hanterare. När antalet intents växer blir det en betydande teknisk börda att underhålla taxonomin och undvika överlapp mellan liknande intents.
-
Inget resonemang över flera turer: Dialoghanteraren följer en fast graf. Den kan inte kombinera information från flera turer för att göra en bedömning, väga avvägningar eller anpassa sitt tillvägagångssätt baserat på kontext.
-
Skör entitetsutvinning: Traditionell slotfyllning fungerar för strukturerade indata (datum, nummer, produkt-SKU:er) men har svårt med öppna beskrivningar, tvetydiga referenser eller flerdelade förfrågningar.
-
Linjär skalning av arbetsinsats: Att stödja ett nytt användningsfall innebär att definiera nya intents, nya dialogflöden, nya svarsmallar och ny integrationskod. Varje tillägg ökar underhållsytan proportionellt.
För en djupare genomgång av hur chatbotarkitekturer har utvecklats över åren, se Från NLP-chatbotar till generativ AI.
Vad är en AI-agent?
En AI-agent är ett system byggt kring en stor språkmodell (LLM) som kan resonera om uppgifter, använda verktyg, behålla minne mellan interaktioner och fatta beslut om hur den ska fortsätta utan att följa ett skriptat flöde.
Termen “agent” i det här sammanhanget kommer från AI-forskningstraditionen, där en agent är vilket system som helst som uppfattar sin miljö och vidtar åtgärder för att nå mål. I 2024-2026 års våg av LLM-applikationer avser “AI-agent” specifikt system som använder en LLM som resonemangsmotor i en loop som omfattar observation, planering, verktygskörning och utvärdering.
Så fungerar AI-agenter
Kärnarkitekturen i en AI-agent är en resonemangsloop (ibland kallad ReAct-loop, efter ReAct-artikeln som formaliserade mönstret). Loopen har fyra faser:
-
Observera: Agenten tar emot användarens meddelande tillsammans med konversationshistorik, systeminstruktioner och eventuell hämtad kontext (t.ex. relevanta artiklar i kunskapsbasen).
-
Resonera: LLM:en bearbetar all tillgänglig kontext och beslutar vad som ska göras härnäst. Det kan vara att svara användaren direkt, ställa en förtydligande fråga eller anropa ett verktyg. Resonemangssteget är där agenten skiljer sig mest från en chatbot: i stället för att följa en tillståndsgraf genererar LLM:en en plan baserat på sin förståelse av uppgiften.
-
Agera: Om agenten beslutar att använda ett verktyg genererar den ett strukturerat funktionsanrop (t.ex.
search_knowledge_base(query="refund policy for damaged items")ellercreate_ticket(customer_id=456, issue="shipping delay")). Systemet kör funktionen och returnerar resultatet till agenten. -
Utvärdera: Agenten granskar verktygets utdata och beslutar om uppgiften är slutförd eller om ytterligare ett steg behövs. Om mer arbete krävs upprepas loopen från resonemangsfasen.
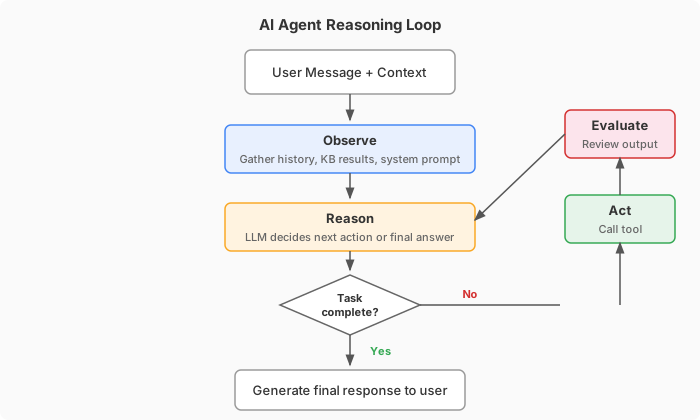
Här är ett konkret exempel på loopen i praktiken:
Användare: "Jag beställde en laptop förra veckan men fick en skärm i stället.
       Jag behöver få rätt vara skickad och en returfraktsedel för skärmen."

Agentens resonemangsloop:
  [Reason] Användaren har två behov: leverans av rätt vara + returfraktsedel.
           Behöver slå upp ordern först.
  [Act]    lookup_order(customer_email="user@example.com", timeframe="7d")
           → Returnerar: Order #7891, laptop SKU-A100, skickad skärm SKU-B200
  [Reason] Order hittad. Fel vara bekräftad. Behöver initiera byte
           och generera returfraktsedel.
  [Act]    initiate_exchange(order_id=7891, correct_sku="SKU-A100")
           → Returnerar: Byte #EX-442 skapat, skickas inom 1-2 dagar
  [Act]    generate_return_label(order_id=7891, item_sku="SKU-B200")
           → Returnerar: Etikett-URL https://...
  [Evaluate] Båda uppgifterna slutförda. Skriv svar.

Agent: "Jag hittade din order #7891. Rätt laptop (SKU-A100) skickas
        inom 1-2 arbetsdagar. Här är returfraktsedeln för skärmen:
        [länk]. Lämna in den hos valfritt transportombud."
Den viktigaste skillnaden jämfört med chatbotmetoden: ingen behövde fördefiniera en “order_wrong_item_exchange_and_return”-intent eller bygga ett specifikt dialogflöde för detta scenario. Agenten delade upp problemet, anropade rätt verktyg i rätt ordning och skrev ett svar.
Verktygsanvändning och funktionsanrop
Verktygsanvändning (även kallat funktionsanrop) är det som ger AI-agenter förmågan att agera i världen i stället för att bara generera text. LLM:en får en lista över tillgängliga verktyg med deras scheman (parameternamn, typer, beskrivningar) och kan välja att anropa vilket som helst av dem under resonemangsloopen.
Vanliga verktygskategorier för kundnära AI-agenter är:
| Kategori | Exempel |
|---|---|
| Kunskapshämtning | Sök i kunskapsbas, slå upp FAQ, hämta produktdokumentation |
| Datauppslagning | Kontrollera orderstatus, hämta kontouppgifter, fråga lagerstatus |
| Skrivåtgärder | Skapa supportärende, uppdatera kundpost, behandla återbetalning |
| Kommunikation | Skicka e-post, utlös SMS, publicera till Slack |
| Eskalering | Överför till mänsklig agent med full konversationskontext |
Verktygsschemat fungerar som kontraktet mellan LLM:en och det externa systemet. Ett väl utformat schema ger LLM:en tillräcklig information för att välja rätt verktyg och ange korrekta parametrar utan ytterligare promptning.
För att se verktygsanvändning byggd från grunden lägger vår steg-för-steg-guide om att bygga en AI-agent som utför verkliga åtgärder till exakt ett sådant verktyg, en beskriven HTTP-begäran som agenten anropar mitt i konversationen, gratis och utan kod. För att få dessa skrivåtgärder att köras i rätt ordning, och först när ordern har slagits upp, lägger du till ett körvillkor och skickar vidare id:t.
Minne och kontexthantering
Chatbotar lagrar vanligtvis konversationstillstånd som en uppsättning ifyllda slots (t.ex. order_id=12345, intent=order_status). AI-agenter behöver en rikare minnesmodell eftersom de hanterar öppna konversationer där relevant information kan dyka upp när som helst.
De flesta implementationer av AI-agenter använder flera lager av kontext:
- Konversationshistorik: Den råa sekvensen av meddelanden i den aktuella sessionen.
- Arbetsminne: Mellanresultat från verktygsanrop och resonemangssteg som informerar efterföljande beslut.
- Hämtad kontext: Kunskapsbasartiklar, produktdokumentation eller kundposter som hämtas via retrieval-augmented generation (RAG) baserat på den aktuella frågan.
- Långtidsminne (valfritt): Bestående fakta om användaren eller kontot som följer med mellan sessioner (t.ex. föredraget språk, tidigare problem, prenumerationsnivå).
Att hantera kontext inom LLM:ens tokenfönster är en verklig ingenjörsutmaning. När konversationer blir längre och fler verktyg anropas kan kontexten överskrida modellens kapacitet. Strategier som sammanfattning, glidande fönster och selektiv hämtning hjälper till att hålla agenten fungerande utan att förlora kritisk information.
Mellanläget: LLM-chatbotar och copilots
De flesta produkter som marknadsförs som “AI chatbots” 2026 hamnar i en kategori mellan regelbaserade chatbotar och fullständiga AI-agenter. Dessa system använder en LLM för att förstå användarindata och generera svar på naturligt språk, men de har inte åtkomst till verktyg och kör inte flerstegsarbetsflöden autonomt.
En typisk LLM-chatbot fungerar så här: användaren skickar ett meddelande, systemet hämtar relevant kontext från en kunskapsbas (via RAG), skickar meddelandet och kontexten till en LLM och returnerar det genererade svaret. Det finns ingen resonemangsloop, inget verktygsval och ingen iterativ körning. Varje användarmeddelande utlöser ett enda LLM-anrop.
Den här arkitekturen är en betydande förbättring jämfört med regelbaserade chatbotar. LLM:en hanterar öppet språk utan att behöva en fördefinierad intenttaxonomi, genererar naturliga svar i stället för att fylla mallar och kan fungera på alla språk som modellen stöder. För rena Q&A-användningsfall där målet är att svara på frågor från en kunskapsbas kan en LLM-chatbot vara allt du behöver.
Begränsningen visar sig när användaren behöver att systemet gör något: slår upp en order, skapar ett ärende, behandlar en återbetalning, kontrollerar lagerstatus eller koordinerar mellan flera datakällor. En LLM-chatbot kan bara föreslå att användaren själv utför dessa åtgärder eller eskalera till en människa. En AI-agent kan utföra dem direkt.
I praktiken är gränsen mellan LLM-chatbot och AI-agent inte alltid skarp. Om du lägger till ett enda verktyg (t.ex. orderuppslagning) i en LLM-chatbot flyttas den mot agentänden av spektrumet. Skillnaden handlar mer om grad av autonomi än om en hård gräns. Med det sagt spelar den arkitekturella skillnaden roll: en LLM-chatbot utan resonemangsloop bearbetar en förfrågan i taget, medan en agent kan kedja flera observationer och åtgärder för att lösa sammansatta problem.
Jämförelse sida vid sida
| Dimension | Regelbaserad chatbot | LLM-chatbot / Copilot | AI-agent |
|---|---|---|---|
| Kärnmotor | NLU-klassificerare + tillståndsmaskin | LLM (en tur) | LLM med resonemangsloop |
| Svarsgenerering | Malluppslagning / slotfyllning | Genereras från kontext | Genereras från kontext + verktygsresultat |
| Konversationsflöde | Fördefinierad dialoggraf | Öppet, men ett utbyte i taget | Dynamiskt, flerstegsbaserat, bestäms vid körning |
| Verktygsanvändning | Hårdkodade API-anrop per intent | Ingen | LLM väljer verktyg från tillgänglig uppsättning |
| Flerstegsuppgifter | Kräver explicit flöde för varje väg | Kan inte kedja åtgärder | Delar upp uppgifter autonomt |
| Hantering av nya förfrågningar | Fallback / “Jag förstår inte” | Kan svara om kontext finns i KB | Resonerar från kontext + vidtar åtgärd |
| Kunskapsåtkomst | Nyckelordssökning eller exakt matchning | RAG med semantisk sökning | RAG med semantisk sökning och reranking |
| Underhållsmodell | Lägg till intents, flöden, mallar per användningsfall | Uppdatera kunskapsbas | Utöka verktygsuppsättning och kunskapsbas |
| Kostnadsstruktur | Låg beräkningskostnad (ingen LLM-inferens) | LLM-kostnad per token | LLM-kostnad per token + verktygskörning |
| Felläge | Tyst felrouting eller fallback | Hallucination | Hallucination, felaktig verktygsanvändning |
| Latens | Snabb (uppslagsbaserad) | 1-3 sekunder (ett LLM-anrop) | Variabel (beror på resonemangssteg) |
Är regelbaserade chatbotar fortfarande rimliga?
För de flesta användningsfall 2026, nej. AI-agenter har blivit tillräckligt bra, tillräckligt billiga och tillräckligt tillförlitliga för att det är svårt att motivera att starta ett nytt projekt med en regelbaserad chatbot. En AI-agent hanterar allt en chatbot kan (FAQ, enkla uppslagningar, datainsamling) samtidigt som den också hanterar den långa svansen av förfrågningar som chatbotar inte klarar. Underhållsbördan är också lägre: i stället för att definiera intents och flöden för varje nytt användningsfall utökar du en kunskapsbas och lägger till verktyg.
Det finns några smala situationer där en regelbaserad chatbot fortfarande kan vara det pragmatiska valet:
Regulatoriska begränsningar som kräver deterministiska, förhandsgodkända svar. I vissa reglerade branscher (hälso- och sjukvårdsinformation, finansiell efterlevnad) måste varje svar granskas och godkännas före driftsättning. En chatbot med mallbaserade svar uppfyller detta genom sin utformning. AI-agenter kan begränsas med guardrails, men utdata genereras fortfarande och är inte förhandsgodkända ord för ord.
Extrem kostnadskänslighet i mycket stor skala. Om du hanterar tiotals miljoner enkelinteraktioner per månad och användningsfallet verkligen är enkelt (t.ex. kontrollera ett saldo, bekräfta en bokning) är kostnaden för LLM-inferens per interaktion kanske inte värd det. Den här tröskeln fortsätter att flyttas när modellkostnader sjunker, men i början av 2026 finns den fortfarande vid mycket höga volymer.
Äldre system utan migreringsväg. Vissa organisationer har regelbaserade chatbotar som är djupt integrerade i infrastrukturen utan budget eller tidsplan för att ersätta dem. I dessa fall är frågan inte “vilket är bättre” utan “vad kan vi göra just nu.”
Utanför dessa undantagsfall är en AI-agent det bättre standardvalet. Frågan har gått från “ska vi använda en AI-agent eller en chatbot” till “hur konfigurerar och begränsar vi vår AI-agent för vår specifika domän.”
Där AI-agenter är starkast
AI-agenter passar tydligt för de flesta nya projekt inom konversationell AI 2026. Några scenarier där gapet mellan agenter och regelbaserade chatbotar är störst:
Komplexa supportärenden som spänner över flera system. Orderbytesexemplet ovan är typiskt. Användaren har ett sammansatt problem som kräver datauppslagning, beslut och flera åtgärder. En chatbot skulle behöva ett särskilt flöde för varje möjlig kombination av problem.
Öppna produktfrågor. “Vilken plan passar ett team på 15 personer som behöver WhatsApp-integration och HIPAA-efterlevnad?” kräver resonemang över produktdokumentation, prisregler och efterlevnadskrav. En agent kan hämta relevanta dokument och syntetisera ett svar. En chatbot skulle behöva en omöjligt stor intenttaxonomi för att täcka alla möjliga produktfrågor.
Försäljningssamtal. Att kvalificera leads, besvara invändningar och rekommendera produkter baserat på en prospekts beskrivna behov är i grunden oskriptat. En agent som förstår produkten och kan komma åt CRM-data är betydligt mer effektiv än en chatbot som följer ett förgrenat skript.
Flerspråkig support i stor skala. LLM:er hanterar flera språk nativt, så en AI-agent kan betjäna kunder på dussintals språk utan separata NLU-modeller eller svarsmallar för varje språk. En regelbaserad chatbot kräver explicit flerspråkig träningsdata och mallar för varje språk som stöds. Med det sagt kräver flerspråkiga LLM-driftsättningar fortfarande arbete: terminologisk konsekvens, tonkalibrering per locale, QA för språk med mindre data och efterlevnadsgranskning för regionspecifika regler. Språkmodellen tar bort den språkspecifika tekniska bördan, men den eliminerar inte behovet av lokaliseringsöversyn.
Scenarier som kräver omdöme och eskalering. En AI-agent kan bedöma om den har tillräckligt hög tillit till sitt svar, upptäcka kundfrustration genom sentimentanalys och besluta att eskalera till en människa med full kontext. Detta adaptiva beteende är svårt att koda i en tillståndsmaskin.
För bakgrund om hur plattformar för konversationell AI utvecklas för att stödja dessa användningsfall, se Guide till plattformar för konversationell AI.
Så fungerar AI-agenter i produktion
En rå LLM utan begränsningar skulle vara oanvändbar i en kundnära miljö. Produktionssatta AI-agenter konfigureras med kontrollager som avgör vad agenten får säga, vad den får göra och när den ska stoppa och lämna över till en människa. Dessa lager är inte lånade från chatbotarkitektur, de är inbyggda i hur agentplattformar fungerar.
Guardrails och beteenderegler. Agenten arbetar inom konfigurerbara gränser: tillåtna ämnen, begränsningar för ton och personlighet, eskaleringströsklar och godkända verktygsuppsättningar. Om en kund frågar om ett ämne utanför agentens omfattning avgör guardrails om agenten avböjer, styr om eller eskalerar. Detta ger driftteam den förutsägbarhet de behöver utan att hårdkoda dialogflöden.
Kunskapsförankring (RAG). För att minska hallucination förankras agentens svar i en kuraterad kunskapsbas via RAG (retrieval-augmented generation). Agenten hämtar relevanta dokument innan den genererar ett svar, och systemet kan spåra vilka källdokument som påverkade varje svar. Mer om hur hallucinationsminskning fungerar i praktiken finns i Vad är AI-hallucinationer?.
Verktygsåtkomst och åtgärdsbehörigheter. Agenten kan vidta åtgärder i externa system (skapa ärenden, behandla återbetalningar, uppdatera poster, utlösa arbetsflöden) via API:er eller MCP-servrar. Vilka verktyg agenten har åtkomst till konfigureras per driftsättning. En supportagent kan ha läsåtkomst till orderdata och skrivåtkomst till ärendehanteringssystemet, men ingen åtkomst till faktureringsändringar. Dessa behörigheter är produktionsmotsvarigheten till principen om minsta privilegium.
Quickchat AI Agents är ett exempel på en plattform som kombinerar alla tre lager: konfigurerbara guardrails, RAG-förankrade svar med källspårbarhet och verktygsanvändning via API:er och MCP.
Avvägningar mellan kostnad och prestanda
Valet mellan chatbot och AI-agent är delvis ett arkitekturbeslut och delvis ett ekonomiskt beslut.
Chatbotekonomi
Regelbaserade chatbotar har nästan noll marginalkostnad per interaktion. Infrastrukturkostnaden är att hosta en lättviktig applikation med en databas över intents och svar. För användningsfall med hög volym och låg komplexitet är detta svårt att slå kostnadsmässigt.
Den dolda kostnaden ligger i underhållet. Varje nytt användningsfall kräver ingenjörstid för att definiera intents, bygga flöden, skriva mallar och integrera API:er. När chatbotens omfattning växer ackumuleras denna underhållskostnad. Organisationer med hundratals intents lägger ofta mer på chatbotunderhåll än de skulle göra på en AI-agentplattform.
AI-agentekonomi
AI-agenter medför kostnader per interaktion eftersom varje konversation involverar LLM-inferens (debiterad per token) plus eventuell overhead för verktygskörning. Kostnaden per löst konversation varierar beroende på konversationens längd, antalet verktygsanrop och den underliggande modellen.
Kostnaden per AI-agentlöst konversation varierar mycket beroende på konversationens längd, modellval och antal verktygsanrop, men de flesta leverantörer tar mellan $0.30 och $2.00 per löst konversation. Som jämförelse uppskattar Gartner den genomsnittliga kostnaden för en supportinteraktion hanterad av en människa till $5-$15 beroende på kanal och komplexitet. Några publicerade priser per lösning i början av 2026: Intercom Fin tar $0.99 per lösning, Quickchat AI tar $0.50 per lösning i sin Enterprise-plan, och Salesforce Agentforce tar $2.00 per konversation.
Den ekonomiska kalkylen förskjuts till AI-agenters fördel när konversationskomplexiteten ökar. En regelbaserad chatbot som bara kan hantera 40% av inkommande förfrågningar routar fortfarande resterande 60% till mänskliga agenter. En AI-agent med högre lösningsgrad (leverantörer rapporterar siffror från 60% till 90%+ beroende på domän och kunskapsbasens kvalitet) minskar den totala kostnaden för supportverksamheten även om varje enskild AI-interaktion kostar mer än en chatbotinteraktion.
För ett detaljerat ramverk för att beräkna dessa avvägningar, se Så beräknar du chatbot-ROI.
Att mäta framgång på olika sätt
Chatbotar och AI-agenter kräver olika analysmetoder eftersom de misslyckas på olika sätt.
Chatbotmätetal fokuserar på täckning: hur många intents som känns igen, vilken procentandel av meddelanden som hamnar i fallback och hur ofta användare slutför det definierade flödet. Det primära diagnostikverktyget är fallback-loggen, som visar vad användare frågar som chatboten inte kan hantera.
AI-agentmätetal fokuserar på resultatkvalitet: löste agenten faktiskt problemet, var kunden nöjd, vad kostade det och var svaret förankrat i korrekta källor. Viktiga mätetal omfattar AI-lösningsgrad, kostnad per lösning, CSAT per AI-interaktion och sentimenttrender per ämne.
För en heltäckande guide till dessa mätetal, inklusive hur du sätter upp dashboards och vilka benchmarks du bör sikta på, se Chatbotanalys: guide till KPI:er, dashboards och mätetal.
Spårbarhet är en annan dimension som är viktigare för AI-agenter än för chatbotar. Eftersom agenten genererar svar i stället för att slå upp dem behöver du ett sätt att verifiera att dess svar är förankrade i din kunskapsbas och inte fabricerade. Leta efter plattformar som visar vilka källdokument som påverkade varje svar, så att supportteam kan granska och förbättra agentens beteende över tid.
FAQ
Kan jag konvertera min befintliga chatbot till en AI-agent?
Inte direkt, eftersom arkitekturerna i grunden är olika. Däremot kan många av de tillgångar du byggt för din chatbot (innehåll i kunskapsbasen, API-integrationer, FAQ-databaser) överföras direkt till en AI-agentuppsättning. Kunskapsbasen blir RAG-korpusen, och API-integrationerna blir verktyg som agenten kan anropa. Det du kasserar är intenttaxonomin och definitionerna av dialogflöden, som LLM:en ersätter med resonemang vid körning.
Är AI-agenter dyrare än chatbotar?
Per interaktion, ja. AI-agenter medför kostnader för LLM-inferens som regelbaserade chatbotar inte har. AI-agenter löser dock vanligtvis en mycket högre andel förfrågningar utan mänsklig inblandning (80%+ jämfört med 40-60% för traditionella chatbotar), vilket minskar de totala supportkostnaderna. Den totala ägandekostnaden beror på din konversationsvolym och komplexitetsmix.
Hallucinerar AI-agenter?
Det kan de göra. En LLM kan generera ett svar som låter plausibelt men är faktamässigt felaktigt. Därför använder produktionssatta AI-agenter RAG (retrieval-augmented generation) för att förankra svar i verifierat källmaterial, och därför är spårbarhetsfunktioner som visar vilka dokument som informerade varje svar kritiska för produktionsdriftsättningar.
Kan en AI-agent hantera uppgifter som en chatbot inte kan?
Ja, särskilt uppgifter som kräver resonemang över flera datakällor, flerstegskörning, hantering av nya förfrågningar som inte täcks av en fördefinierad intent och anpassning av beteende baserat på konversationskontext. En chatbot kan bara hantera uppgifter som dess designers uttryckligen förutsåg och byggde flöden för.
Hur är det med latens?
Chatbotar svarar på millisekunder eftersom de gör en uppslagning. AI-agenter svarar vanligtvis på 1-5 sekunder beroende på antalet resonemangssteg och verktygsanrop som krävs. För de flesta användningsfall inom kundsupport och försäljning är denna latens acceptabel. För realtidsapplikationer där svar under en sekund är obligatoriska kan en chatbot eller ett cachelagrat svarslager vara nödvändigt.
Är “AI-agent” bara en marknadsföringsrebranding av “chatbot”?
Nej. Skillnaden är arkitekturell. En chatbot följer ett fördefinierat skript. En AI-agent resonerar om uppgiften vid körning och beslutar vad den ska göra. Detta liknar skillnaden mellan ett hårdkodat if/else-program och ett system som använder en maskininlärningsmodell för att fatta beslut. De kan se liknande ut utifrån (båda för textkonversationer), men de interna mekanismerna och kapaciteterna är olika.