


Si estás evaluando IA conversacional para soporte, ventas o herramientas internas, seguramente has notado que los proveedores usan «chatbot» y «agente de IA» con significados muy distintos. Algunos productos llamados agentes son simples interfaces de un modelo de lenguaje sin acceso a herramientas. Algunos chatbots realizan más razonamiento autónomo que los sistemas que se presentan como agentes.
Un chatbot es una interfaz conversacional; un agente de IA es una forma de controlar el trabajo que ocurre detrás. Un chatbot con un flujo programado puede llamar a APIs y conservar estado. Un agente puede elegir su siguiente paso entre las herramientas permitidas, pero eso no establece la identidad del usuario, autoriza una escritura ni demuestra que la tarea haya terminado correctamente. Este artículo compara tres arquitecturas y utiliza una solicitud de devolución hipotética para concretar esos límites.
Una nota sobre la terminología
No hay definiciones uniformes en el sector, así que aquí usamos tres categorías de trabajo, sin tratar las etiquetas comerciales como especificaciones:
-
Chatbot basado en reglas: La clasificación de intenciones, la extracción de entidades y los flujos de diálogo programados seleccionan el siguiente paso. Las respuestas usan plantillas en lugar de un LLM. El flujo puede conservar estado, llamar a APIs y exigir aprobaciones.
-
Chatbot LLM que solo responde: Un modelo de lenguaje contesta a partir del contexto proporcionado, a menudo recuperado de una base de conocimiento. En el ejemplo de este artículo no tiene herramientas de acción. Otros productos llamados chatbots o copilotos pueden incorporar herramientas, varias llamadas al modelo y aprobaciones humanas.
-
Agente de IA: Un LLM selecciona pasos y herramientas dentro de un bucle configurado y utiliza las observaciones para decidir cómo continuar. La memoria, los permisos, las condiciones de parada y la revisión humana dependen de la implementación. La autonomía está limitada por las herramientas y la autoridad que el sistema realmente proporciona.
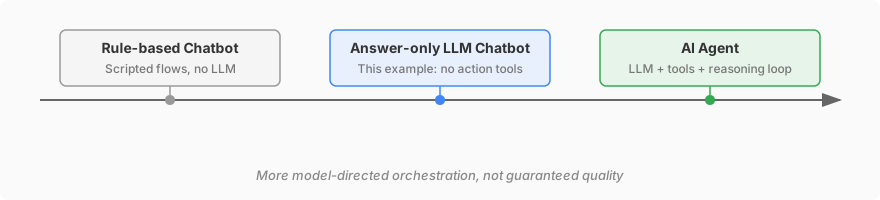 Son ejemplos esquemáticos. Una mayor orquestación dirigida por el modelo no garantiza más precisión, menores costes ni un resultado empresarial completado.
Una distinción arquitectónica útil es quién elige el siguiente paso: la lógica predefinida de la aplicación o el modelo. La guía de Anthropic sobre flujos y agentes utiliza esa distinción y recomienda empezar por la solución más sencilla que cubra la tarea. Los sistemas híbridos pueden combinar ambas opciones.
Imagina que un cliente dice: «He recibido el artículo equivocado. ¿Cuál es vuestra política de devoluciones y podéis iniciar una devolución?». Lo siguiente es un ejemplo de diseño hipotético, no una ejecución grabada de Quickchat AI ni un flujo de reembolso integrado.
| Etapa | Trabajo permitido | Evidencia necesaria antes de afirmar que se ha completado |
|---|---|---|
| Responder sobre la política | Recuperar la política publicada sin revelar datos privados del pedido | La fuente de la política aplicable; responder no demuestra que este pedido cumpla los requisitos |
| Consultar el pedido | Usar un contexto de cliente autenticado y una API que controle el acceso al pedido correspondiente | Una respuesta autorizada con los campos necesarios; un correo o número de pedido escrito en el chat no es autenticación |
| Solicitar una devolución | Comprobar por separado el permiso de escritura, las condiciones de la política y cualquier confirmación requerida del cliente | Un resultado confirmado del sistema de devoluciones, como el identificador de una solicitud aceptada; no equivale a un reembolso pagado ni a una devolución completada |
| Derivar una excepción | Detenerse si falta autoridad, hay excepciones no admitidas o el resultado de una escritura es incierto | Una solicitud de derivación registrada y su destino o cola conocidos; no prometer que una persona ya ha respondido |
Un flujo determinista puede implementar las cuatro etapas. Un sistema que solo responde puede explicar la política y dirigir al cliente a un servicio autenticado. Un agente puede elegir entre pasos configurados, pero debe cumplir los mismos requisitos de acceso y evidencia.
Qué es un chatbot basado en reglas
Un chatbot basado en reglas conversa por texto o voz mediante lógica predefinida. Combina clasificación de intenciones, extracción de entidades y flujos de diálogo programados.
Cómo funcionan los chatbots basados en reglas
Una arquitectura típica de chatbot tiene tres componentes:
-
Comprensión del lenguaje natural (NLU): Analiza el mensaje para identificar la intención del usuario y extraer entidades, como fechas, productos o números de pedido. Muchos sistemas NLU combinan expresiones regulares, coincidencias de palabras clave y clasificadores entrenados.
-
Gestor de diálogo: Una máquina de estados determina el siguiente paso a partir del estado de la conversación y de la intención reconocida. Cada estado tiene transiciones posibles y el gestor sigue el flujo definido.
-
Generador de respuestas: Recupera una plantilla asociada al estado actual. En chatbots sencillos es una tabla de consulta; en otros, la plantilla contiene campos que se rellenan con las entidades extraídas.
Después de que el servicio autentique al cliente y compruebe su acceso al pedido, un flujo hipotético simplificado sería:
Usuario: «¿Cuál es el estado del pedido #12345?»
  → NLU: intent=order_status, entity={order_id: 12345}
  → Gestor de diálogo: state=check_order → llamada autorizada order_status_api(12345)
  → Respuesta: «El pedido #12345 se envió el 7 de abril y se espera para el 11 de abril».
La arquitectura es la siguiente:

Funciona bien para problemas de dominio acotado, con un conjunto pequeño y bien definido de intenciones. Un bot de preguntas frecuentes, un programador de citas o una consulta de estado de pedidos pueden construirse así.
Limitaciones de la arquitectura basada en reglas
Una máquina de estados necesita gestionar explícitamente las rutas admitidas. Sus límites prácticos dependen del clasificador, el diseño del flujo y la cobertura de las integraciones:
-
Cobertura de intenciones: Las solicitudes deben corresponder a una intención admitida o a una ruta alternativa. Una formulación poco habitual puede clasificarse mal, aunque un clasificador entrenado puede generalizar más allá de frases exactas. Las intenciones superpuestas requieren evaluación y mantenimiento.
-
Ramificaciones predefinidas: El gestor puede combinar información almacenada de varios turnos y ramificar a partir de ella. Los nuevos tipos de decisión necesitan reglas u otro componente de decisión; el grafo no inventa un flujo nuevo durante la ejecución.
-
Extracción de entidades frágil: El rellenado tradicional de campos funciona con entradas estructuradas, como fechas, números o SKU, pero tiene dificultades con descripciones abiertas, referencias ambiguas o solicitudes con varias partes.
-
Mantenimiento del flujo: Los nuevos casos pueden exigir intenciones, ramas, plantillas o integraciones adicionales. Reutilizar componentes ayuda, pero hay que medir el esfuerzo de mantenimiento en lugar de asumir un crecimiento fijo.
Para profundizar en la evolución de estas arquitecturas, consulta De los chatbots NLP a la IA generativa.
Qué es un agente de IA
Aquí, un agente de IA es un sistema en el que un LLM elige el siguiente paso o herramienta según la tarea y las observaciones. Puede funcionar dentro de un flujo programado más amplio. La memoria persistente y el permiso para modificar sistemas externos son capacidades opcionales, no consecuencias de la etiqueta.
El término «agente» también tiene una historia más amplia en la investigación de IA: un sistema percibe su entorno y actúa para alcanzar un objetivo. Este artículo se centra en la orquestación basada en LLM, donde observación, planificación, ejecución de herramientas y evaluación pueden repetirse hasta alcanzar una condición de parada.
Cómo funcionan los agentes de IA
La arquitectura central es un bucle de razonamiento, también llamado bucle ReAct por el artículo de ReAct que formalizó el patrón. El bucle tiene cuatro fases:
-
Observar: El agente recibe el mensaje junto con el historial, las instrucciones del sistema y el contexto recuperado, como artículos relevantes de la base de conocimiento.
-
Razonar: El LLM utiliza el contexto para seleccionar una respuesta, una aclaración o una llamada a una herramienta. A diferencia de una transición fija de un grafo, esta selección se realiza durante la ejecución. Puede ser incorrecta y necesita evaluación.
-
Actuar: El modelo propone una llamada estructurada, como
search_knowledge_base(query="return policy")ocreate_return_request(order_id=12345). Los controles de la aplicación y la API de destino deben imponer la operación y el alcance permitidos antes de ejecutarla. Una llamada propuesta no constituye autorización. -
Evaluar: El sistema examina el resultado y decide si continúa, responde o se detiene para revisión humana. Que el modelo considere terminada la tarea no demuestra de forma independiente que una operación empresarial haya tenido éxito. Limita el bucle y verifica el estado externo cuando sea necesario.

El mismo caso de devolución puede expresarse como un flujo de control propuesto. No se ejecutó ninguna de estas llamadas ni se observaron estos resultados. Los nombres de las operaciones son ilustrativos, no una configuración de Quickchat AI que puedas pegar en una cuenta.
Cliente: «He recibido el artículo equivocado. ¿Podéis iniciar una devolución?»

[Política] Recuperar la política aplicable y citar sus condiciones.
[Lectura]  Exigir contexto de cliente autenticado y acceso a ese pedido.
           Consultar el pedido correspondiente mediante el servicio autorizado.
           Tratar «artículo equivocado recibido» como relato del cliente hasta verificarlo.
[Control]  Comprobar política, autoridad de escritura y confirmación requerida.
           Si falta una condición, pedir aclaración o derivar a una persona.
[Escritura] Enviar la solicitud solo después de superar el control de escritura separado.
[Comprobación] Comunicar la aceptación solo si el resultado externo la confirma.
           Una solicitud aceptada no significa que se haya pagado un reembolso.
           Ante un resultado incierto, consultar el estado o derivar; no repetir a ciegas.
[Derivación] Registrar hechos pendientes y cola o destinatario conocidos.
           No afirmar que una persona ya ha respondido.
La parte agéntica consiste en elegir el siguiente paso permitido según el contexto. El servicio sigue necesitando herramientas definidas, reglas de política, comprobaciones de identidad y manejo de errores. Un flujo fijo podría realizar las mismas operaciones; la arquitectura cambia la orquestación, no la autoridad del cliente.
Uso de herramientas y llamadas de función
El uso de herramientas, o llamada a funciones, conecta un modelo con consultas u operaciones externas. El LLM recibe esquemas con nombres, tipos y descripciones de parámetros. Puede proponer una llamada entre las disponibles; la aplicación decide si está permitida y cómo se expone el resultado.
Las categorías habituales para agentes orientados al cliente incluyen:
| Categoría | Ejemplos |
|---|---|
| Recuperación de conocimiento | Buscar en la base de conocimiento, consultar preguntas frecuentes y documentación |
| Consulta de datos | Consultar estado de pedidos, datos de cuenta o inventario |
| Operaciones de escritura | Crear una solicitud de devolución o un ticket, actualizar un campo permitido; cada operación requiere su propia autoridad |
| Comunicación | Enviar correo, activar un SMS o publicar en Slack |
| Escalado | Solicitar revisión humana con contexto relevante y una cola o destinatario conocidos |
Un esquema describe la forma de la llamada; no autentica al cliente ni aplica la política comercial. Valida parámetros y acceso en el destino, limita los campos expuestos y distingue las lecturas de las operaciones que cambian estado. Las instrucciones del prompt no son por sí solas una frontera de seguridad.
El tutorial para crear un agente de IA que realiza acciones reales explica una petición HTTP descrita que se llama durante la conversación. La continuación sobre ordenar Actions mediante condiciones y resultados guardados muestra Run only when y Save to memory. Esos controles no establecen la identidad del cliente ni hacen idempotente una escritura: siguen siendo necesarios los metadatos fiables y la autorización en destino. Los enlaces conservan el contexto de sus propias demos; el flujo hipotético de devolución de este artículo no se ha probado.
Memoria y gestión del contexto
Un chatbot programado puede guardar campos como order_id=12345 e intent=order_status, además del historial u otro estado. Los agentes suelen combinar distintas clases de contexto para solicitudes abiertas. Ninguna arquitectura proporciona automáticamente una memoria segura entre sesiones.
Entre las capas útiles de contexto están:
- Historial de conversación: La secuencia de mensajes de la sesión actual sin resumir.
- Memoria de trabajo: Resultados intermedios de herramientas y pasos de razonamiento que orientan decisiones posteriores.
- Contexto recuperado: Artículos, documentación o registros de clientes obtenidos mediante generación aumentada por recuperación (RAG) para la consulta actual.
- Memoria a largo plazo (opcional): Datos persistentes del usuario o de la cuenta entre sesiones, como idioma preferido, incidencias anteriores o nivel de suscripción.
La ventana de contexto del LLM impone una restricción técnica. Los resúmenes, las ventanas deslizantes y la recuperación selectiva pueden reducir su tamaño, pero omitir detalles importantes. Conserva identidad, permisos y estado transaccional autorizado en sistemas fiables en lugar de depender de un resumen del modelo.
El punto intermedio: chatbots LLM y copilotos
Un chatbot LLM que solo responde puede recuperar conocimiento, pasarlo junto con el mensaje a un modelo y devolver la respuesta. Este diseño sencillo no tiene un bucle de acciones dirigido por el modelo. Es un patrón de implementación, no la definición de todos los chatbots o copilotos.
Para preguntas sobre políticas, un sistema de recuperación y respuesta puede ser suficiente. Puede manejar distintas formulaciones sin crear una intención para cada una. Aun así, hay que evaluar la calidad de recuperación, las lenguas admitidas y la calidad de las fuentes.
En el ejemplo de devolución, un sistema que solo responde explica la política publicada, pero no consulta datos privados del pedido ni crea una solicitud. Si hacen falta esas operaciones, añade un flujo autenticado o herramientas debidamente restringidas. Una integración programada también puede realizarlas.
También son posibles diseños híbridos: un LLM clasifica la solicitud, un flujo determinista impone las comprobaciones y un modelo redacta la respuesta. Evalúa dónde se toman decisiones, qué operaciones se permiten y qué evidencia se devuelve, en lugar de deducirlo de las etiquetas «chatbot», «copiloto» o «agente».
Comparación lado a lado
La columna central describe el ejemplo que solo responde de este artículo. RAG, el estado persistente y el acceso a APIs pueden combinarse con otras arquitecturas.
| Dimensión | Chatbot basado en reglas | Chatbot LLM que solo responde | Agente de IA |
|---|---|---|---|
| Motor central | Clasificador de intenciones y lógica predefinida | LLM con un flujo de recuperación y respuesta | LLM que selecciona pasos en un bucle controlado |
| Generación de respuestas | Plantillas y valores guardados | Generadas a partir del contexto suministrado | Generadas a partir del contexto y los resultados disponibles |
| Flujo de conversación | Transiciones definidas con estado entre turnos | Responder o aclarar dentro del flujo configurado | El modelo elige el siguiente paso permitido |
| Uso de herramientas | El flujo puede incluir llamadas a APIs | Sin herramientas de acción en este ejemplo | El modelo propone llamadas; la aplicación aplica controles de acceso |
| Tareas de varios pasos | Secuencia y ramas explícitas | Requiere un flujo adicional para operaciones externas | Puede seleccionar una secuencia dentro de los límites |
| Solicitudes nuevas | Depende de la cobertura del clasificador y las rutas alternativas | Responder solo cuando el contexto lo sustenta | Puede elegir una ruta útil o decidir incorrectamente |
| Acceso al conocimiento | Búsqueda configurada, APIs o respuestas guardadas | A menudo RAG; depende de la implementación | A menudo RAG y herramientas; depende de la implementación |
| Mantenimiento | Mantener flujos, plantillas, integraciones y pruebas | Mantener fuentes, recuperación y evaluación | Mantener fuentes, herramientas, políticas y evaluación |
| Estructura de costes | Alojamiento, integraciones, licencias y trabajo humano | Uso de plataforma o modelo más trabajo humano | Uso de plataforma o modelo, herramientas y trabajo humano |
| Fallos | Enrutamiento incorrecto, estado erróneo o error de API | Respuesta sin fundamento o fallo de recuperación | Respuesta sin fundamento, herramienta incorrecta o escritura incierta |
| Latencia | Depende del flujo y los servicios posteriores | Depende de recuperación, modelo y entrega | Depende de pasos seleccionados, servicios y entrega |
Los chatbots basados en reglas todavía tienen sentido
Sí. Elige la arquitectura más sencilla que cumpla los requisitos de calidad, control y tiempo de respuesta. Un flujo programado puede bastar para un formulario estable, pocas respuestas aprobadas o una consulta autorizada con pasos fijos. Añadir un modelo no elimina el mantenimiento de integraciones y políticas.
Varias condiciones pueden favorecer los flujos predefinidos:
Respuestas con redacción aprobada. Las plantillas pueden conservar un texto revisado. Es un control, no una prueba de cumplimiento normativo; la elegibilidad, la información obligatoria, el acceso y las obligaciones de revisión siguen dependiendo del despliegue.
Operaciones sencillas y repetibles. Una secuencia conocida puede evitar llamadas innecesarias al modelo con cualquier volumen de tráfico. Compara costes reales de alojamiento, licencias, APIs y mantenimiento, sin asumir un umbral universal de volumen.
Integraciones existentes que funcionan. Conserva los flujos fiables y añade comprensión del lenguaje o herramientas concretas donde la evaluación demuestre una mejora útil. No hace falta sustituir todas las intenciones y flujos para utilizar un LLM.
Conviene evaluar un diseño agéntico cuando los pasos necesarios varían y la selección por el modelo aporta valor. Compruébalo con tareas representativas y casos de fallo; el nombre de la arquitectura no proporciona una tasa de éxito predeterminada.
Dónde los agentes de IA son más fuertes
Vale la pena evaluar la orquestación dirigida por modelos cuando las solicitudes varían lo suficiente como para que elegir el siguiente paso durante la ejecución resulte útil. Estos son usos candidatos, no afirmaciones de superioridad medida:
Soporte que abarca varios sistemas. El ejemplo de devolución combina consulta de política, lectura autorizada del pedido y una solicitud autorizada por separado. El modelo puede ayudar a elegir el siguiente paso relevante, pero un flujo fijo sigue siendo una alternativa válida.
Preguntas abiertas sobre productos. Una consulta sobre tamaño de equipo, acceso a canales y límites del plan puede requerir varias fuentes documentadas. La recuperación ayuda tanto a chatbots que solo responden como a agentes. Ninguno debe inferir cumplimiento legal o derechos no documentados a partir de una descripción comercial.
Conversaciones de ventas. Un modelo puede recoger requisitos declarados y recuperar contexto permitido del CRM. Compara la precisión de las recomendaciones, el consentimiento y los resultados útiles con el flujo existente antes de afirmar que es más eficaz.
Soporte multilingüe. Los modelos pueden reducir la necesidad de redactar respuestas por separado, pero las lenguas admitidas y su calidad varían. Evalúa terminología, tono, fidelidad a las políticas y escalado en cada lengua. El bucle agéntico no es necesario para responder en varios idiomas ni elimina el trabajo de localización.
Decisiones de escalado. Las reglas y los juicios del modelo pueden ayudar a detectar falta de conocimiento o solicitudes de atención humana. La confianza del modelo o el sentimiento no demuestran de forma fiable que la decisión sea correcta. Verifica la solicitud de derivación y la atención del equipo por separado de la respuesta de IA.
Para conocer los componentes de estas plataformas, consulta la Guía de plataformas de IA conversacional.
Cómo funcionan los agentes de IA en producción
Los sistemas en producción combinan el comportamiento del modelo con controles de aplicación. Controles similares también pueden respaldar flujos programados; no son exclusivos de los agentes.
Límites y reglas de comportamiento. Las instrucciones definen alcance, tono y escalado. Las comprobaciones de la aplicación restringen operaciones y condiciones de parada. Prueba rechazos y fallos además de solicitudes esperadas; un prompt no garantiza que todas las respuestas respeten la política.
Fundamentación en conocimiento (RAG). La recuperación aporta fuentes antes de generar y puede reducir respuestas sin respaldo. No garantiza corrección factual. Examina la fuente recuperada y la afirmación resultante con la trazabilidad que exponga realmente la implementación. Consulta Qué son las alucinaciones de IA para más contexto.
Acceso a herramientas y permisos de acción. Las APIs o servidores MCP pueden exponer lecturas y escrituras. Limita credenciales y operaciones, exige acceso del cliente en destino y trata el texto devuelto como datos. Una herramienta configurada o los parámetros propuestos por el modelo no conceden autoridad sobre pedidos ajenos ni reembolsos no aprobados.
Quickchat AI Agents permite respuestas desde la Knowledge Base y API y MCP Actions configuradas. Las API Actions pueden usar condiciones Run only when comprobadas fuera del modelo; utiliza metadatos fiables y conserva la autorización de la API de destino. Human Handoff pausa las respuestas de IA y coloca la conversación en Inbox, asignada si el enrutamiento selecciona a alguien o sin asignar en caso contrario. Asignarla no garantiza una respuesta humana inmediata. El flujo de devolución anterior requiere servicios externos y configuración adecuados; no promete gestión nativa de devoluciones o reembolsos.
Compensaciones de costo y rendimiento
Elegir entre chatbot y agente de IA es una decisión tanto arquitectónica como económica.
Economía de los chatbots
Un flujo programado puede evitar la inferencia del LLM, pero su coste marginal no tiene por qué ser cero. Incluye alojamiento, licencias, APIs posteriores, supervisión y trabajo humano. Una consulta sencilla puede ser barata con ambas arquitecturas; mide el despliegue real.
El mantenimiento incluye flujos, plantillas, integraciones y cobertura de pruebas. Los sistemas agénticos añaden trabajo en prompts, recuperación, herramientas y evaluación. Estima ambos con el mismo alcance y periodo, sin asumir que uno necesita menos mantenimiento.
Economía de los agentes de IA
La inferencia y la ejecución de herramientas consumen recursos, pero la factura de una plataforma puede basarse en créditos, conversaciones, resoluciones, usuarios o suscripción. El coste interno por token no es necesariamente la unidad facturada al cliente.
Compara las condiciones actuales directamente: los precios de Quickchat AI, Intercom y Salesforce Agentforce usan unidades y condiciones específicas. Comprueba cuota base, compromiso mínimo, uso incluido, excesos y definición del resultado facturable. Una conversación y una resolución verificada no son intercambiables. La guía de modelos de precios de agentes de IA explica cómo comparar esos alcances sin equiparar las tarifas anunciadas.
Usa tu propia cohorte de solicitudes elegibles para estimar el coste por resultado verificado. Incluye intentos fallidos, contactos repetidos, correcciones humanas, gasto recurrente y configuración inicial. El coste del soporte humano también depende del canal y del alcance de costes; una cifra sectorial amplia no es una referencia equivalente para tu despliegue. El tiempo liberado es capacidad, no ahorro monetario, salvo que disminuya un coste real o se evite un gasto previsto.
Para calcular sobre el mismo periodo, consulta Cómo calcular el ROI de un chatbot. Aquí no se presupone ventaja en resolución ni porcentaje de ahorro. Mide el tiempo hasta la primera respuesta útil y hasta la finalización verificada, incluidos servicios posteriores y derivación; ninguna arquitectura tiene un intervalo universal de latencia.
Medir el éxito de forma diferente
Compara las arquitecturas con criterios de resultado comunes y añade diagnósticos para sus distintos fallos.
Los diagnósticos del flujo incluyen intenciones reconocidas, causas de respuestas alternativas, transiciones de estado, errores de API y cumplimiento de pasos obligatorios. Completar un flujo no significa necesariamente resolver el problema del cliente.
Las métricas de resultado incluyen resolución verificada entre solicitudes elegibles, contactos repetidos, correcciones humanas, satisfacción del cliente junto con el número de respuestas a la encuesta y coste por resultado verificado. En agentes, revisa también afirmaciones sin respaldo, selección de herramientas, denegaciones de acceso y escrituras inciertas. No cuentes una respuesta generada, una solicitud de devolución aceptada y un reembolso completado como un mismo resultado.
La guía de analítica de chatbots separa observaciones nativas del producto de métricas que requieren evidencia externa e incluye una hoja sintética. Define el denominador y la ventana de observación antes de comparar; la hoja no es un benchmark.
Conserva evidencia suficiente para auditar por separado una respuesta de política, una consulta autorizada, una modificación externa y una derivación. Las fuentes recuperadas, las respuestas de herramientas y el estado autorizado del sistema sirven para fines diferentes. Usa registros sintéticos o protegidos para evaluar y no expongas datos privados de clientes en ejemplos compartidos.
FAQ
Puedo convertir mi chatbot existente en un agente de IA
A menudo puedes añadir comprensión del lenguaje o herramientas concretas de forma gradual conservando flujos, conocimiento e integraciones útiles. La selección de herramientas por el modelo es un cambio arquitectónico que exige evaluación. Mantén autorización, aprobaciones requeridas y pasos deterministas fiables en lugar de descartarlos para adoptar la etiqueta de agente.
Los agentes de IA son más caros que los chatbots
No hay una respuesta universal. Compara suscripciones, unidades facturadas, uso, configuración, mantenimiento y correcciones humanas para las mismas tareas elegibles y el mismo periodo. Las llamadas al modelo consumen recursos, pero la facturación al cliente varía. Hay que medir mejoras de resolución y ahorro monetario; liberar tiempo no equivale automáticamente a ahorrar dinero.
Los agentes de IA alucinan
Sí. La recuperación puede aportar fuentes relevantes, pero no garantiza una respuesta correcta. Comprueba que las afirmaciones se deducen de las fuentes y que el resultado de una herramienta confirma lo que se declara. Aplica el mismo criterio a los chatbots LLM que solo responden y deriva cuando falte evidencia.
Un agente de IA puede manejar tareas que un chatbot no puede
Un agente puede elegir pasos útiles para solicitudes variadas que un flujo existente no cubre. Los chatbots programados también pueden llamar a APIs, guardar estado y completar tareas de varios pasos. La capacidad real depende de integraciones, permisos, políticas y evidencia, no de la etiqueta de la interfaz. Una solicitud de devolución sigue requiriendo autoridad de escritura independiente.
Qué pasa con la latencia
Mide el tiempo hasta la primera respuesta útil y hasta la finalización verificada con tareas representativas, incluidas llamadas posteriores lentas o fallidas. Compara distribuciones, como mediana y percentil 95, con tus requisitos. Más pasos de modelo o herramientas pueden añadir demora, pero ninguna etiqueta establece un tiempo universal ni hace aceptable esa demora.
”Agente de IA” es solo un cambio de marca de “chatbot”
Las etiquetas se solapan. Chatbot describe una interfaz, mientras que orquestación agéntica suele significar que un modelo elige pasos o herramientas durante la ejecución. Examina el flujo real, los controles de autoridad, las condiciones de parada y la evidencia de resultados. El nombre del producto no demuestra más autonomía, precisión o valor empresarial.