

Als je conversational AI evalueert voor support, sales of interne tooling, heb je waarschijnlijk gemerkt dat leveranciers “chatbot” en “AI agent” heel verschillend gebruiken, afhankelijk van wat ze verkopen. Sommige producten met het label “AI agent” zijn dunne wrappers rond een taalmodel zonder toegang tot tools. Sommige producten met het label “chatbot” redeneren autonomer dan systemen die zichzelf agents noemen.
Deze post definieert drie categorieën conversational AI-systemen op basis van hun architectuur, legt uit waartoe elk type daadwerkelijk in staat is en behandelt wanneer je welk type gebruikt. Het doel is je genoeg technische basis te geven om producten te beoordelen op hun echte architectuur in plaats van op hun branding.
Een opmerking over terminologie
De sector heeft nog geen consistente definities vastgesteld, daarom gebruikt deze post drie categorieën:
-
Regelgebaseerde chatbot: Een systeem dat is gebouwd op intentclassificatie, entity-extractie en gescripte dialoogflows. Er is geen taalmodel betrokken bij het genereren van antwoorden. Dit is de traditionele chatbotarchitectuur die al sinds de jaren 2010 bestaat.
-
LLM-chatbot (of copilot): Een systeem dat een large language model gebruikt om antwoorden te begrijpen en te genereren, maar werkt volgens een request-responsepatroon zonder autonoom toolgebruik of meerstapsredenering. Veel “AI chatbot”-producten op de markt vallen in deze categorie. Ze zijn flexibeler dan regelgebaseerde chatbots omdat het LLM open taal afhandelt, maar ze voeren geen acties uit in externe systemen en plannen geen meerstapsworkflows.
-
AI-agent: Een systeem dat is gebouwd rond een LLM dat over taken kan redeneren, tools kan gebruiken, geheugen over interacties heen kan behouden en autonoom meerstapsworkflows kan uitvoeren. Het LLM werkt binnen een loop waarin het observeert, redeneert, handelt en evalueert of de taak is voltooid.
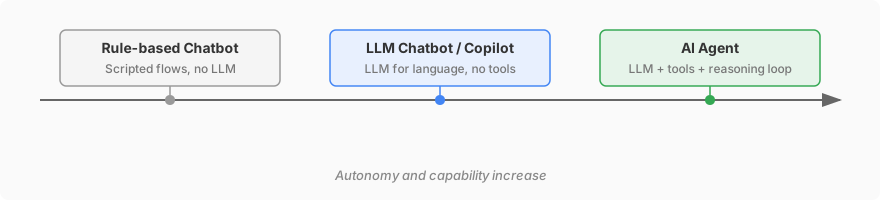 Autonomie en capaciteit nemen van links naar rechts toe. De meeste “AI chatbot”-producten in 2026 bevinden zich ergens op dit spectrum.
De rest van deze post behandelt alle drie categorieën, hoewel het grootste deel van de architectuurdetails gaat over regelgebaseerde chatbots en AI-agents, omdat deze de grootste kloof vertegenwoordigen. Het gedeelte over LLM-chatbots is korter omdat dit architectonisch een begrensde versie van een AI-agent is: hetzelfde taalmodel, maar zonder de loop voor toolgebruik.
Wat is een regelgebaseerde chatbot?
Een regelgebaseerde chatbot voert gesprekken met gebruikers via tekst of spraak met vooraf gedefinieerde logica. Hij is gebouwd op een combinatie van intentclassificatie, entity-extractie en gescripte dialoogflows.
Hoe regelgebaseerde chatbots werken
De typische chatbotarchitectuur heeft drie componenten:
-
Natural Language Understanding (NLU): Parset het bericht van de gebruiker om een intent te identificeren (wat de gebruiker wil) en entities te extraheren (specifieke gegevens zoals datums, productnamen of ordernummers). De meeste NLU-systemen gebruiken een combinatie van regex-patronen, keyword matching en getrainde classifiers.
-
Dialogue Manager: Een state machine die de volgende stap bepaalt op basis van de huidige gespreksstatus en de herkende intent. Elke state heeft een set mogelijke transities, en de dialogue manager volgt de gedefinieerde flow.
-
Response Generator: Haalt een templateantwoord op dat is gekoppeld aan de huidige state. In eenvoudige chatbots is dit een lookup table. In iets geavanceerdere varianten bevat de template slots die worden gevuld met geëxtraheerde entities.
Een vereenvoudigde flow ziet er zo uit:
User: "What's the status of order #12345?"
  → NLU: intent=order_status, entity={order_id: 12345}
  → Dialogue Manager: state=check_order → call order_status_api(12345)
  → Response: "Order #12345 shipped on April 7 and is expected by April 11."
De architectuur ziet er zo uit:
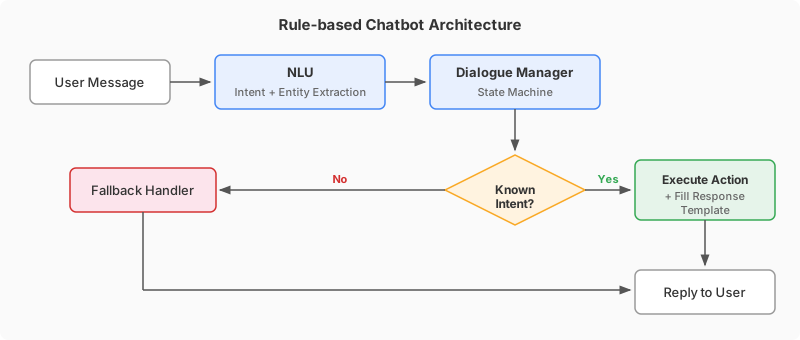
Dit werkt goed voor closed-domain problemen waarbij de set mogelijke intents klein en goed gedefinieerd is. Een FAQ-bot, een afsprakenplanner of een orderstatuschecker kan allemaal op deze manier worden gebouwd.
Beperkingen van de regelgebaseerde architectuur
Het state machine-model valt uiteen wanneer gesprekken onvoorspelbaar worden. Specifiek:
-
Rigide intenttaxonomie: Elke gebruikersvraag moet worden gekoppeld aan een vooraf gedefinieerde intent. Als de gebruiker iets formuleert op een manier die het NLU-model niet heeft gezien, valt het terug op een fallback handler. Naarmate het aantal intents groeit, wordt het onderhouden van de taxonomie en het vermijden van overlap tussen vergelijkbare intents een aanzienlijke engineeringlast.
-
Geen redenering over beurten heen: De dialogue manager volgt een vaste graaf. Hij kan informatie uit meerdere beurten niet combineren om een oordeel te vormen, afwegingen te maken of zijn aanpak aan te passen op basis van context.
-
Kwetsbare entity-extractie: Traditionele slot filling werkt voor gestructureerde input (datums, getallen, product-SKU’s), maar heeft moeite met open beschrijvingen, dubbelzinnige verwijzingen of verzoeken met meerdere onderdelen.
-
Lineaire schaal van inspanning: Een nieuwe use case ondersteunen betekent nieuwe intents, nieuwe dialoogflows, nieuwe antwoordtemplates en nieuwe integratiecode definiëren. Elke toevoeging vergroot het onderhoudsoppervlak proportioneel.
Voor een diepere blik op hoe chatbotarchitecturen zich door de jaren heen hebben ontwikkeld, zie Van NLP-chatbots naar generatieve AI.
Wat is een AI-agent?
Een AI-agent is een systeem dat is gebouwd rond een large language model (LLM) dat over taken kan redeneren, tools kan gebruiken, geheugen over interacties heen kan behouden en beslissingen kan nemen over hoe verder te gaan zonder een gescripte flow te volgen.
De term “agent” komt in deze context uit de AI-onderzoekstraditie, waar een agent elk systeem is dat zijn omgeving waarneemt en acties onderneemt om doelen te bereiken. In de golf van LLM-applicaties van 2024-2026 verwijst “AI agent” specifiek naar systemen die een LLM gebruiken als redeneermotor binnen een loop die observatie, planning, tooluitvoering en evaluatie omvat.
Hoe AI-agents werken
De kernarchitectuur van een AI-agent is een reasoning loop (soms een ReAct-loop genoemd, naar de ReAct-paper die het patroon formaliseerde). De loop heeft vier fasen:
-
Observe: De agent ontvangt het bericht van de gebruiker samen met de gespreksgeschiedenis, systeeminstructies en eventuele opgehaalde context (bijvoorbeeld relevante artikelen uit de knowledge base).
-
Reason: Het LLM verwerkt alle beschikbare context en beslist wat de volgende stap is. Dit kan een rechtstreeks antwoord aan de gebruiker zijn, een verduidelijkende vraag of het aanroepen van een tool. De redeneerstap is waar de agent het meest verschilt van een chatbot: in plaats van een state graph te volgen, genereert het LLM een plan op basis van zijn begrip van de taak.
-
Act: Als de agent besluit een tool te gebruiken, genereert hij een gestructureerde function call (bijvoorbeeld
search_knowledge_base(query="refund policy for damaged items")ofcreate_ticket(customer_id=456, issue="shipping delay")). Het systeem voert de functie uit en retourneert het resultaat naar de agent. -
Evaluate: De agent beoordeelt de output van de tool en beslist of de taak voltooid is of dat een volgende stap nodig is. Als er meer werk nodig is, herhaalt de loop vanaf de redeneerfase.
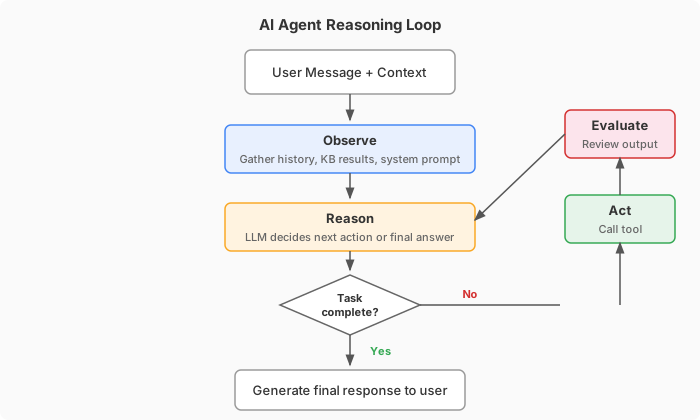
Hier is een concreet voorbeeld van deze loop in actie:
User: "I ordered a laptop last week but received a monitor instead.
       I need the right item shipped and a return label for the monitor."

Agent reasoning loop:
  [Reason] User has two needs: correct item shipment + return label.
           Need to look up the order first.
  [Act]    lookup_order(customer_email="user@example.com", timeframe="7d")
           → Returns: Order #7891, laptop SKU-A100, shipped monitor SKU-B200
  [Reason] Order found. Wrong item confirmed. Need to initiate exchange
           and generate return label.
  [Act]    initiate_exchange(order_id=7891, correct_sku="SKU-A100")
           → Returns: Exchange #EX-442 created, shipping in 1-2 days
  [Act]    generate_return_label(order_id=7891, item_sku="SKU-B200")
           → Returns: Label URL https://...
  [Evaluate] Both tasks complete. Compose response.

Agent: "I found your order #7891. The correct laptop (SKU-A100) will ship
        within 1-2 business days. Here's your return label for the monitor:
        [link]. Drop it off at any carrier location."
Het belangrijkste verschil met de chatbotaanpak: niemand hoefde een “order_wrong_item_exchange_and_return”-intent vooraf te definiëren of een specifieke dialoogflow voor dit scenario te bouwen. De agent deelde het probleem op, riep de juiste tools in de juiste volgorde aan en stelde een antwoord samen.
Toolgebruik en function calling
Toolgebruik (ook function calling genoemd) geeft AI-agents de mogelijkheid om in de wereld te handelen in plaats van alleen tekst te genereren. Het LLM ontvangt een lijst met beschikbare tools en hun schema’s (parameternamen, typen, beschrijvingen) en kan tijdens de reasoning loop kiezen om er een aan te roepen.
Veelvoorkomende toolcategorieën voor klantgerichte AI-agents zijn:
| Categorie | Voorbeelden |
|---|---|
| Knowledge retrieval | Knowledge base doorzoeken, FAQ opzoeken, productdocumentatie ophalen |
| Data lookup | Orderstatus controleren, accountgegevens ophalen, voorraad opvragen |
| Write operations | Supportticket maken, klantrecord bijwerken, terugbetaling verwerken |
| Communication | E-mail versturen, SMS triggeren, naar Slack posten |
| Escalation | Overdragen aan menselijke agent met volledige gesprekscontext |
Het toolschema fungeert als het contract tussen het LLM en het externe systeem. Een goed ontworpen schema geeft het LLM genoeg informatie om de juiste tool te kiezen en de juiste parameters te leveren zonder extra prompting.
Om toolgebruik vanaf nul te zien opbouwen, voegt onze stapsgewijze gids voor het bouwen van een AI-agent die echte acties uitvoert precies één van deze tools toe, een beschreven HTTP-request dat de agent midden in een gesprek aanroept, gratis en zonder code. Om die schrijfactions in de juiste volgorde te laten uitvoeren, en pas nadat de order is opgezocht, voeg je een run-condition toe en neem je de id mee.
Geheugen en contextbeheer
Chatbots slaan gespreksstatus meestal op als een set gevulde slots (bijvoorbeeld order_id=12345, intent=order_status). AI-agents hebben een rijker geheugenmodel nodig omdat ze open gesprekken afhandelen waarin relevante informatie op elk moment kan verschijnen.
De meeste AI-agentimplementaties gebruiken meerdere contextlagen:
- Gespreksgeschiedenis: De ruwe reeks berichten in de huidige sessie.
- Werkgeheugen: Tussenresultaten van tool calls en redeneerstappen die latere beslissingen informeren.
- Opgehaalde context: Knowledge base-artikelen, productdocumentatie of klantrecords die via retrieval-augmented generation (RAG) worden opgehaald op basis van de huidige query.
- Langetermijngeheugen (optioneel): Persistente feiten over de gebruiker of account die over sessies heen meegaan (bijvoorbeeld voorkeurstaal, eerdere issues, abonnementstype).
Context beheren binnen het tokenvenster van het LLM is een echte engineeringuitdaging. Naarmate gesprekken langer worden en meer tools worden aangeroepen, kan de context de capaciteit van het model overschrijden. Strategieën zoals samenvatting, sliding windows en selectieve retrieval helpen de agent functioneel te houden zonder kritieke informatie te verliezen.
De middenweg: LLM-chatbots en copilots
De meeste producten die in 2026 als “AI chatbots” worden vermarkt, vallen in een categorie tussen regelgebaseerde chatbots en volledige AI-agents. Deze systemen gebruiken een LLM om gebruikersinput te begrijpen en antwoorden in natuurlijke taal te genereren, maar ze hebben geen toegang tot tools en voeren geen meerstapsworkflows autonoom uit.
Een typische LLM-chatbot werkt zo: de gebruiker stuurt een bericht, het systeem haalt relevante context op uit een knowledge base (via RAG), stuurt het bericht en de context naar een LLM en retourneert het gegenereerde antwoord. Er is geen reasoning loop, geen toolselectie en geen iteratieve uitvoering. Elk gebruikersbericht triggert één LLM-call.
Deze architectuur is een aanzienlijke verbetering ten opzichte van regelgebaseerde chatbots. Het LLM handelt open taal af zonder vooraf gedefinieerde intenttaxonomie, genereert natuurlijke antwoorden in plaats van templates te vullen en kan werken in elke taal die het model ondersteunt. Voor pure Q&A-use cases waarbij het doel is vragen uit een knowledge base te beantwoorden, kan een LLM-chatbot alles zijn wat je nodig hebt.
De beperking wordt zichtbaar wanneer de gebruiker het systeem iets moet laten doen: een order opzoeken, een ticket maken, een terugbetaling verwerken, voorraad controleren of coördineren tussen meerdere databronnen. Een LLM-chatbot kan alleen voorstellen dat de gebruiker deze acties zelf uitvoert of escaleren naar een mens. Een AI-agent kan ze rechtstreeks uitvoeren.
In de praktijk is de grens tussen LLM-chatbot en AI-agent niet altijd scherp. Een enkele tool (bijvoorbeeld order lookup) toevoegen aan een LLM-chatbot verplaatst hem richting de agentkant van het spectrum. Het onderscheid gaat meer over de mate van autonomie dan over een harde grens. Toch is het architecturale verschil belangrijk: een LLM-chatbot zonder reasoning loop verwerkt één request tegelijk, terwijl een agent meerdere observaties en acties kan koppelen om samengestelde problemen op te lossen.
Vergelijking naast elkaar
| Dimensie | Regelgebaseerde chatbot | LLM-chatbot / Copilot | AI-agent |
|---|---|---|---|
| Kernengine | NLU-classifier + state machine | LLM (single-turn) | LLM met reasoning loop |
| Antwoordgeneratie | Template lookup / slot filling | Gegenereerd uit context | Gegenereerd uit context + toolresultaten |
| Gespreksflow | Vooraf gedefinieerde dialooggraaf | Open, maar één uitwisseling tegelijk | Dynamisch, meerstaps, bepaald tijdens runtime |
| Toolgebruik | Hardcoded API-calls per intent | Geen | LLM selecteert tools uit beschikbare set |
| Meerstapstaken | Vereist expliciete flow voor elk pad | Kan acties niet koppelen | Deelt taken autonoom op |
| Omgaan met nieuwe requests | Fallback / “Ik begrijp het niet” | Kan antwoorden als context bestaat in KB | Redeneert vanuit context + onderneemt actie |
| Kennistoegang | Keyword search of exacte match | RAG met semantisch zoeken | RAG met semantisch zoeken en reranking |
| Onderhoudsmodel | Intents, flows en templates toevoegen per use case | Knowledge base bijwerken | Toolset en knowledge base uitbreiden |
| Kostenstructuur | Lage compute (geen LLM-inference) | LLM-kosten per token | LLM-kosten per token + tooluitvoering |
| Faalmodus | Stille verkeerde routering of fallback | Hallucinatie | Hallucinatie, onjuist toolgebruik |
| Latency | Snel (lookup-gebaseerd) | 1-3 seconden (één LLM-call) | Variabel (afhankelijk van redeneerstappen) |
Zijn regelgebaseerde chatbots nog logisch?
Voor de meeste use cases in 2026 niet. AI-agents zijn goed genoeg, goedkoop genoeg en betrouwbaar genoeg geworden dat een nieuw project starten met een regelgebaseerde chatbot moeilijk te rechtvaardigen is. Een AI-agent handelt alles af wat een chatbot kan (FAQ, eenvoudige lookups, dataverzameling), terwijl hij ook de long tail van requests afhandelt die chatbots niet aankunnen. De onderhoudslast is ook lager: in plaats van intents en flows te definiëren voor elke nieuwe use case, breid je een knowledge base uit en voeg je tools toe.
Er zijn een paar smalle situaties waarin een regelgebaseerde chatbot nog steeds de pragmatische keuze kan zijn:
Regelgevingsbeperkingen die deterministische, vooraf goedgekeurde antwoorden vereisen. In sommige gereguleerde sectoren (zorgdisclosures, financiële compliance) moet elk antwoord vóór deployment worden beoordeeld en goedgekeurd. Een chatbot met templateantwoorden voldoet hier door zijn ontwerp aan. AI-agents kunnen worden begrensd met guardrails, maar de output wordt nog steeds gegenereerd en is niet woord voor woord vooraf goedgekeurd.
Extreme kostengevoeligheid op zeer grote schaal. Als je tientallen miljoenen single-turn interacties per maand verwerkt en de use case echt eenvoudig is (bijvoorbeeld een saldo controleren, een boeking bevestigen), zijn de LLM-inferencekosten per interactie het mogelijk niet waard. Deze drempel verschuift steeds verder naarmate modelkosten dalen, maar begin 2026 bestaat hij nog steeds bij zeer hoge volumes.
Legacy-systemen zonder migratiepad. Sommige organisaties hebben regelgebaseerde chatbots diep geïntegreerd in infrastructuur, zonder budget of planning om ze te vervangen. In deze gevallen is de vraag niet “wat is beter”, maar “wat kunnen we nu doen.”
Buiten deze edge cases is een AI-agent de betere default. De vraag is verschoven van “moeten we een AI-agent of een chatbot gebruiken” naar “hoe configureren en begrenzen we onze AI-agent voor ons specifieke domein.”
Waar AI-agents het sterkst zijn
AI-agents zijn de duidelijke keuze voor de meeste nieuwe conversational AI-projecten in 2026. Een paar scenario’s waarin de kloof tussen agents en regelgebaseerde chatbots het grootst is:
Complexe supportrequests die meerdere systemen beslaan. Het orderruilvoorbeeld hierboven is typisch. De gebruiker heeft een samengesteld probleem dat data opzoeken, beslissingen nemen en meerdere acties uitvoeren vereist. Een chatbot zou een specifieke flow nodig hebben voor elke mogelijke combinatie van issues.
Open productvragen. “Welk plan is geschikt voor een team van 15 dat WhatsApp-integratie en HIPAA-compliance nodig heeft?” vereist redenering over productdocumentatie, prijsregels en compliancevereisten heen. Een agent kan relevante docs ophalen en een antwoord synthetiseren. Een chatbot zou een onmogelijk grote intenttaxonomie nodig hebben om alle mogelijke productvragen te dekken.
Salesgesprekken. Leads kwalificeren, bezwaren beantwoorden en producten aanbevelen op basis van de beschreven behoeften van een prospect zijn inherent ongescript. Een agent die het product begrijpt en toegang heeft tot CRM-data is veel effectiever dan een chatbot die een vertakkend script volgt.
Meertalige support op schaal. LLM’s verwerken meerdere talen native, waardoor een AI-agent klanten in tientallen talen kan bedienen zonder afzonderlijke NLU-modellen of antwoordtemplates voor elke taal. Een regelgebaseerde chatbot vereist expliciete meertalige trainingsdata en templates voor elke ondersteunde taal. Toch vereisen meertalige LLM-deployments nog steeds werk: terminologieconsistentie, toonkalibratie per locale, QA voor talen met minder resources en compliancebeoordeling voor regiospecifieke regelgeving. Het taalmodel verwijdert de engineeringlast per taal, maar het elimineert de noodzaak van lokalisatietoezicht niet.
Scenario’s die oordeel en escalatie vereisen. Een AI-agent kan beoordelen of hij genoeg vertrouwen heeft in zijn antwoord, klantfrustratie detecteren via sentimentanalyse en besluiten te escaleren naar een mens met volledige context. Dit adaptieve gedrag is moeilijk te coderen in een state machine.
Voor achtergrond over hoe conversational AI-platformen zich ontwikkelen om deze use cases te ondersteunen, zie de Gids voor conversational AI-platformen.
Hoe AI-agents in productie werken
Een onbegrensd LLM zonder beperkingen zou onbruikbaar zijn in een klantgerichte omgeving. Productie-AI-agents worden geconfigureerd met controlelagen die bepalen wat de agent mag zeggen, wat hij mag doen en wanneer hij moet stoppen en overdragen aan een mens. Deze zijn niet geleend uit chatbotarchitectuur, maar horen native bij hoe agentplatformen werken.
Guardrails en gedragsregels. De agent werkt binnen configureerbare grenzen: toegestane onderwerpen, beperkingen voor toon en persoonlijkheid, escalatiedrempels en goedgekeurde toolsets. Als een klant vraagt naar een onderwerp buiten de scope van de agent, bepalen de guardrails of de agent weigert, doorverwijst of escaleert. Dit geeft operationele teams de voorspelbaarheid die ze nodig hebben zonder dialoogflows hard te coderen.
Knowledge grounding (RAG). Om hallucinatie te verminderen, worden de antwoorden van de agent gegrond in een beheerde knowledge base via RAG (retrieval-augmented generation). De agent haalt relevante documenten op voordat hij een antwoord genereert, en het systeem kan traceren welke brondocumenten elk antwoord hebben beïnvloed. Voor meer over hoe beperking van hallucinaties in de praktijk werkt, zie Wat zijn AI-hallucinaties?.
Tooltoegang en actierechten. De agent kan acties uitvoeren in externe systemen (tickets maken, terugbetalingen verwerken, records bijwerken, workflows triggeren) via API’s of MCP-servers. Welke tools de agent kan gebruiken, wordt per deployment geconfigureerd. Een supportagent kan leestoegang hebben tot orderdata en schrijftoegang tot het ticketsysteem, maar geen toegang tot facturatiewijzigingen. Deze rechten zijn het productie-equivalent van het least privilege-principe.
Quickchat AI Agents is een voorbeeld van een platform dat alle drie lagen combineert: configureerbare guardrails, RAG-gegronde antwoorden met traceerbaarheid van bronnen en toolgebruik via API’s en MCP.
Afwegingen tussen kosten en prestaties
De keuze tussen chatbot en AI-agent is deels een architectuurbeslissing en deels een economische beslissing.
Chatbot-economie
Regelgebaseerde chatbots hebben vrijwel nul marginale kosten per interactie. De infrastructuurkosten bestaan uit het hosten van een lichte applicatie met een database van intents en antwoorden. Voor high-volume use cases met lage complexiteit is dit moeilijk te verslaan op kosten.
De verborgen kosten zitten in onderhoud. Elke nieuwe use case vereist engineeringtijd om intents te definiëren, flows te bouwen, templates te schrijven en API’s te integreren. Naarmate de chatbot in scope groeit, stapelen deze onderhoudskosten zich op. Organisaties met honderden intents besteden vaak meer aan chatbotonderhoud dan ze aan een AI-agentplatform zouden besteden.
AI-agent-economie
AI-agents hebben kosten per interactie omdat elk gesprek LLM-inference omvat (gefactureerd per token), plus eventuele overhead voor tooluitvoering. De kosten per opgelost gesprek variëren afhankelijk van gesprekslengte, het aantal tool calls en het onderliggende model.
De kosten per door een AI-agent opgelost gesprek lopen sterk uiteen afhankelijk van gesprekslengte, modelkeuze en aantal tool calls, maar de meeste leveranciers prijzen tussen $0.30 en $2.00 per opgelost gesprek. Ter vergelijking: Gartner schat de gemiddelde kosten van een door een mens afgehandelde supportinteractie op $5-$15, afhankelijk van kanaal en complexiteit. Enkele gepubliceerde prijzen per oplossing begin 2026: Intercom Fin rekent $0.99 per resolution, Quickchat AI rekent $0.50 per resolution op het Enterprise-plan, en Salesforce Agentforce rekent $2.00 per conversation.
De economische berekening verschuift in het voordeel van AI-agents naarmate gesprekscomplexiteit toeneemt. Een regelgebaseerde chatbot die slechts 40% van de binnenkomende requests kan afhandelen, routeert de resterende 60% nog steeds naar menselijke agents. Een AI-agent met een hoger oplossingspercentage (leveranciers rapporteren cijfers van 60% tot 90%+ afhankelijk van domein en kwaliteit van de knowledge base) verlaagt de totale kosten van supportoperaties, ook al kost elke afzonderlijke AI-interactie meer dan een chatbotinteractie.
Voor een gedetailleerd framework om deze afwegingen te berekenen, zie Chatbot-ROI berekenen.
Succes anders meten
Chatbots en AI-agents vereisen verschillende analyticsbenaderingen omdat ze op verschillende manieren falen.
Chatbotmetrics richten zich op dekking: hoeveel intents worden herkend, welk percentage berichten op een fallback uitkomt en hoe vaak gebruikers de gedefinieerde flow voltooien. Het belangrijkste diagnostische instrument is het fallbacklog, dat laat zien wat gebruikers vragen dat de chatbot niet kan afhandelen.
AI-agentmetrics richten zich op uitkomstkwaliteit: heeft de agent het issue daadwerkelijk opgelost, was de klant tevreden, wat kostte het en was het antwoord gegrond in accurate bronnen. Belangrijke metrics zijn AI resolution rate, kosten per resolution, CSAT per AI-interactie en sentimenttrends per onderwerp.
Voor een uitgebreide gids voor deze metrics, inclusief hoe je dashboards opzet en welke benchmarks je moet nastreven, zie Chatbot Analytics: gids voor KPI’s, dashboards en metrics.
Traceerbaarheid is een andere dimensie die belangrijker is voor AI-agents dan voor chatbots. Omdat de agent antwoorden genereert in plaats van ze op te zoeken, heb je een manier nodig om te verifiëren dat zijn antwoorden gegrond zijn in je knowledge base en niet verzonnen zijn. Zoek naar platformen die tonen welke brondocumenten elk antwoord hebben beïnvloed, zodat supportteams het gedrag van de agent in de loop der tijd kunnen auditen en verbeteren.
FAQ
Kan ik mijn bestaande chatbot omzetten in een AI-agent?
Niet rechtstreeks, omdat de architecturen fundamenteel verschillend zijn. Veel assets die je voor je chatbot hebt gebouwd (knowledge base-content, API-integraties, FAQ-databases) gaan echter direct over naar een AI-agentopzet. De knowledge base wordt de RAG-corpus, en de API-integraties worden tools die de agent kan aanroepen. Wat je weggooit, is de intenttaxonomie en de definities van dialoogflows, die het LLM vervangt door runtime reasoning.
Zijn AI-agents duurder dan chatbots?
Per interactie, ja. AI-agents maken LLM-inferencekosten die regelgebaseerde chatbots niet hebben. AI-agents lossen echter doorgaans een veel hoger percentage requests op zonder menselijke tussenkomst (80%+ tegenover 40-60% voor traditionele chatbots), wat de totale supportkosten verlaagt. De total cost of ownership hangt af van je gespreksvolume en complexiteitsmix.
Hallucineren AI-agents?
Dat kan. Een LLM kan een antwoord genereren dat plausibel klinkt maar feitelijk onjuist is. Daarom gebruiken productie-AI-agents RAG (retrieval-augmented generation) om antwoorden te gronden in geverifieerd bronmateriaal, en daarom zijn traceerbaarheidsfuncties die tonen welke documenten elk antwoord hebben geïnformeerd cruciaal voor productiedeployments.
Kan een AI-agent taken afhandelen die een chatbot niet kan?
Ja, specifiek taken die redenering over meerdere databronnen vereisen, meerstapsuitvoering, het afhandelen van nieuwe requests die niet door een vooraf gedefinieerde intent worden gedekt en het aanpassen van gedrag op basis van gesprekscontext. Een chatbot kan alleen taken afhandelen die zijn ontwerpers expliciet hebben voorzien en waarvoor ze flows hebben gebouwd.
Hoe zit het met latency?
Chatbots reageren in milliseconden omdat ze een lookup uitvoeren. AI-agents reageren doorgaans in 1-5 seconden, afhankelijk van het aantal vereiste redeneerstappen en tool calls. Voor de meeste customer support- en sales-use cases is deze latency acceptabel. Voor realtime applicaties waarbij sub-second antwoorden verplicht zijn, kan een chatbot of een cached response layer nodig zijn.
Is “AI-agent” alleen een marketingrebrand van “chatbot”?
Nee. Het verschil is architecturaal. Een chatbot volgt een vooraf gedefinieerd script. Een AI-agent redeneert tijdens runtime over de taak en beslist wat hij moet doen. Dit lijkt op het onderscheid tussen een hardcoded if/else-programma en een systeem dat een machine learning-model gebruikt om beslissingen te nemen. Ze kunnen er van buitenaf vergelijkbaar uitzien (beide voeren tekstgesprekken), maar de interne werking en mogelijkheden zijn anders.