

サポート、営業、社内ツール向けに対話型AIを評価している場合、ベンダーが「chatbot」と「AI agent」という言葉を、販売しているものに応じてかなり異なる意味で使っていることに気づいているかもしれません。「AI agent」と呼ばれる製品の中には、ツールアクセスを持たない言語モデルの薄いラッパーにすぎないものがあります。「chatbot」と呼ばれる製品の中には、自らをagentと呼ぶシステムよりも自律的な推論を行うものもあります。
この記事では、対話型AIシステムをアーキテクチャに基づいて3つのカテゴリに定義し、それぞれが実際に何を実行できるのか、どのような場合にどれを使うべきかを説明します。目的は、ブランディングではなく実際のアーキテクチャに基づいて製品を評価できるだけの技術的な土台を提供することです。
用語についての補足
業界では一貫した定義がまだ定まっていないため、この記事では3つのカテゴリを使います。
-
ルールベースのchatbot: インテント分類、エンティティ抽出、スクリプト化された対話フローに基づいて構築されたシステムです。応答生成に言語モデルは関与しません。これは2010年代から存在する従来型のchatbotアーキテクチャです。
-
LLM chatbot(またはcopilot): 大規模言語モデルを使って応答を理解し生成するシステムですが、自律的なツール利用や多段階推論を行わず、リクエストとレスポンスのパターンで動作します。市場にある多くの「AI chatbot」製品はこのカテゴリに該当します。LLMがオープンエンドな言語を処理するためルールベースのchatbotより柔軟ですが、外部システムでアクションを実行したり、多段階のワークフローを計画したりはしません。
-
AI agent: タスクについて推論し、ツールを使い、インタラクションをまたいでメモリを維持し、多段階ワークフローを自律的に実行できるLLMを中心に構築されたシステムです。LLMは、観察し、推論し、行動し、タスクが完了したかを評価するループの中で動作します。
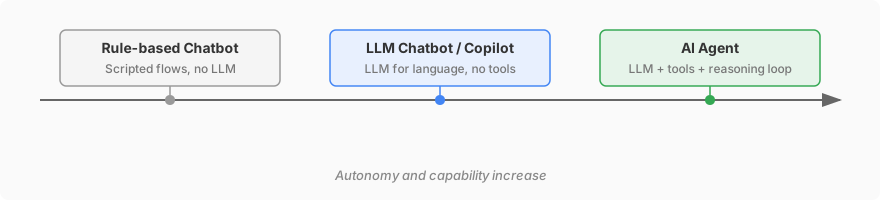 自律性と機能は左から右へ高まります。2026年の多くの「AI chatbot」製品は、このスペクトラム上のどこかに位置します。
この記事の残りでは3つのカテゴリすべてを扱いますが、アーキテクチャの詳細の大部分はルールベースのchatbotとAI agentに置いています。この2つの差が最も大きいためです。LLM chatbotのセクションは短めです。アーキテクチャ上はAI agentの制約版、つまり同じ言語モデルを使うもののツール利用ループを持たない形だからです。
ルールベースのchatbotとは
ルールベースのchatbotは、事前定義されたロジックを使って、テキストまたは音声でユーザーと会話します。インテント分類、エンティティ抽出、スクリプト化された対話フローの組み合わせで構築されます。
ルールベースのchatbotの仕組み
一般的なchatbotアーキテクチャには3つのコンポーネントがあります。
-
Natural Language Understanding (NLU): ユーザーのメッセージを解析し、インテント(ユーザーが求めていること)を特定し、エンティティ(日付、商品名、注文番号などの具体的なデータ)を抽出します。多くのNLUシステムは、正規表現パターン、キーワードマッチング、学習済み分類器を組み合わせて使います。
-
Dialogue Manager: 現在の会話状態と認識されたインテントに基づいて次のステップを決定するステートマシンです。各状態には可能な遷移のセットがあり、dialogue managerは定義されたフローに従います。
-
Response Generator: 現在の状態に関連付けられたテンプレート応答を取得します。単純なchatbotでは、これはルックアップテーブルです。やや高度なものでは、テンプレートに抽出済みエンティティで埋められるスロットが含まれます。
簡略化したフローは次のようになります。
User: "注文 #12345 のステータスはどうなっていますか?"
  → NLU: intent=order_status, entity={order_id: 12345}
  → Dialogue Manager: state=check_order → call order_status_api(12345)
  → Response: "注文 #12345 は4月7日に発送され、4月11日までに到着予定です。"
アーキテクチャは次のようになります。
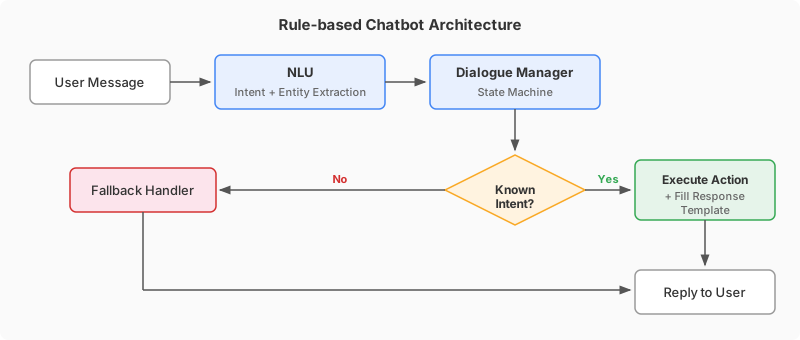
これは、可能なインテントの集合が小さく明確に定義されているクローズドドメインの問題でうまく機能します。FAQ bot、予約スケジューラー、注文ステータス確認ツールは、いずれもこの方法で構築できます。
ルールベースアーキテクチャの制限
会話が予測不能になると、ステートマシンモデルは破綻します。具体的には次のとおりです。
-
硬直したインテント分類: すべてのユーザーリクエストは事前定義されたインテントに対応している必要があります。ユーザーがNLUモデルの見たことがない言い方をすると、fallback handlerに落ちます。インテント数が増えるにつれ、分類体系を維持し、類似インテント間の重複を避けることが大きなエンジニアリング負担になります。
-
ターンをまたいだ推論がない: dialogue managerは固定グラフに従います。複数ターンの情報を組み合わせて判断したり、トレードオフを比較したり、文脈に基づいてアプローチを適応させたりできません。
-
脆いエンティティ抽出: 従来のスロットフィリングは、日付、数値、商品SKUなどの構造化入力には機能しますが、オープンエンドな説明、曖昧な参照、複数要素を含むリクエストには苦戦します。
-
作業量が線形に増える: 新しいユースケースをサポートするには、新しいインテント、新しい対話フロー、新しい応答テンプレート、新しい統合コードを定義する必要があります。追加するたびに、保守対象の範囲が比例して増えます。
chatbotアーキテクチャが長年にわたりどのように進化してきたかを詳しく見るには、NLP ChatbotsからGenerative AIへをご覧ください。
AI agentとは
AI agentは、大規模言語モデル(LLM)を中心に構築されたシステムであり、タスクについて推論し、ツールを使い、インタラクションをまたいでメモリを維持し、スクリプト化されたフローに従わずに進め方を判断できます。
この文脈での「agent」という用語は、環境を知覚し、目標を達成するために行動する任意のシステムをagentと呼ぶAI研究の伝統に由来します。2024年から2026年にかけてのLLMアプリケーションの流れでは、「AI agent」は特に、観察、計画、ツール実行、評価を含むループの中でLLMを推論エンジンとして使うシステムを指します。
AI agentの仕組み
AI agentの中核となるアーキテクチャは推論ループです。これは、このパターンを形式化したReAct論文にちなんでReActループと呼ばれることもあります。ループには4つのフェーズがあります。
-
Observe: agentは、会話履歴、システム指示、取得されたコンテキスト(例: 関連するknowledge base記事)とともに、ユーザーのメッセージを受け取ります。
-
Reason: LLMは利用可能なすべてのコンテキストを処理し、次に何をするかを決定します。ユーザーに直接回答する場合も、確認質問をする場合も、ツールを呼び出す場合もあります。推論ステップは、agentがchatbotと最も異なる点です。状態グラフに従うのではなく、LLMがタスクの理解に基づいて計画を生成します。
-
Act: agentがツールを使うと判断した場合、構造化された関数呼び出しを生成します(例:
search_knowledge_base(query="refund policy for damaged items")またはcreate_ticket(customer_id=456, issue="shipping delay"))。システムは関数を実行し、結果をagentに返します。 -
Evaluate: agentはツールの出力を確認し、タスクが完了したか、別のステップが必要かを判断します。さらに作業が必要な場合、ループは推論フェーズから繰り返されます。
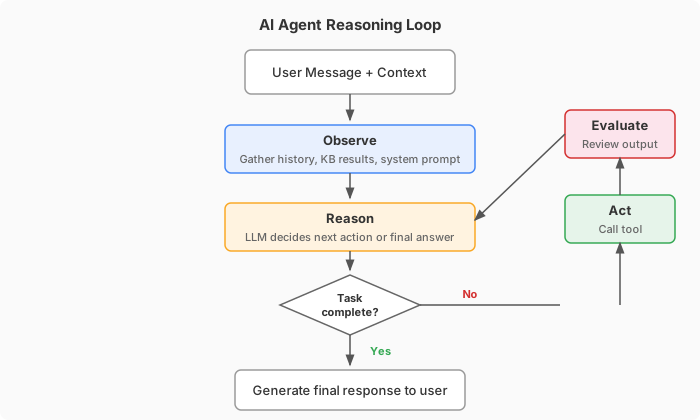
このループが実際に動作する具体例は次のとおりです。
User: "先週ノートPCを注文しましたが、代わりにモニターが届きました。
       正しい商品を発送してもらい、モニター用の返品ラベルも必要です。"

Agent reasoning loop:
  [Reason] ユーザーには2つの要望があります: 正しい商品の発送 + 返品ラベル。
           まず注文を調べる必要があります。
  [Act]    lookup_order(customer_email="user@example.com", timeframe="7d")
           → Returns: Order #7891, laptop SKU-A100, shipped monitor SKU-B200
  [Reason] 注文が見つかりました。誤配送が確認されました。交換を開始し、
           返品ラベルを生成する必要があります。
  [Act]    initiate_exchange(order_id=7891, correct_sku="SKU-A100")
           → Returns: Exchange #EX-442 created, shipping in 1-2 days
  [Act]    generate_return_label(order_id=7891, item_sku="SKU-B200")
           → Returns: Label URL https://...
  [Evaluate] 両方のタスクが完了しました。応答を作成します。

Agent: "注文 #7891 を確認しました。正しいノートPC(SKU-A100)は
        1-2営業日以内に発送されます。モニター用の返品ラベルはこちらです:
        [link]。任意の配送業者の受付場所にお持ち込みください。"
chatbotアプローチとの重要な違いは、このシナリオのために誰かが「order_wrong_item_exchange_and_return」インテントを事前定義したり、専用の対話フローを構築したりする必要がなかったことです。agentが問題を分解し、適切なツールを適切な順序で呼び出し、応答を作成しました。
ツール利用と関数呼び出し
ツール利用(関数呼び出しとも呼ばれます)は、AI agentに単にテキストを生成するだけでなく、現実のシステムに対して行動する能力を与えるものです。LLMは利用可能なツールの一覧とそのスキーマ(パラメータ名、型、説明)を受け取り、推論ループ中に任意のツールを呼び出すことを選択できます。
顧客向けAI agentで一般的なツールカテゴリには次のものがあります。
| Category | Examples |
|---|---|
| 知識検索 | knowledge baseの検索、FAQの参照、製品ドキュメントの取得 |
| データ参照 | 注文ステータスの確認、アカウント詳細の取得、在庫の照会 |
| 書き込み操作 | サポートチケットの作成、顧客レコードの更新、返金処理 |
| コミュニケーション | メール送信、SMSトリガー、Slackへの投稿 |
| エスカレーション | 完全な会話コンテキスト付きで人間のagentに転送 |
ツールスキーマは、LLMと外部システムの間の契約として機能します。適切に設計されたスキーマは、追加のプロンプトなしで、LLMが正しいツールを選び、正しいパラメータを提供できるだけの情報を与えます。
ツール利用をゼロから構築する方法については、実際にアクションを実行するAI agentを構築するためのステップバイステップガイドをご覧ください。このガイドでは、agentが会話中に呼び出す、説明付きのHTTPリクエストというツールを1つだけ追加します。無料で、コードは不要です。これらの書き込みアクションを正しい順序で、注文の検索後に一度だけ実行するには、実行条件を追加し、idを引き継ぎます。
メモリとコンテキスト管理
chatbotは通常、会話状態を埋められたスロットのセット(例: order_id=12345, intent=order_status)として保存します。AI agentは、関連情報が任意の時点で現れるオープンエンドな会話を扱うため、より豊かなメモリモデルを必要とします。
多くのAI agent実装では、複数レイヤーのコンテキストを使います。
- 会話履歴: 現在のセッション内のメッセージの生のシーケンス。
- ワーキングメモリ: 後続の判断に影響する、ツール呼び出しや推論ステップから得られた中間結果。
- 取得されたコンテキスト: 現在のクエリに基づき、検索拡張生成(RAG)によって取り込まれたknowledge base記事、製品ドキュメント、顧客レコード。
- 長期メモリ(任意): セッションをまたいで保持される、ユーザーまたはアカウントに関する永続的な事実(例: 希望言語、過去の問題、サブスクリプション階層)。
LLMのトークンウィンドウ内でコンテキストを管理することは、実際のエンジニアリング課題です。会話が長くなり、呼び出されるツールが増えると、コンテキストがモデルの容量を超える可能性があります。要約、スライディングウィンドウ、選択的検索のような戦略は、重要な情報を失わずにagentを機能させ続けるのに役立ちます。
中間領域: LLM chatbotとcopilot
2026年に「AI chatbot」として販売されている多くの製品は、ルールベースのchatbotと完全なAI agentの間のカテゴリに該当します。これらのシステムはLLMを使ってユーザー入力を理解し、自然言語の応答を生成しますが、ツールへアクセスせず、多段階ワークフローを自律的に実行しません。
典型的なLLM chatbotは次のように動作します。ユーザーがメッセージを送信し、システムがknowledge baseから関連コンテキストを取得し(RAG経由)、メッセージとコンテキストをLLMに渡し、生成された応答を返します。推論ループ、ツール選択、反復実行はありません。各ユーザーメッセージは、1回のLLM呼び出しをトリガーします。
このアーキテクチャは、ルールベースのchatbotと比べて大きな改善です。LLMは事前定義されたインテント分類を必要とせずにオープンエンドな言語を処理し、テンプレートを埋める代わりに自然な応答を生成し、モデルがサポートする任意の言語で動作できます。knowledge baseから質問に回答することが目的の純粋なQ&Aユースケースでは、LLM chatbotで十分な場合があります。
制限が現れるのは、ユーザーがシステムに何かを実行してほしい場合です。注文を調べる、チケットを作成する、返金を処理する、在庫を確認する、複数のデータソース間で調整する、などです。LLM chatbotは、ユーザー自身がこれらのアクションを行うよう提案するか、人間にエスカレーションすることしかできません。AI agentはそれらを直接実行できます。
実務上、LLM chatbotとAI agentの境界は常に明確ではありません。LLM chatbotに単一のツール(例: 注文検索)を追加すると、スペクトラム上でagent側に近づきます。違いは厳密な境界というより、自律性の程度に関するものです。とはいえ、アーキテクチャ上の違いは重要です。推論ループを持たないLLM chatbotは一度に1つのリクエストを処理しますが、agentは複数の観察とアクションを連鎖させて複合的な問題を解決できます。
横並び比較
| Dimension | Rule-based Chatbot | LLM Chatbot / Copilot | AI Agent |
|---|---|---|---|
| 中核エンジン | NLU分類器 + ステートマシン | LLM(単一ターン) | 推論ループ付きLLM |
| 応答生成 | テンプレート参照 / スロットフィリング | コンテキストから生成 | コンテキスト + ツール結果から生成 |
| 会話フロー | 事前定義された対話グラフ | オープンエンドだが、一度に1交換 | 動的、多段階、実行時に決定 |
| ツール利用 | インテントごとにハードコードされたAPI呼び出し | なし | 利用可能なセットからLLMがツールを選択 |
| 多段階タスク | 各パスに明示的なフローが必要 | アクションを連鎖できない | タスクを自律的に分解 |
| 新規リクエストへの対応 | フォールバック / 「理解できません」 | KBにコンテキストがあれば回答可能 | コンテキストから推論 + アクション実行 |
| 知識アクセス | キーワード検索または完全一致 | セマンティック検索付きRAG | セマンティック検索とリランキング付きRAG |
| 保守モデル | ユースケースごとにインテント、フロー、テンプレートを追加 | knowledge baseを更新 | ツールセットとknowledge baseを拡張 |
| コスト構造 | 低い計算コスト(LLM推論なし) | トークン単位のLLMコスト | トークン単位のLLMコスト + ツール実行 |
| 失敗モード | サイレントな誤ルーティングまたはフォールバック | ハルシネーション | ハルシネーション、不正確なツール利用 |
| レイテンシ | 高速(ルックアップベース) | 1-3秒(単一LLM呼び出し) | 可変(推論ステップに依存) |
ルールベースのchatbotはまだ妥当ですか
2026年の多くのユースケースでは、答えはいいえです。AI agentは十分に高性能で、十分に安価で、十分に信頼できるようになっているため、新規プロジェクトをルールベースのchatbotで始めることを正当化するのは困難です。AI agentはchatbotが処理できるすべて(FAQ、単純な検索、データ収集)を処理しつつ、chatbotが扱えないロングテールのリクエストも処理できます。保守負担も低くなります。新しいユースケースごとにインテントやフローを定義する代わりに、knowledge baseを拡張し、ツールを追加します。
ルールベースのchatbotがまだ現実的な選択肢になり得る狭い状況はいくつかあります。
決定論的で事前承認済みの応答を必要とする規制上の制約。 一部の規制業界(医療情報開示、金融コンプライアンス)では、すべての応答をデプロイ前にレビューし承認する必要があります。テンプレート応答を持つchatbotは、この要件を設計上満たします。AI agentはガードレールで制約できますが、出力は依然として生成されるものであり、一語一句事前承認されたものではありません。
大規模環境での極端なコスト感度。 月に数千万件の単一ターンのインタラクションを処理し、ユースケースが本当に単純(例: 残高確認、予約確認)である場合、インタラクションごとのLLM推論コストが見合わない可能性があります。このしきい値はモデルコストの低下に伴って変化し続けていますが、2026年初頭時点では非常に大きなボリュームでまだ存在します。
移行経路のないレガシーシステム。 一部の組織では、ルールベースのchatbotがインフラに深く統合されており、置き換える予算やスケジュールがありません。このような場合、問いは「どちらが優れているか」ではなく、「今すぐ何ができるか」です。
これらのエッジケース以外では、AI agentのほうがより適切なデフォルトです。問いは「AI agentとchatbotのどちらを使うべきか」から、「特定ドメイン向けにAI agentをどのように設定し制約するか」へ移っています。
AI agentが最も強い領域
AI agentは、2026年の多くの新規対話型AIプロジェクトに明確に適しています。agentとルールベースのchatbotの差が最も大きいシナリオをいくつか挙げます。
複数システムにまたがる複雑なサポートリクエスト。 上記の注文交換の例は典型的です。ユーザーには、データを調べ、判断し、複数のアクションを実行する必要がある複合的な問題があります。chatbotでは、問題のあらゆる組み合わせに対して専用フローが必要になります。
オープンエンドな製品質問。 「WhatsApp連携とHIPAA準拠が必要な15人のチームには、どのプランが適していますか?」には、製品ドキュメント、価格ルール、コンプライアンス要件をまたいだ推論が必要です。agentは関連ドキュメントを取得し、回答を統合できます。chatbotでは、考えられるすべての製品質問をカバーするには非現実的に大きなインテント分類が必要になります。
営業会話。 リードの適格性判断、反論への回答、見込み客が説明したニーズに基づく製品推奨は、本質的にスクリプト化しにくいものです。製品を理解し、CRMデータにアクセスできるagentは、分岐スクリプトに従うchatbotよりはるかに効果的です。
大規模な多言語サポート。 LLMは複数言語をネイティブに扱えるため、AI agentは言語ごとに個別のNLUモデルや応答テンプレートを用意しなくても、数十言語で顧客に対応できます。ルールベースのchatbotでは、サポートする各言語について明示的な多言語学習データとテンプレート作成が必要です。ただし、多言語LLMデプロイにも作業は必要です。用語の一貫性、ロケールごとのトーン調整、低リソース言語のQA、地域固有の規制に対するコンプライアンスレビューなどです。言語モデルは言語ごとのエンジニアリング負担を取り除きますが、ローカリゼーション監督の必要性をなくすわけではありません。
判断とエスカレーションが必要なシナリオ。 AI agentは、回答に十分な確信があるかを評価し、感情分析によって顧客の不満を検出し、完全なコンテキスト付きで人間へエスカレーションすることを決定できます。この適応的な振る舞いをステートマシンにエンコードするのは困難です。
対話型AIプラットフォームがこれらのユースケースを支えるためにどのように進化しているかの背景については、Conversational AI Platform Guideをご覧ください。
本番環境でAI agentがどのように動くか
制約のない生のLLMは、顧客向け環境では使い物になりません。本番環境のAI agentは、agentが何を言えるか、何を実行できるか、いつ停止して人間に引き継ぐべきかを決定する制御レイヤーで設定されます。これらはchatbotアーキテクチャから借用されたものではありません。agentプラットフォームの動作に本来備わるものです。
ガードレールと行動ルール。 agentは、許可されたトピック、トーンとパーソナリティの制約、エスカレーションしきい値、承認済みツールセットといった設定可能な境界内で動作します。顧客がagentの範囲外のトピックについて尋ねた場合、ガードレールが、agentが拒否するか、別の方向へ誘導するか、エスカレーションするかを決定します。これにより、対話フローをハードコードせずに、運用チームが必要とする予測可能性を得られます。
知識に基づくグラウンディング(RAG)。 ハルシネーションを減らすため、agentの応答はRAG(検索拡張生成)を通じてキュレーションされたknowledge baseに基づけられます。agentは応答生成の前に関連ドキュメントを取得し、システムは各回答にどのソースドキュメントが影響したかを追跡できます。ハルシネーション緩和が実際にどのように機能するかについては、AI Hallucinationsとは何かをご覧ください。
ツールアクセスとアクション権限。 agentは、APIまたはMCPサーバー経由で外部システムに対してアクションを実行できます(チケット作成、返金処理、レコード更新、ワークフロートリガーなど)。agentがどのツールにアクセスできるかはデプロイごとに設定されます。サポートagentは注文データへの読み取りアクセスとチケットシステムへの書き込みアクセスを持つ一方、請求変更へのアクセスは持たない場合があります。これらの権限は、最小権限の原則に相当する本番環境での仕組みです。
Quickchat AI Agentsは、3つのレイヤーすべてを組み合わせたプラットフォームの一例です。設定可能なガードレール、ソース追跡可能なRAGベースの応答、APIとMCPによるツール利用を備えています。
コストと性能のトレードオフ
chatbotとAI agentの選択は、アーキテクチャ上の判断であると同時に、経済的な判断でもあります。
chatbotの経済性
ルールベースのchatbotは、インタラクションごとの限界費用がほぼゼロです。インフラコストは、インテントと応答のデータベースを持つ軽量アプリケーションのホスティングです。大量かつ低複雑性のユースケースでは、コスト面でこれを上回るのは困難です。
隠れたコストは保守にあります。新しいユースケースごとに、インテントを定義し、フローを構築し、テンプレートを書き、APIを統合するエンジニアリング時間が必要です。chatbotのスコープが広がると、この保守コストは複利的に増えます。数百のインテントを持つ組織では、AI agentプラットフォームに費やすよりも多くをchatbot保守に費やすことがよくあります。
AI agentの経済性
AI agentにはインタラクションごとのコストが発生します。すべての会話でLLM推論(トークン課金)と、任意のツール実行オーバーヘッドが発生するためです。解決済み会話あたりのコストは、会話の長さ、ツール呼び出しの数、基盤モデルによって異なります。
AI agentによって解決された会話1件あたりのコストは、会話の長さ、モデル選択、ツール呼び出し数によって大きく変わりますが、多くのベンダーは解決済み会話1件あたり$0.30から$2.00の範囲で価格を設定しています。比較として、Gartnerの推定では、人間が処理するサポートインタラクションの平均コストは、チャネルと複雑性に応じて$5-$15です。2026年初頭時点で公開されている解決単価の例として、Intercom Finは$0.99 per resolution、Quickchat AIはEnterpriseプランで$0.50 per resolution、Salesforce Agentforceは$2.00 per conversationです。
会話の複雑性が高まるにつれ、経済的な計算はAI agentに有利になります。受信リクエストの40%しか処理できないルールベースのchatbotは、残りの60%を依然として人間のagentにルーティングします。解決率がより高いAI agent(ベンダー報告では、ドメインとknowledge baseの品質に応じて60%から90%超の範囲)は、個々のAIインタラクションがchatbotインタラクションより高くても、サポート運用全体のコストを削減します。
これらのトレードオフを計算するための詳細なフレームワークについては、Chatbot ROIの計算方法をご覧ください。
成功指標の違い
chatbotとAI agentは失敗の仕方が異なるため、異なる分析アプローチが必要です。
chatbotの指標はカバレッジに焦点を当てます。認識されるインテント数、fallbackに到達するメッセージの割合、ユーザーが定義済みフローを完了する頻度などです。主な診断ツールはfallbackログであり、chatbotが処理できないユーザーの質問を示します。
AI agentの指標は成果品質に焦点を当てます。agentが実際に問題を解決したか、顧客が満足したか、コストはいくらか、応答が正確なソースに基づいていたかです。主要指標には、AI解決率、解決あたりコスト、AIインタラクション別CSAT、トピック別のセンチメント傾向が含まれます。
これらの指標について、ダッシュボードの設定方法や目標とするベンチマークを含む包括的なガイドは、Chatbot Analytics: KPI、ダッシュボード、指標ガイドをご覧ください。
追跡可能性は、chatbotよりもAI agentにとって重要なもう1つの側面です。agentは応答を参照ではなく生成するため、その回答がknowledge baseに基づいており、捏造ではないことを検証する方法が必要です。各応答にどのソースドキュメントが影響したかを表示するプラットフォームを探してください。そうすることで、サポートチームは時間の経過とともにagentの振る舞いを監査し、改善できます。
FAQ
既存のchatbotをAI agentに変換できますか
直接はできません。アーキテクチャが根本的に異なるためです。ただし、chatbot用に構築した多くの資産(knowledge baseコンテンツ、API統合、FAQデータベース)は、AI agentのセットアップに直接移行できます。knowledge baseはRAGコーパスになり、API統合はagentが呼び出せるツールになります。破棄するのはインテント分類と対話フロー定義であり、LLMがこれらを実行時推論で置き換えます。
AI agentはchatbotより高価ですか
インタラクション単位では、はい。AI agentには、ルールベースのchatbotにはないLLM推論コストが発生します。ただし、AI agentは通常、人間の介入なしに解決するリクエストの割合がはるかに高く(従来型chatbotの40-60%に対して80%以上)、全体のサポートコストを削減します。総所有コストは、会話量と複雑性の組み合わせによって異なります。
AI agentはハルシネーションを起こしますか
起こり得ます。LLMはもっともらしく聞こえるものの、事実として誤った応答を生成することがあります。そのため、本番環境のAI agentはRAG(検索拡張生成)を使って検証済みのソース資料に応答を基づけます。また、各回答にどのドキュメントが影響したかを示す追跡可能性機能が、本番デプロイでは重要です。
AI agentはchatbotができないタスクを処理できますか
はい。具体的には、複数データソースをまたいだ推論、多段階実行、事前定義されたインテントに含まれない新規リクエストの処理、会話コンテキストに基づく振る舞いの適応が必要なタスクです。chatbotが処理できるのは、設計者が明示的に予測し、フローを構築したタスクだけです。
レイテンシはどうですか
chatbotはルックアップを実行するため、ミリ秒単位で応答します。AI agentは通常、必要な推論ステップとツール呼び出しの数に応じて1-5秒で応答します。多くのカスタマーサポートや営業のユースケースでは、このレイテンシは許容できます。サブ秒の応答が必須のリアルタイムアプリケーションでは、chatbotまたはキャッシュされた応答レイヤーが必要になる場合があります。
「AI agent」は「chatbot」のマーケティング上の言い換えにすぎませんか
いいえ。違いはアーキテクチャにあります。chatbotは事前定義されたスクリプトに従います。AI agentは実行時にタスクについて推論し、何をするかを決定します。これは、ハードコードされたif/elseプログラムと、機械学習モデルを使って判断するシステムの違いに似ています。外から見ると似て見える場合があります(どちらもテキスト会話を行うため)が、内部の仕組みと能力は異なります。