

LLMが関数を呼び出せるようになったとき
GPT-3の時代にLLMとやり取りするとは、プロンプトを入力し、テキストを受け取ることを意味していました。モデルの知識は大規模でしたが静的であり、学習データに含まれていた内容で固定されていました。量子コンピューティングの説明やメールの下書きを依頼すると、もっともらしいテキストを生成できました。しかし、今日の天気を確認したり、データベースに問い合わせたり、現実世界で何らかのアクションを実行したりすることはできませんでした。
この状況を変えた機能は、驚くほど正当に評価されていません。この機能により、モデルはテキストを生成するか、関数を呼び出すかを選択できるようになりました。常に次のトークンを生成する代わりに、モデルは関数名と引数を指定する構造化JSONオブジェクトを出力できるようになりました。ランタイムはその関数を実行し、結果をモデルに戻し、モデルはそこから処理を続けます。ReAct論文 (Yao et al., 2022) は、これをThought-Action-Observationループとして形式化しました。モデルは何をすべきかを推論し、アクションを実行し (ツールを呼び出し)、結果を観察し、これを繰り返します。2026年の本格的なAIエージェントはすべて、このパターンの何らかのバージョンで動作しています。
ループ
Claude Code、OpenClaw、Codex、Devin、その他多数のエージェント型システムは、すべて同じ方法で動作します。ツールを呼び出し、結果を観察し、次に何をするかを決め、繰り返します。Simon Willisonは的確に表現しています: 「LLMエージェントは、目標を達成するためにループ内でツールを実行する。」
たとえばClaude Codeは、マルチエージェントのスウォームや複雑なオーケストレーショングラフを使わず、シングルスレッドのマスターループを使用しています: while(tool_call) -> execute -> feed results -> repeat。
Anthropicのエージェント自律性に関する研究では、Claude Codeにおけるターンの継続時間が3か月でほぼ2倍になり、25分から45分超へ増加したことが示されています。ユーザーは、ループが自律的に実行されることをますます信頼するようになっています。データによると、経験豊富なユーザーほど_より頻繁に_介入しますが、その性質はアクションごとの承認から戦略的な監視へ移っています。一方で、エージェント自身が説明を求める頻度は、ユーザーが介入する頻度の2倍を超えています。
このループパターンは、コーディングエージェント、カスタマーサポートボット、ロボティクスコントローラーなど、あらゆる場所に現れます。
ツールとは何か
LLMでは、ツールがどの抽象度で動作すべきかを決める際に、かなりの自由度があります。一方の端には、「これら12個のフィールドを持つHubSpotコンタクトを作成する」のような、非常に具体的なAPIエンドポイントがあります。もう一方の端には、「このbashコマンドを実行する」や「このPythonコードを実行する」のようなツールがあります。これらは本質的には「望むことを何でも実行する」というものです。
Devinは3つのツール、shell、code editor、browserで動作します。Claude Codeの主要なツールもshellです。OpenClawは動的なスキルプラグインシステムを使用します。エージェント型コーディングツールの傾向は、多数の具体的なツールではなく、より少数でより汎用的なツールへ向かっています。
Simon Willisonは、MCPについて、コーディングエージェントではbashが汎用ツールであるため「当初は爆発的に広がったが、その後は中心性が薄れた」と観察しています。ファイルとスクリプトは、完全なMCPサーバー実装よりもオーバーヘッドの低いプリミティブです。エージェントがコードを書いて実行できるなら、専用のツール定義を必要とせず、ほぼ何でも実行できます。
ただし、汎用ツールは汎用エージェント向けに機能します。ドメイン固有のAIエージェント (カスタマーサポート、営業、社内業務) には、ドメイン固有のツールが必要です。サポートエージェントが注文ステータスを確認するためにPythonを書くべきではありません。明確なパラメータと予測可能なレスポンスを持つ、適切に定義されたAPIエンドポイントを呼び出すべきです。ツールセットの設計は、プロダクト上の判断になります。
| Approach | Example | Control | Flexibility | Use Case |
|---|---|---|---|---|
| 汎用ツール | Bash、Pythonインタープリター | 最小 | 最大 | コーディングエージェント、パーソナルアシスタント |
| プロトコルバンドル (MCP) | Shopify MCP、GitHub MCP | 中程度 | 中程度 | 迅速なインテグレーション、プロトタイピング |
| 単一APIエンドポイント | ”Create HubSpot contact” | 最大 | 最小 | 本番環境の顧客対応エージェント |
APIエンドポイントが現在意味するもの
AIエージェントにとって、APIエンドポイントはケイパビリティの宣言として機能します。1つ公開することは、あなた (またはあなたのAIエージェント) が、以前は不可能だった何かを実行できるようになったことを意味します。
これは双方向に機能します。ソフトウェアベンダーは、他者が自社プロダクトと連携できるようにAPIを公開します。一方で、AIエージェントも、ドキュメントを検索したり、OpenAPI仕様を読んだり、文字どおりタスクの達成方法をGoogleで検索したりして、自力でエンドポイントを発見できます。
MCPサーバーは、使い方についての事前の考え方を持った、APIエンドポイントのキュレーション済みバンドルです。MCP作成者は、どのエンドポイントを公開するか、どのような名前にするか、どのパラメータを表に出すか、そして暗黙的にどのワークフローをサポートするかをすでに決めています。このキュレーションは、強み (利便性、標準化) であると同時に弱み (硬直性、意見の強いスコープ設定) でもあります。Notionのサーバーは具体例です。28個のツールを公開しており、ヘルプセンターエージェントにはそのうち4個が必要です。それらは2つの接続に分かれています。
MCPは使いやすさと引き換えに制御を手放します。2026年には、AIがインテグレーションコードの大部分を書きます。エージェントがAPIドキュメントを読み、自分でインテグレーションを書けるなら、MCPの「使いやすさ」という主張は弱くなります。MCPレイヤーが最も重要になるのは、ツール群がモデルの能力にまだ追いついていない移行期間かもしれません。Anthropicのツール使用デザインパターンに関するガイドは、MCPを使うか個別エンドポイントを使うかにかかわらず、ツールスキーマを構成するための実践的な参考資料です。
関連する動きとして、llms.txtがあります。これは、ウェブサイトがAIモデルを価値の高いリソースへ誘導するために/llms.txtファイルを公開するという提案標準です。Anthropic、Cloudflare、Docker、Stripeが採用しています。**MCPはツール呼び出しを標準化し、llms.txtはドキュメント発見を標準化します。**どちらも、異なる角度から、ウェブを機械にとってより読みやすくしようとしています。
AIエージェントの文脈におけるAPIエンドポイントとは何ですか。
APIエンドポイントとは、構造化された入力を受け取り、構造化された出力を返す特定のURLです。AIエージェントにとって、各エンドポイントは個別のケイパビリティ、つまりエージェントが現実世界で実行できることを表します。エンドポイントの説明、パラメータ定義、エラーレスポンスは、エージェントの取扱説明書として機能します。エンドポイントのドキュメントが優れているほど、エージェントはそれをより確実に使用できます。
チュートリアルを読み、反復的にデバッグできる人間の開発者とは異なり、エージェントはエンドポイントのスキーマと説明に依存して、1回で正しい呼び出しを行います。このため、AIによる消費を前提に設計されたAPIドキュメントは、これまで以上に重要です。ワークフローでAIを使用している開発者が89%いるにもかかわらず、現在AIエージェントを意識してAPIを設計している開発者は24%にすぎません。
MCP (Model Context Protocol) とは何ですか。
MCPは、AIエージェントが外部ツールやデータソースへ接続する方法を標準化する、Anthropicが導入したオープンプロトコルです。AIのためのUSB-Cと考えると分かりやすいです。任意のツールプロバイダーが実装でき、任意のAIエージェントが利用できる単一のコネクターです。MCPサーバーは、標準化されたスキーマを持つ一連のツール (本質的にはAPIエンドポイント) を公開し、MCPクライアント (エージェント) はカスタムインテグレーションコードなしでそれらを発見し、呼び出せます。より詳細な技術的説明については、当社のMCP Explained記事を参照してください。本番環境におけるMCPの実践的な説明については、ShopifyのMCP上で構築する際の現実的な課題の分析を参照してください。
Quickchat AIにおける制御のスペクトラム
Quickchat AIは、AI Agentに外部ツールを持たせるための3つの方法を提供します。これらは、最も自動化されたものから最も制御しやすいものまでのスペクトラム上にあります。それぞれのアプローチは、セットアップ速度と挙動の精度の間で異なるトレードオフを持ちます。
Remote MCP: 接続してすぐ使う
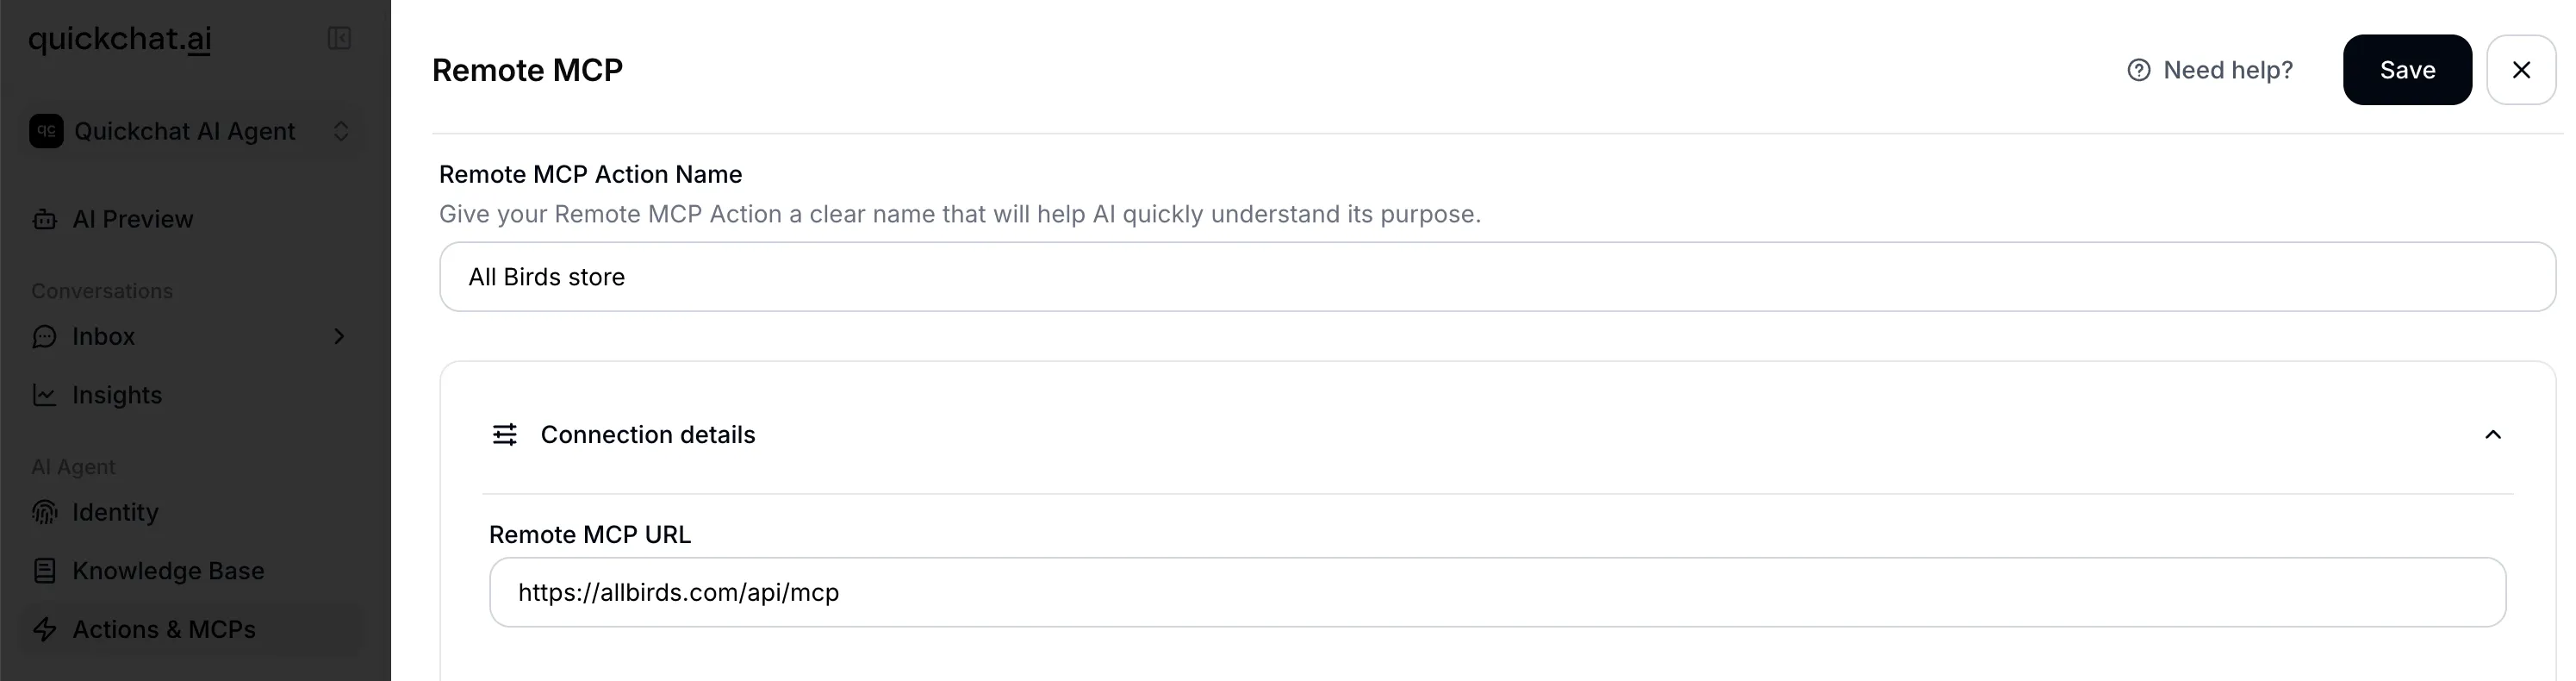
Remote MCPは、AI Agentを外部機能に接続する最速の方法です。MCPサーバーURLを指定すると、Quickchat AIが接続し、利用可能なすべてのツールを検出し、エージェントが使用すべきツールを選択できるようにします。
設定方法:
- Quickchat AI dashboardでAI Actionsに移動します
- “Add Remote MCP”をクリックします
- MCPサーバーURLを貼り付けます (例:
https://mcp.example.com/sse) - 必要に応じて認証トークンまたはカスタムヘッダーを追加します (この2つは同時には使用できません)
- “Connect.”をクリックします。Quickchat AIが利用可能なすべてのツールを検出し、それらの名前を表示します
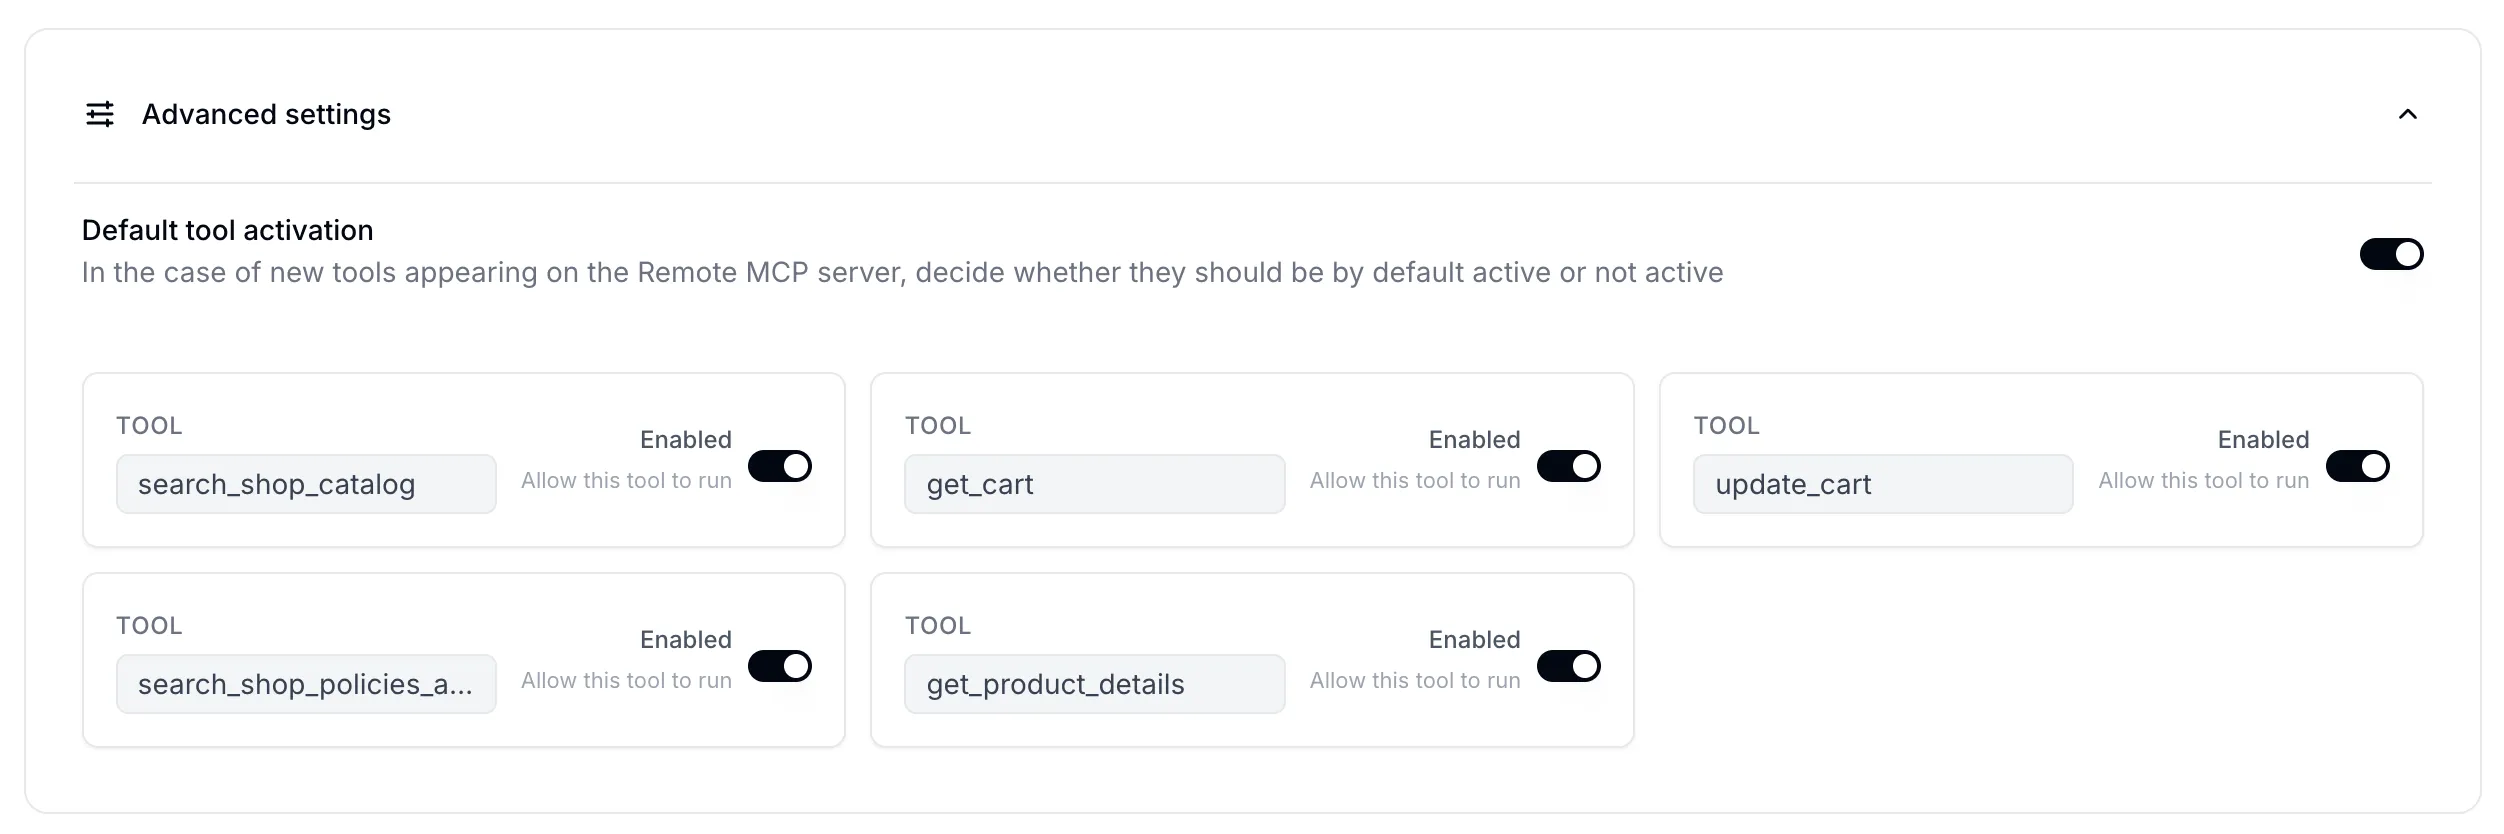
- 個別のツールをオンまたはオフに切り替え、エージェントが使用できるツールを制御します
- “default tool is active”フラグを設定し、新しく検出されたツールを自動的に有効にするか無効にするかを制御します
内部で起きていること:
Connectをクリックすると、Quickchat AIはURLからトランスポートプロトコルを自動検出します。URLにsseが含まれている場合はSSEトランスポートが使用されます。それ以外の場合、streamable_httpがデフォルトです。認証トークンを指定した場合、それはAuthorizationヘッダー内のBearerトークンとして送信されます。
Tool filteringは3層のシステムで機能します。MCPサーバーからの各ツールは2つのセットと照合されます。明示的に有効化されたツールは常に含まれ、明示的に無効化されたツールは常に除外され、どちらのセットにも含まれないツールは、選択した”default tool is active”設定に従います。つまり、MCPサーバーが新しいツールを追加したとき、それらをエージェントが自動的に利用できるようにするか、明示的な有効化を必要とするかを制御できます。
実行時に会話が開始されると、エージェントに対するすべての有効なRemote MCP接続が読み込まれます。ツールは各接続の設定に従って取得およびフィルタリングされ、すべてのソース間でツール名の一意性が検証されます (重複が見つかった場合は警告が出ます)。
トレードオフ: MCPが公開するすべてに即座にアクセスできますが、ツールの説明、パラメータ定義、またはエージェントがそれらをどう使うと判断するかについての制御は限定的です。ShopifyのMCP上でAI Agentを構築した際に分かったように、デモから本番環境へ移行するには慎重な調整が必要であり、MCPのバンドル型アプローチではそれが難しくなる場合があります。
関連資料: エージェントをリモートMCPサーバーに接続する、How to Launch Your Quickchat AI MCP、MCPのセキュリティ上の考慮事項、Quickchat AI docs: MCP channel。
AI Actions (HTTP Request): 1つのエンドポイントを完全に制御する
Quickchat AIのAI Actionは、AI Agent向けに個別に設定する単一のHTTP APIエンドポイントです。MCPが複数のツールをまとめてインポートするのに対し、各AI Actionでは1つの特定のケイパビリティを完全に制御できます。コンタクトの作成とエンリッチメント、商談の記録、CRMでのチケット作成を行う4つのアクションを扱う完全な実例については、HubSpot AI Actionsチュートリアルを参照してください。
AI Actionの設定:
- Name (最大64文字): LLMが見るツール名になります。有効な識別子に正規化されます (例: “Check Order Status”は
Check_Order_Statusになります) - Description (最大1,000文字): 最も重要なフィールドです。説明は、このツールを_いつ_使用すべきかをLLMに伝えます。優れた説明では、どのような会話状況で呼び出すべきか、最初にユーザーからどの情報を収集すべきか、結果をどのように返すべきかを指定します
- HTTP method: GET、POST、PATCH、DELETE、またはPUT
- URL (最大10,000文字): 動的な値のために
{{parameter_name}}プレースホルダーを含めることができます - Headers: 認証とコンテンツタイプ用のキーと値のペア
- Body items / Body JSON: パラメータ注入を含むリクエストボディ
- Query parameters: URLクエリ文字列の値
- Parameters (最大10個): それぞれに名前、説明 (最大500文字)、型 (
str、int、float、bool、またはcustom)、必須フラグ、省略可能なデフォルト値があります
{{parameter_name}}プレースホルダーが重要な仕組みです。LLMがツールを呼び出すとき、会話コンテキストに基づいて各パラメータの値を指定します。その後Quickchat AIは、HTTPリクエストを行う前に、それらの値をURL、ヘッダー、ボディ、クエリ文字列のテンプレートへ注入します。この方法で注入できる組み込み変数も4つあります: scenario_id、conversation_id、conversation_channel、conversation_url。
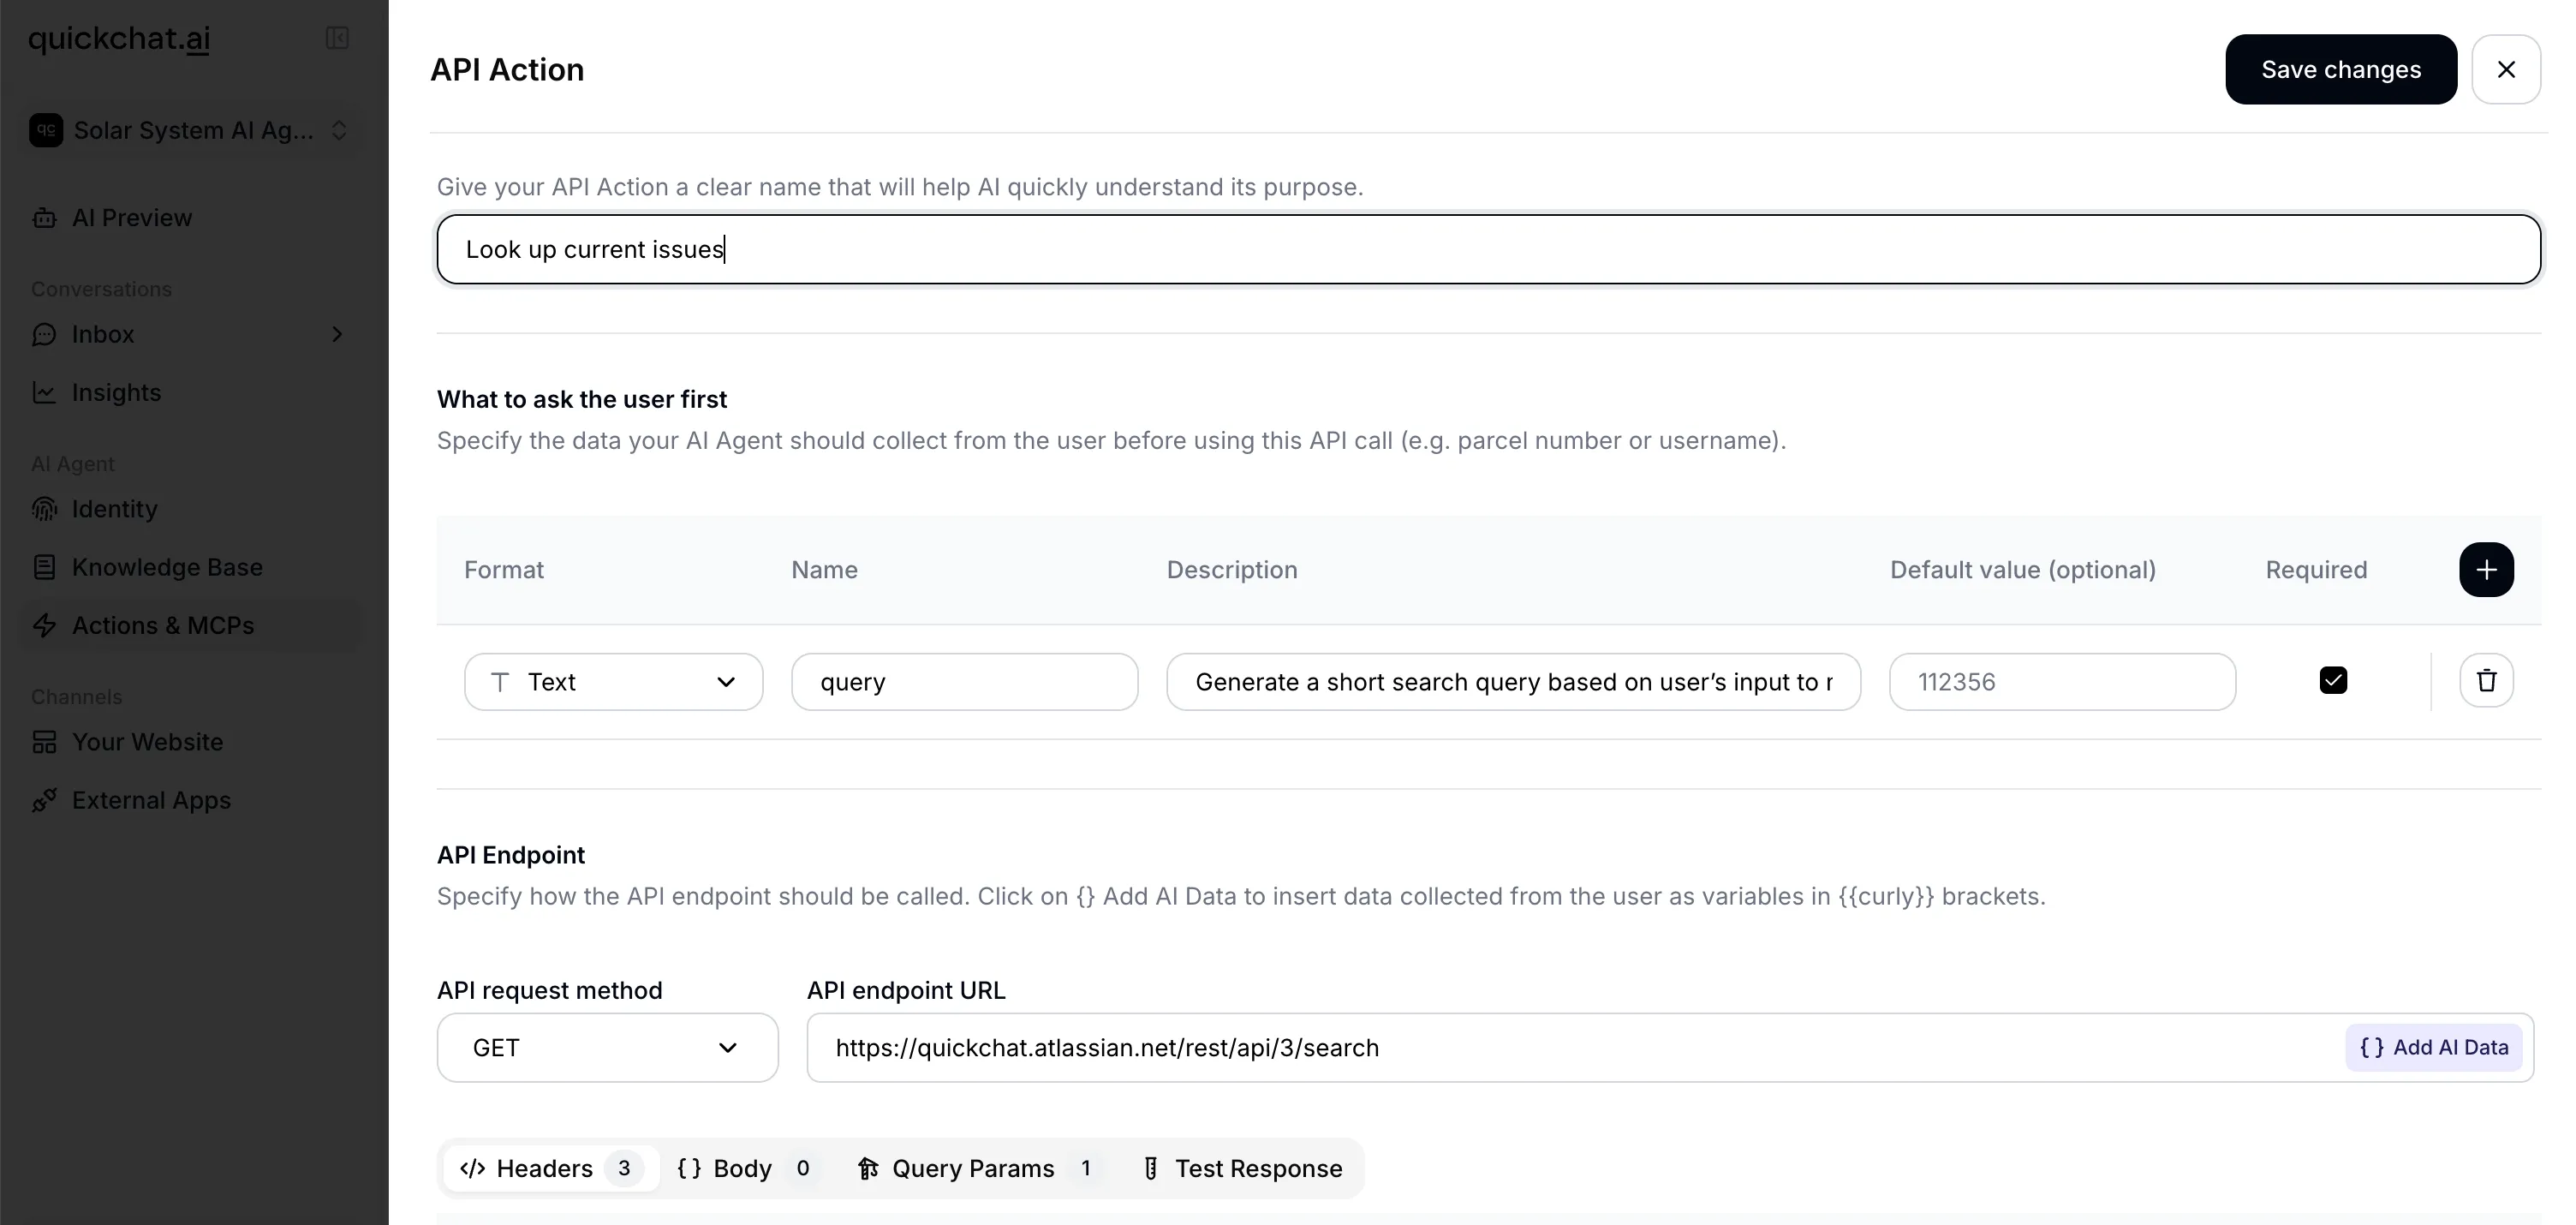 注文ステータスを確認するように設定されたAI Action。パラメータプレースホルダーを含むURLテンプレート、ヘッダー、パラメータ定義が表示されています。
内部の仕組み: Quickchat AIは、各AI Actionについて、パラメータ定義から型付きスキーマを動的に構築します。サポートされる5つの型 (str、int、float、bool、custom) はネイティブ相当の型にマッピングされ、このスキーマはHTTPリクエストを行う前にLLMの入力を検証するために使用されます。
注文ステータスを確認するAI Actionの例:
{
  "name": "check_order_status",
  "description": "ユーザーが注文ステータスについて質問し、注文番号を提供している場合、このエンドポイントを呼び出して現在のステータスを取得します。ステータス、配送予定日、追跡番号 (利用可能な場合) をユーザーに報告します。",
  "method": "GET",
  "url": "https://api.example.com/orders/{{order_id}}",
  "headers": [
    { "name": "Authorization", "value": "Bearer YOUR_API_KEY" },
    { "name": "Content-Type", "value": "application/json" }
  ],
  "parameters": [
    {
      "name": "order_id",
      "description": "ユーザーが提供した注文ID (例: ORD-12345)",
      "type": "str",
      "is_required": true
    }
  ]
}
Testing: ダッシュボードには”Test”ボタンがあり、サンプルのパラメータ値を指定して、デプロイ前に実際のHTTPリクエスト (生成されたcurlコマンドを含む) とレスポンスを確認できます。
効果的なAI Action説明を書くためのヒント:
- エージェントがいつ呼び出すべきかを具体的に記述します: 「ユーザーが注文ステータスについて質問し、注文番号を提供した場合、このエンドポイントを呼び出します」
- 最初に収集すべき情報を明記します: 「呼び出す前に、ユーザーのメールアドレスと注文IDがあることを確認します」
- レスポンスの扱い方を説明します: 「ステータスが’shipped’の場合、レスポンス内の追跡番号をユーザーに伝えます」
- 複数ステップのワークフローでは、個別のアクション説明ではなく、エージェントのメインのシステムプロンプトにシーケンスを記述します。また、アクション間で値を保持し、それに基づいて書き込みを制御するには、Save to memoryと実行条件を使用します
実例: リード、未回答の質問、デモリクエストをスプレッドシートに直接記録する段階的なAI Actionについては、AIエージェントをGoogle Sheetsに接続する方法を参照してください。
Generate from Text: AIに判断させる
3つ目の選択肢は、エージェントに何をさせたいかは分かっているが、どのAPIエンドポイント (あるいはどのサービス) を使えばよいか分からないユーザー向けです。
仕組み:
- 自然言語でやりたいことを入力します。例: 「ユーザーが依頼したときに、AI AgentがそのユーザーのTeslaを起動できるようにしたい」
- Quickchat AIは、
web_searchツールを有効にしたLLMへこれを送信します - モデルはウェブを調査して適切なAPIを見つけ、公式ドキュメントを読み、URL、メソッド、ヘッダー、パラメータ、認証要件を含む完全なAI Action仕様を生成します
- 結果として、完全なアクション設定、使用したドキュメントへの引用、前提と不足点を説明するメッセージが返されます
- 内容を確認し、認証情報を入力して有効化します
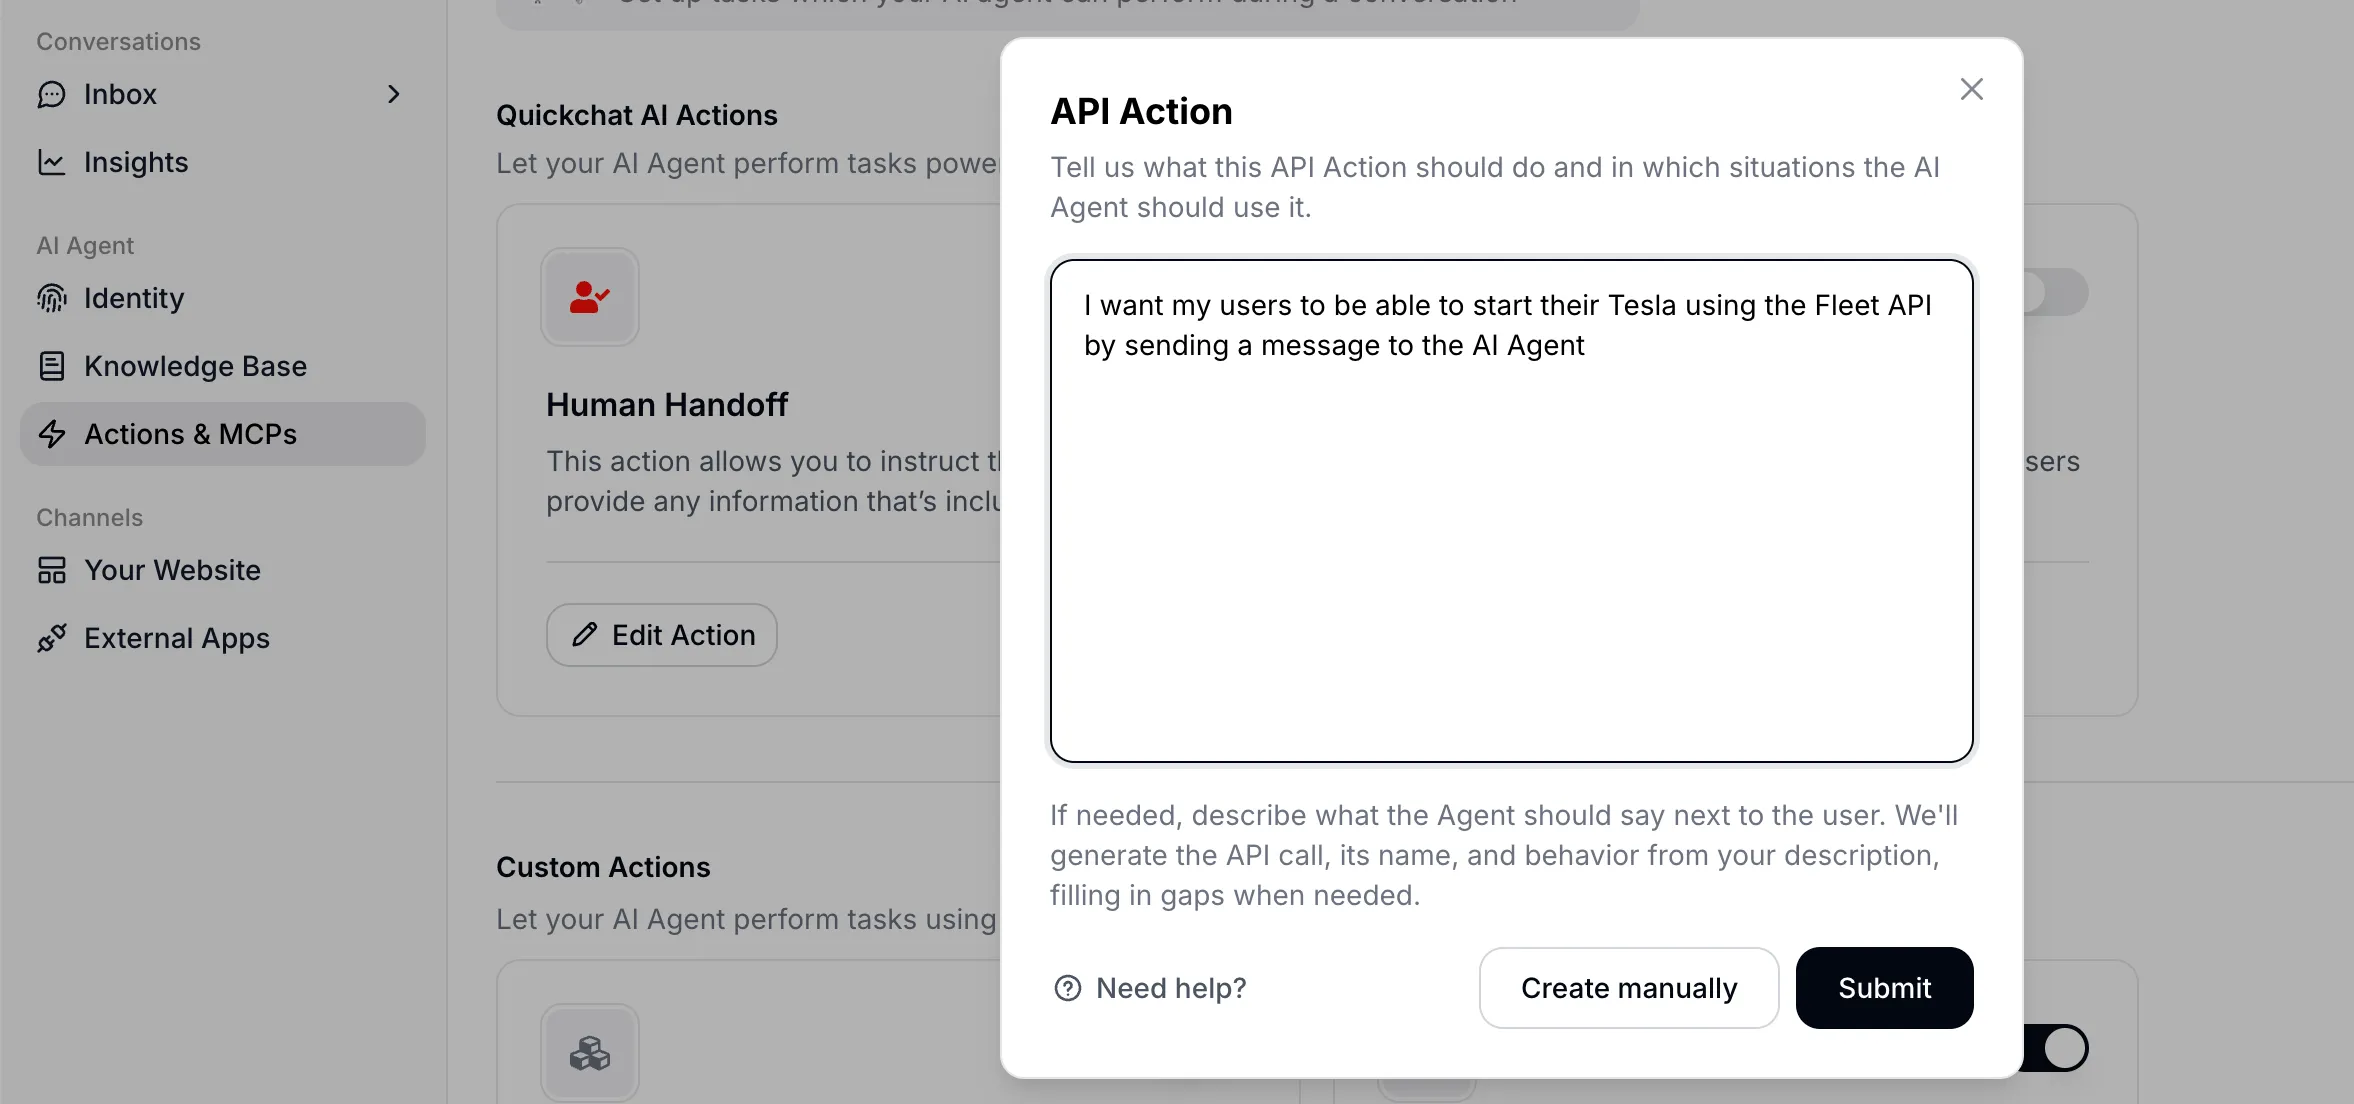 必要なケイパビリティの自然言語説明を入力しています。
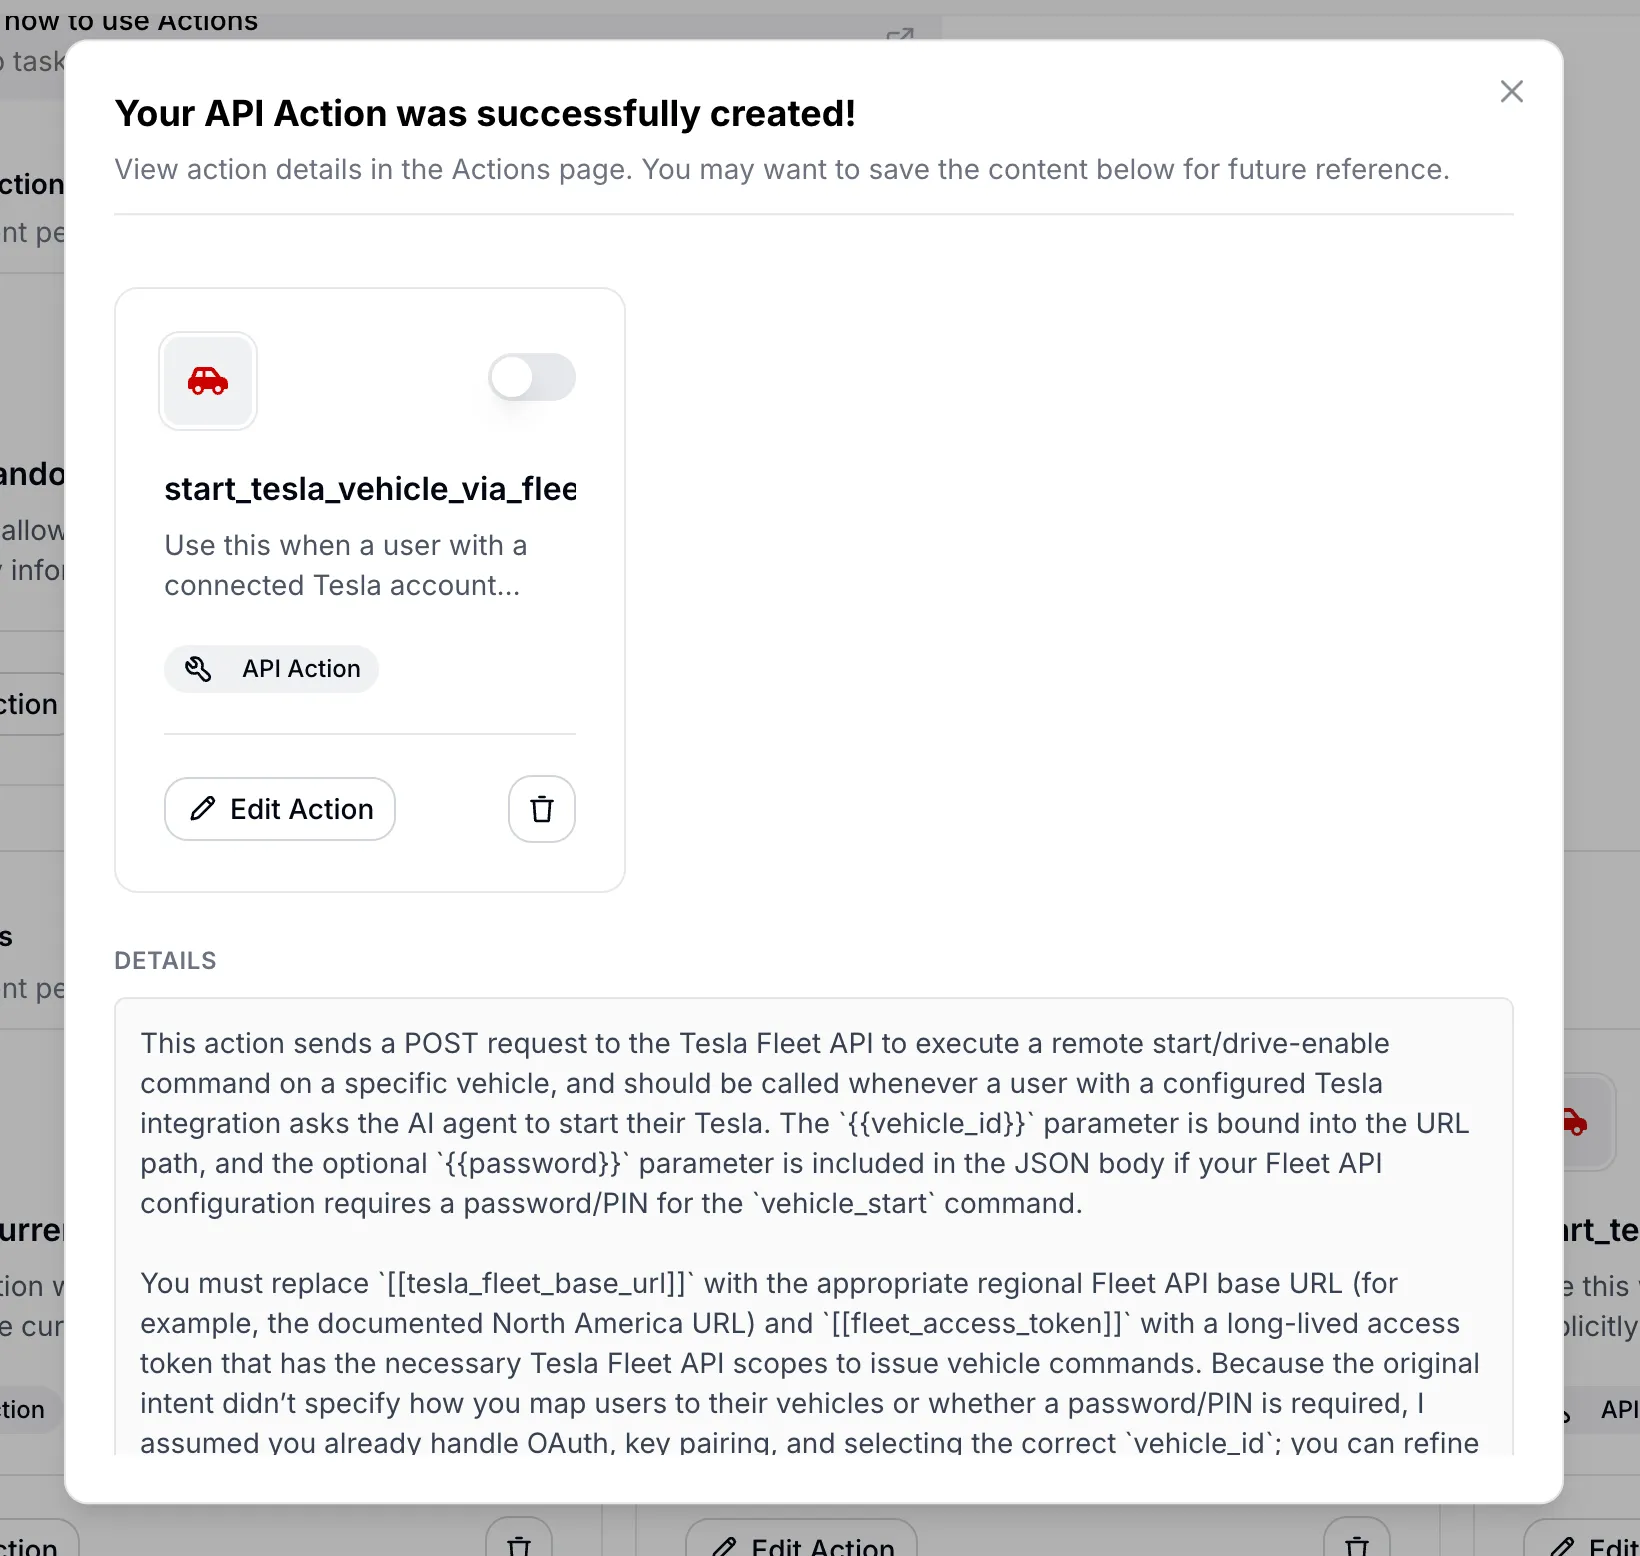 使用されたAPIドキュメントへの引用付きで生成されたAI Action設定。
自動AI Action生成は、3つの優先事項を中心に構成されています。
- 優先事項1: 意図を理解する。 開発者が求める正確なケイパビリティと、それを提供する具体的なAPIエンドポイントを特定します
- 優先事項2: ドキュメントに基づく。 推測ではなく、ウェブ検索を使って公式ベンダードキュメントを見つけます
- 優先事項3: 会話優先のセマンティクスを設計する。 生成される名前と説明は、APIが技術的に何をするかだけでなく、このツールが_会話のどの場面で_使われるかを表すべきです
プロンプトは2種類のプレースホルダー規約を使用します。{{param}}は、LLMが会話コンテキストから埋めるランタイムパラメータを示します。[[secret_name]] (二重角括弧) は、APIキーやアカウントIDなど、有効化前に開発者が手動で設定する必要がある定数を示します。すべてのパラメータ名は、リクエスト定義内のどこかに{{that_exact_name}}プレースホルダーとして現れる必要があり、孤立したプレースホルダーは許可されません。
システムはフェイルクローズ方針を使用します。モデルがドキュメントから重要な情報 (HTTPメソッド、URL、認証方式、必須ペイロード構造) を確認できない場合、アクションは作成されません。代わりに、推測せず、不足している情報について簡潔な説明を返します。
ここで、AIエージェントがAPIを発見するという哲学的な論点が、具体的なプロダクト機能につながります。Generate from Text機能は、文字どおりAIエージェント (ウェブ検索付きLLM) が、別のAIエージェント (会話内でそれを使うQuickchat AIエージェント) のためにツール定義を構築するものです。
実例: 入力した2文から2つのライブでテスト済みのアクション (キー不要の天気取得と、キー付きのNASAアクション、フェイルクローズの拒否を含む) を作成する完全なチュートリアルについては、平易な英語でAIエージェントを任意のAPIに接続する方法を参照してください。
実行時には、これらすべてのツールタイプがまとめて組み立てられます。Quickchat AIは、HTTPリクエストAI Actionツール、Shopify MCPツール、ナレッジベースツール、remote MCPツール、Discordツール、その他のカスタムツールを収集し、LLMに提示するコレクションにします。モデルから見ると、それらに違いはありません。Remote MCPツールと手動設定されたAI Actionは、ツールリストに入った時点で同じように見えます。
新しいSEOとしてのオープンAPI
AIエージェントがAPIを自律的に発見し、使用するようになるなら、十分に文書化され、使いやすいAPIを持つことは流通上の資産になります。Gartnerは、2026年までにAPI需要増加の30%超がAIエージェントに由来すると予測しています。
最小限の認証情報の壁でオープンAPIを提供している企業は、自社APIが最良の獲得チャネルになる可能性があります。Google検索のインプレッションではなく、ここでの「インプレッション」は、AIエージェントが競合ではなくあなたのサービスを選んで使用することです。
同じ論理は1つ上のレベルにも当てはまります。ドキュメントから回答するAIエージェント自体を、ChatGPT、Claude、Cursorがツールとして呼び出すMCPサーバーとして公開することができます。これにより、APIだけでなく、あなたの知識もエージェント型ウェブから発見可能になります。
APIドキュメントの品質は、AIエージェントが1回の試行であなたと正常に連携できるかどうかを決定します。 パラメータ説明、エラーメッセージ、レスポンス例は、従来のSEOにおけるメタディスクリプションや構造化データと同じ機能を果たします。分かりにくいエラーレスポンスや、文書化されていない必須フィールドがあると、エージェントは失敗します。そして反対側には、それをデバッグする人間はいません。
APIが文書化されていない、または重い認証要件の背後にある企業は、2000年代にウェブサイトを持たない企業がGoogleから見えなくなったのと同じように、エージェント型ウェブから見えなくなる可能性があります。
Computer UseとAPI
AIモデルに「computer use」 (ボタンをクリックする、フォームに入力する、UIを操作する) を教えるために、大きな投資が行われています。Anthropic、OpenAI (Operator)、Browser Useのようなオープンソースプロジェクトはいずれも、この機能のバージョンを提供しています。
しかし、ブラウザ使用はAPIが存在しない場合の回避策です。POST /orders呼び出しはミリ秒単位で実行され、構造化データを返します。チェックアウトフローを操作するブラウザエージェントは数分かかり、ボタンが左に3ピクセル動いただけで壊れる可能性があります。APIはより高速で、より決定的で、実行コストも低くなります。
反論も妥当です。すべてにAPIが存在するわけではありません。レガシーシステム、API面を持たないエンタープライズソフトウェア、GUIで制御される物理デバイスなどです。そのような場合、computer useは実際のギャップを埋めます。
「これにはAPIがありません」に対するより良い長期的な対応は、おそらくAIにGUIを使わせることではなく、APIを構築することです。AIエージェントがAIエージェントのために書くソフトウェアが増えるにつれ、APIの構築と保守のコストは低下します。APIを構築するよりUIをスクレイピングする方が安いとした経済計算は変わりつつあります。
セキュリティの観点もあります。Simon Willisonの”lethal trifecta”は、プライベートデータへのアクセス + 信頼できないコンテンツへの露出 + 外部通信という危険な組み合わせを説明しています。これはどちらのアプローチにも当てはまりますが、APIベースのツールの方が監査と制約が容易です。すべてのAPI呼び出しをログに記録し、すべてのパラメータを検証し、すべてのエンドポイントにレート制限をかけることができます。何でもクリックできるブラウザエージェントに対して同等のことを行うのは、はるかに困難です。
物理世界のためのツール
ここまで議論してきたことはすべてソフトウェアに関するものです。同じパターンは物理世界にも現れます。
Google DeepMindのRT-2とGemini Roboticsは同じアーキテクチャを使用しています。ただし、ツールはAPIではなくアクチュエーターへディスパッチされます。SPCA (Sense-Plan-Code-Act) フレームワークは、これをロボティクス向けに形式化しています。環境をスキャンし、アプローチを計画し、実行可能なコードを生成し、それを実行し、結果を観察します。
「机の上の植物を右に動かす」ためのAPIはありません。しかし、カメラを備えたロボットであれば、move_object(object_id="plant_01", direction="right", distance_cm=15)をその場でツールとして定義し、それを呼び出すことができます。このツール定義は、推論レイヤーと物理実行レイヤーの間のインターフェースとして機能します。これは、ソフトウェアにおいてAPIエンドポイントが果たす役割と同じです。
LLM + ツール + ループのアーキテクチャは汎用的です。現在はソフトウェアで実装するのが最も簡単ですが、ロボティクスも追いつきつつあります。
AIによって、AIのために書かれるAPI
およそ2年 (2024年から2026年) の間に、コードの大部分が人間によって書かれていた状態から、コードの大部分がAIによって書かれる状態へ移行しました。これは、APIエンドポイントとは何かを考え直す良いタイミングです。エンドポイントはますます、人間の開発者がドキュメントを読み、その後手動で連携するための技術的インターフェースではなく、機械によって発見され、実行されることを前提に設計されたケイパビリティ宣言になっています。
MCPは有用な標準化レイヤーですが、バイアスを持ち込むキュレーションレイヤーでもあります。MCP作成者が、どのツールを公開するか、それをどう位置づけるかを決定します。本番環境のAIエージェントでは、その位置づけが実際に必要なものと一致しない場合があります。(この点については、ShopifyのMCPに関する課題を分析した際に詳しく書きました。)
Quickchat AI Agentsで見てきたスペクトラムは、より広い論点を反映しています。適切な制御レベルはユースケースによって異なります。Remote MCPは迅速なプロトタイピングに適しています。個別のAI Actionsは、本番環境の顧客対応エージェントに対して細かな制御を提供します。Generate from Textは、まだ探索段階にあるときに、AIにAPIを調査させ、ツール定義を構築させることができます。
そして、どのレベルでも基礎となるパターンは同じです。LLM、ツールセット、ループです。ツールがbashコマンドであれ、APIエンドポイントであれ、MCPサーバーであれ、ロボットのアクチュエーターであれ、下までずっとツールです。