

När LLM:er lärde sig att anropa funktioner
Under GPT-3-eran innebar interaktion med en LLM att du gav den en prompt och fick text tillbaka. Modellens kunskap var stor men statisk, låst till det som fanns i träningsdata. Du kunde be den förklara kvantdatorer eller skriva ett utkast till ett mejl, och den producerade trovärdig text. Men den kunde inte kontrollera dagens väder, fråga en databas eller utföra någon åtgärd i den verkliga världen.
Funktionen som ändrade detta får förvånansvärt lite erkännande. Den gav modellen ett val mellan att generera text och anropa en funktion. I stället för att alltid producera nästa token kunde modellen nu mata ut ett strukturerat JSON-objekt som angav ett funktionsnamn och dess argument. Runtime-miljön körde funktionen, matade tillbaka resultatet till modellen, och modellen fortsatte därifrån. ReAct-artikeln (Yao et al., 2022) formaliserade detta som Thought-Action-Observation-loopen. Modellen resonerar om vad den ska göra, vidtar en åtgärd (anropar ett verktyg), observerar resultatet och upprepar. Varje seriös AI-agent 2026 kör någon version av detta mönster.
Loopen
Claude Code, OpenClaw, Codex, Devin och dussintals andra agentiska system fungerar alla på samma sätt. Anropa ett verktyg, observera resultatet, bestäm nästa steg, upprepa. Simon Willison formulerade det väl: “En LLM-agent kör verktyg i en loop för att uppnå ett mål.”
Claude Code använder till exempel en single-threaded master loop utan multi-agent-svärm eller komplex orkestreringsgraf: while(tool_call) -> execute -> feed results -> repeat.
Anthropics forskning om agentautonomi visar att turernas längd i Claude Code nästan fördubblades på tre månader, från 25 till över 45 minuter. Användare litar i allt högre grad på att loopen kör på egen hand. Data visar att erfarna användare avbryter oftare (en förskjutning från godkännande per åtgärd till strategisk övervakning), medan agenten själv ber om förtydliganden mer än dubbelt så ofta som användarna avbryter den.
Detta loopmönster finns överallt, i kodningsagenter, kundsupportbotar och robotikstyrenheter.
Vad räknas som ett verktyg?
LLM:er ger oss stor frihet att bestämma vilken abstraktionsnivå ett verktyg ska arbeta på. I ena änden finns mycket specifika API-endpoints: “skapa en HubSpot-kontakt med dessa 12 fält.” I den andra finns verktyg som “kör detta bash-kommando” eller “kör denna Python-kod”, vilket i praktiken betyder “gör vad du vill.”
Devin arbetar med tre verktyg: shell, code editor, browser. Claude Codes primära verktyg är också ett shell. OpenClaw använder ett dynamiskt plugin-system för färdigheter. Trenden inom agentiska kodningsverktyg har gått mot färre och mer generella verktyg snarare än många specifika.
Simon Willison observerade att MCP “exploderade initialt men kändes sedan mindre centralt” för kodningsagenter eftersom bash är det universella verktyget. Filer och skript är en primitiv med lägre overhead än fullständiga MCP-serverimplementationer. Om agenten kan skriva och köra kod kan den göra nästan vad som helst utan att behöva en dedikerad verktygsdefinition.
Men generella verktyg fungerar för generella agenter. För domänspecifika AI-agenter (kundsupport, försäljning, intern drift) behöver du domänspecifika verktyg. Din supportagent ska inte skriva Python för att kontrollera en orderstatus. Den ska anropa en väldefinierad API-endpoint med tydliga parametrar och förutsägbara svar. Utformningen av din verktygsuppsättning blir ett produktbeslut.
| Tillvägagångssätt | Exempel | Kontroll | Flexibilitet | Användningsfall |
|---|---|---|---|---|
| Generellt verktyg | Bash, Python-interpreter | Minimal | Maximal | Kodningsagenter, personliga assistenter |
| Protokollpaket (MCP) | Shopify MCP, GitHub MCP | Medel | Medel | Snabb integration, prototyper |
| Enskild API-endpoint | ”Skapa HubSpot-kontakt” | Maximal | Minimal | Kundnära agenter i produktion |
Vad en API-endpoint betyder nu
För AI-agenter fungerar en API-endpoint som en kapabilitetsdeklaration. Att publicera en sådan säger att du (eller din AI-agent) nu kan göra något som inte var möjligt tidigare.
Det fungerar i båda riktningarna. En mjukvaruleverantör publicerar ett API så att andra kan integrera med produkten. Men en AI-agent kan också upptäcka endpoints på egen hand genom att söka i dokumentation, läsa OpenAPI-specifikationer eller bokstavligen googla hur en uppgift ska utföras.
En MCP-server är ett kurerat paket av API-endpoints med en förutbestämd uppfattning om hur de ska användas. MCP-skaparen har redan fattat beslut om vilka endpoints som ska exponeras, hur de ska namnges, vilka parametrar som ska lyftas fram och implicit vilka arbetsflöden som ska stödjas. Den kureringen är både styrkan (bekvämlighet, standardisering) och svagheten (stelhet, åsiktsstyrd avgränsning). Notions server är ett konkret exempel: den publicerar 28 verktyg, och en helpcenter-agent behöver fyra av dem, uppdelade över två anslutningar.
MCP:er byter kontroll mot enkel användning. År 2026 skriver AI det mesta av integrationskoden. Om en agent kan läsa API-dokumentation och skriva integrationen själv blir argumentet om “enkel användning” för MCP svagare. MCP-lagret kan vara viktigast under övergångsperioden, medan verktygen ännu inte har hunnit ikapp modellens kapacitet. Anthropics guide om designmönster för verktygsanvändning är en praktisk referens för att strukturera verktygsscheman oavsett om du använder MCP eller enskilda endpoints.
En relaterad utveckling: llms.txt är en föreslagen standard där webbplatser publicerar en /llms.txt-fil för att guida AI-modeller mot resurser med högt värde. Anthropic, Cloudflare, Docker och Stripe har infört den. MCP standardiserar verktygsanrop, llms.txt standardiserar upptäckt av dokumentation. Båda försöker göra webben mer läsbar för maskiner, från olika håll.
Vad är en API-endpoint i AI-agenters kontext?
En API-endpoint är en specifik URL som accepterar strukturerad input och returnerar strukturerad output. För AI-agenter representerar varje endpoint en avgränsad kapabilitet, något agenten kan göra i den verkliga världen. Endpointens beskrivning, parameterdefinitioner och felsvar fungerar som agentens instruktionsmanual. Ju bättre dokumenterad endpointen är, desto mer tillförlitligt kan en agent använda den.
Till skillnad från mänskliga utvecklare, som kan läsa handledningar och felsöka iterativt, förlitar sig en agent på endpointens schema och beskrivning för att göra ett enda korrekt anrop. Därför är API-dokumentation utformad för AI-konsumtion viktigare än någonsin. Endast 24% av utvecklare utformar för närvarande API:er med AI-agenter i åtanke, trots att 89% använder AI i sitt arbetsflöde.
Vad är MCP (Model Context Protocol)?
MCP är ett öppet protokoll introducerat av Anthropic som standardiserar hur AI-agenter ansluter till externa verktyg och datakällor. Tänk på det som USB-C för AI. En enda anslutning som alla verktygsleverantörer kan implementera och alla AI-agenter kan använda. En MCP-server exponerar en uppsättning verktyg (i praktiken API-endpoints) med standardiserade scheman, och en MCP-klient (agenten) kan upptäcka och anropa dem utan anpassad integrationskod. För en djupare teknisk förklaring, se vårt inlägg MCP förklarat. För en praktisk redogörelse för MCP i produktion, se vår analys av verkliga utmaningar med att bygga på Shopifys MCP.
Kontrollspektrumet i Quickchat AI
Quickchat AI ger dig tre sätt att utrusta en AI Agent med externa verktyg. De ligger på ett spektrum från mest automatiserat till mest kontrollerat. Varje metod gör en annan avvägning mellan snabb installation och exakt beteende.
Remote MCP: koppla in och kör
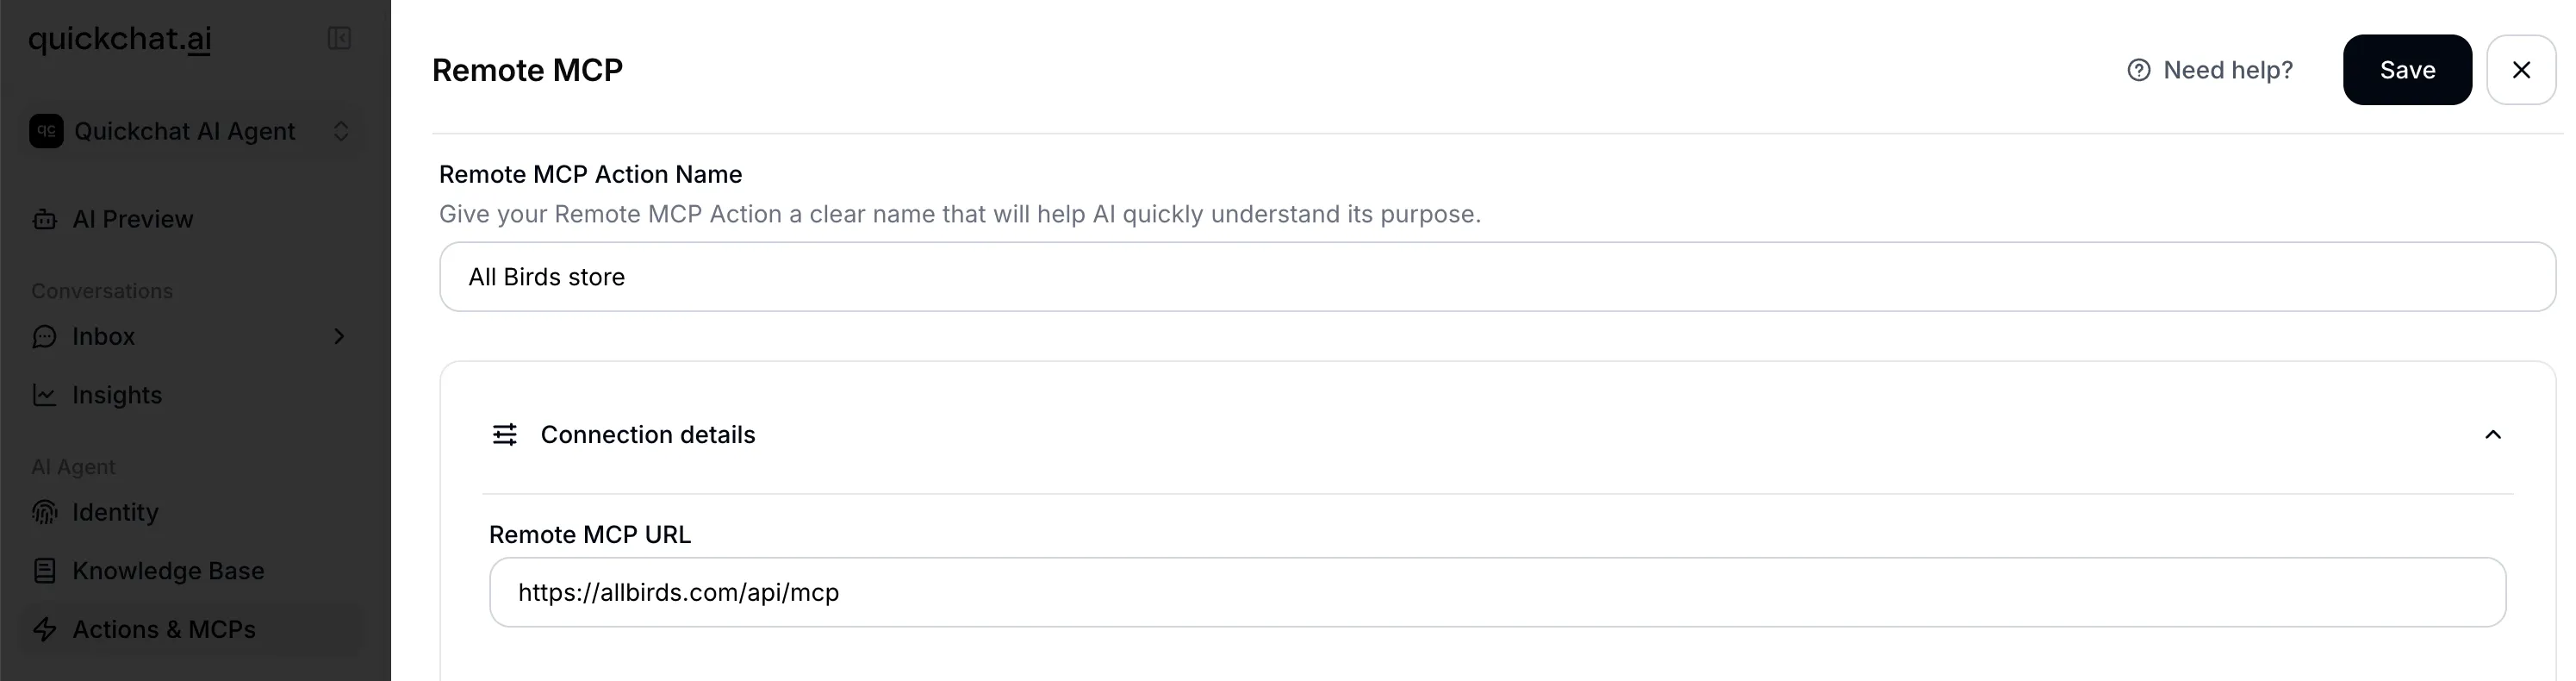
Remote MCP är det snabbaste sättet att ansluta en AI Agent till extern funktionalitet. Du anger en MCP-server-URL, Quickchat AI ansluter till den, upptäcker alla tillgängliga verktyg och låter dig välja vilka agenten ska använda.
Så konfigurerar du det:
- Gå till AI Actions i Quickchat AI dashboard
- Klicka på “Add Remote MCP”
- Klistra in din MCP-server-URL (t.ex.
https://mcp.example.com/sse) - Lägg eventuellt till en autentiseringstoken eller anpassade headers (de två utesluter varandra)
- Klicka på “Connect.” Quickchat AI upptäcker alla tillgängliga verktyg och visar deras namn
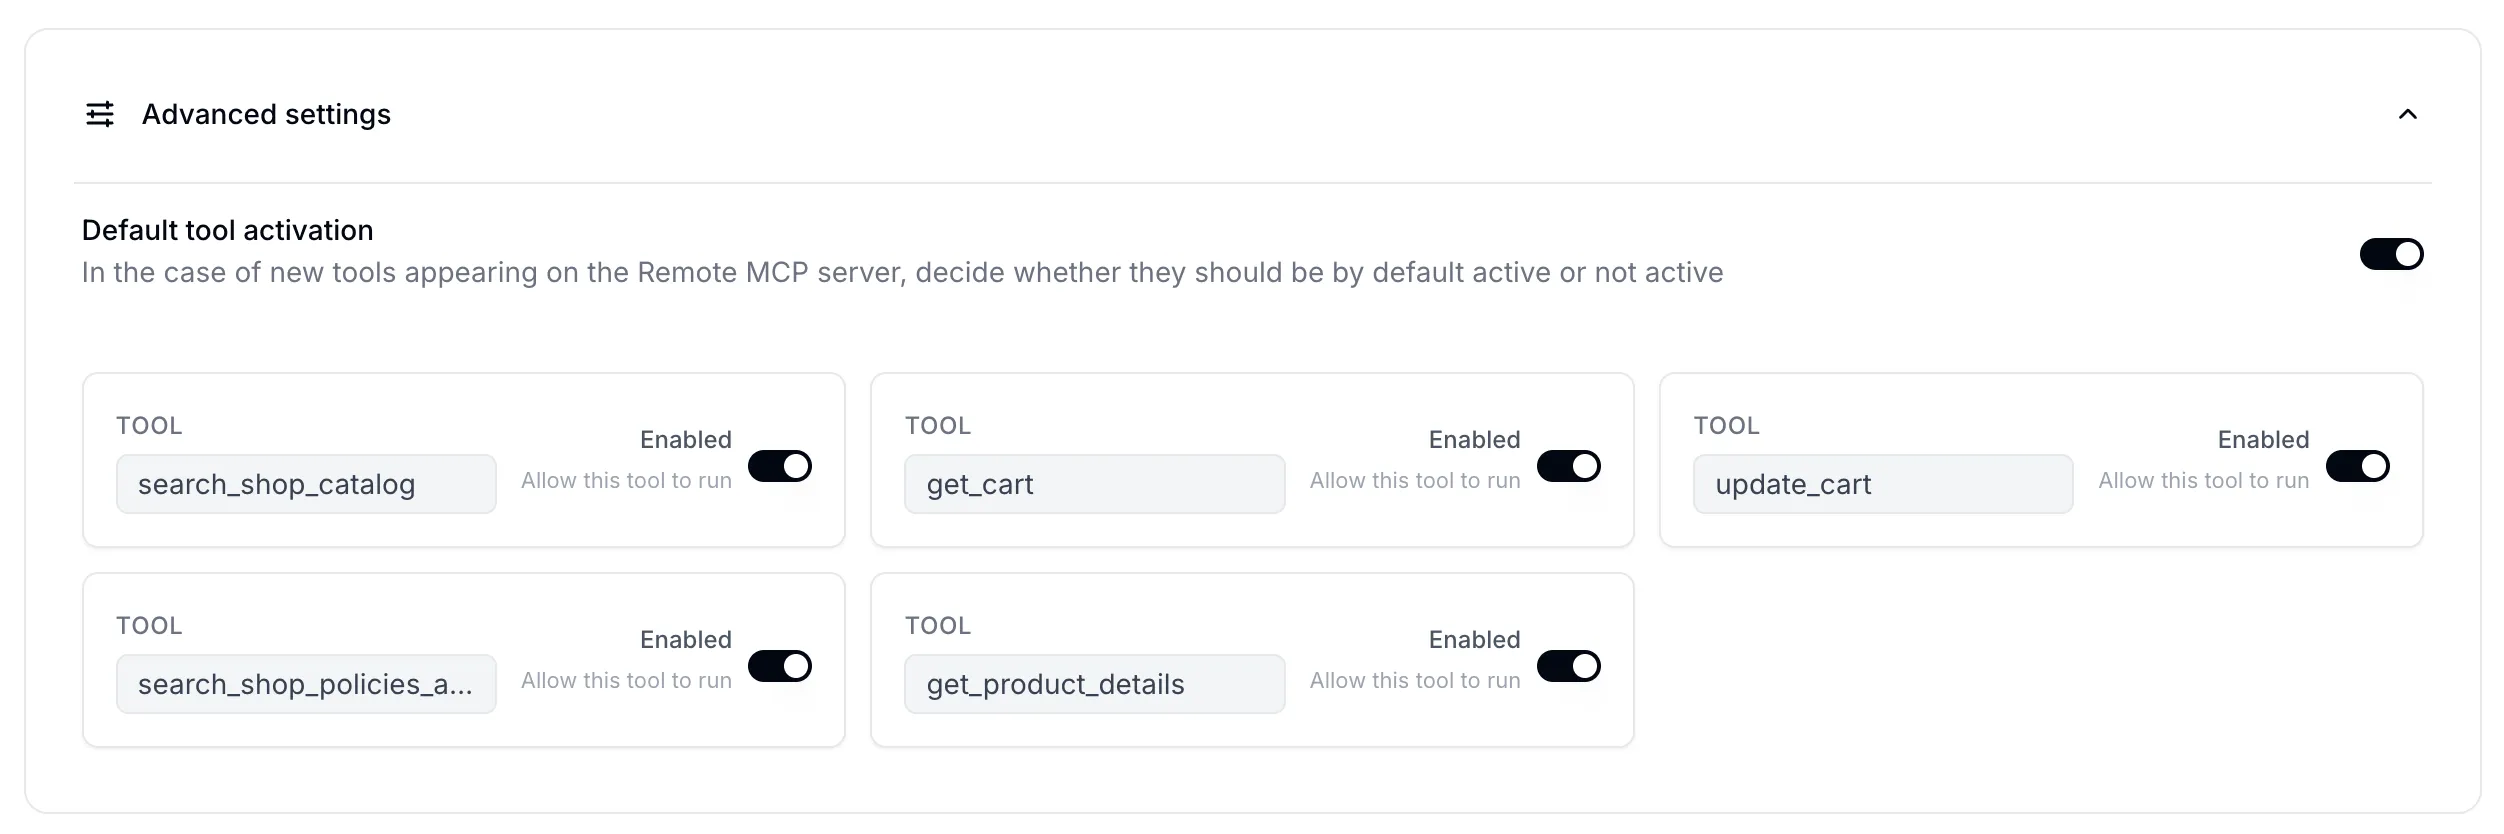
- Slå på eller av enskilda verktyg för att kontrollera vilka agenten kan använda
- Ställ in flaggan “default tool is active” för att kontrollera om nyupptäckta verktyg automatiskt aktiveras eller inaktiveras
Vad som händer under huven:
När du klickar på Connect autodetekterar Quickchat AI transportprotokollet från URL:en. Om URL:en innehåller sse används SSE-transport, annars är streamable_http standard. När du anger en auth token skickas den som en Bearer-token i headern Authorization.
Verktygsfiltrering fungerar genom ett system med tre nivåer. Varje verktyg från MCP-servern kontrolleras mot två uppsättningar: uttryckligen aktiverade verktyg inkluderas alltid, uttryckligen inaktiverade verktyg exkluderas alltid, och alla verktyg som inte finns i någon av uppsättningarna faller tillbaka på inställningen “default tool is active” som du valde. Det innebär att när en MCP-server lägger till nya verktyg styr du om de automatiskt blir tillgängliga för agenten eller kräver uttrycklig aktivering.
Vid runtime, när en konversation startar, laddas alla aktiva Remote MCP-anslutningar för agenten. Verktyg hämtas och filtreras enligt varje anslutnings konfiguration, och unika verktygsnamn verifieras över alla källor (med en varning om dubbletter hittas).
Avvägningen: du får omedelbar tillgång till allt som MCP exponerar, men du har begränsad kontroll över verktygsbeskrivningar, parameterdefinitioner eller hur agenten bestämmer sig för att använda dem. Som vi såg när vi byggde en AI Agent på Shopifys MCP kräver steget från demo till produktion noggrann finjustering som MCP:s paketerade metod kan göra svår.
Se även: anslut din agent till en remote MCP-server, Så lanserar du din Quickchat AI MCP, säkerhetsöverväganden för MCP, Quickchat AI docs: MCP channel.
AI Actions (HTTP Request): en endpoint, full kontroll
En AI Action i Quickchat AI är en enskild HTTP API-endpoint som du konfigurerar individuellt för din AI Agent. Där MCP importerar ett paket av verktyg på en gång ger varje AI Action dig full kontroll över en specifik kapabilitet. För ett komplett genomarbetat exempel med fyra actions som skapar och berikar kontakter, loggar deals och öppnar tickets i ett CRM, se HubSpot AI Actions-handledningen.
Konfigurera en AI Action:
- Name (max 64 tecken): detta blir verktygsnamnet som LLM:en ser. Det normaliseras till en giltig identifierare (t.ex. blir “Check Order Status”
Check_Order_Status) - Description (max 1 000 tecken): detta är det viktigaste fältet. Beskrivningen säger till LLM:en när den ska använda verktyget. Bra beskrivningar anger under vilka konversationsomständigheter verktyget ska anropas, vilken information som först ska samlas in från användaren och hur resultaten ska kommuniceras tillbaka
- HTTP method: GET, POST, PATCH, DELETE eller PUT
- URL (max 10 000 tecken): kan innehålla platshållare med
{{parameter_name}}för dynamiska värden - Headers: nyckel-värde-par för autentisering och content type
- Body items / Body JSON: request body med parameterinjektion
- Query parameters: URL query string-värden
- Parameters (max 10): var och en med ett namn, beskrivning (max 500 tecken), typ (
str,int,float,boolellercustom), en required-flagga och ett valfritt standardvärde
Platshållarna {{parameter_name}} är den centrala mekanismen. När LLM:en anropar verktyget anger den värden för varje parameter baserat på konversationens kontext. Quickchat AI injicerar sedan dessa värden i mallarna för URL, headers, body och query string innan HTTP-begäran görs. Det finns också fyra inbyggda variabler som kan injiceras på detta sätt: scenario_id, conversation_id, conversation_channel och conversation_url.
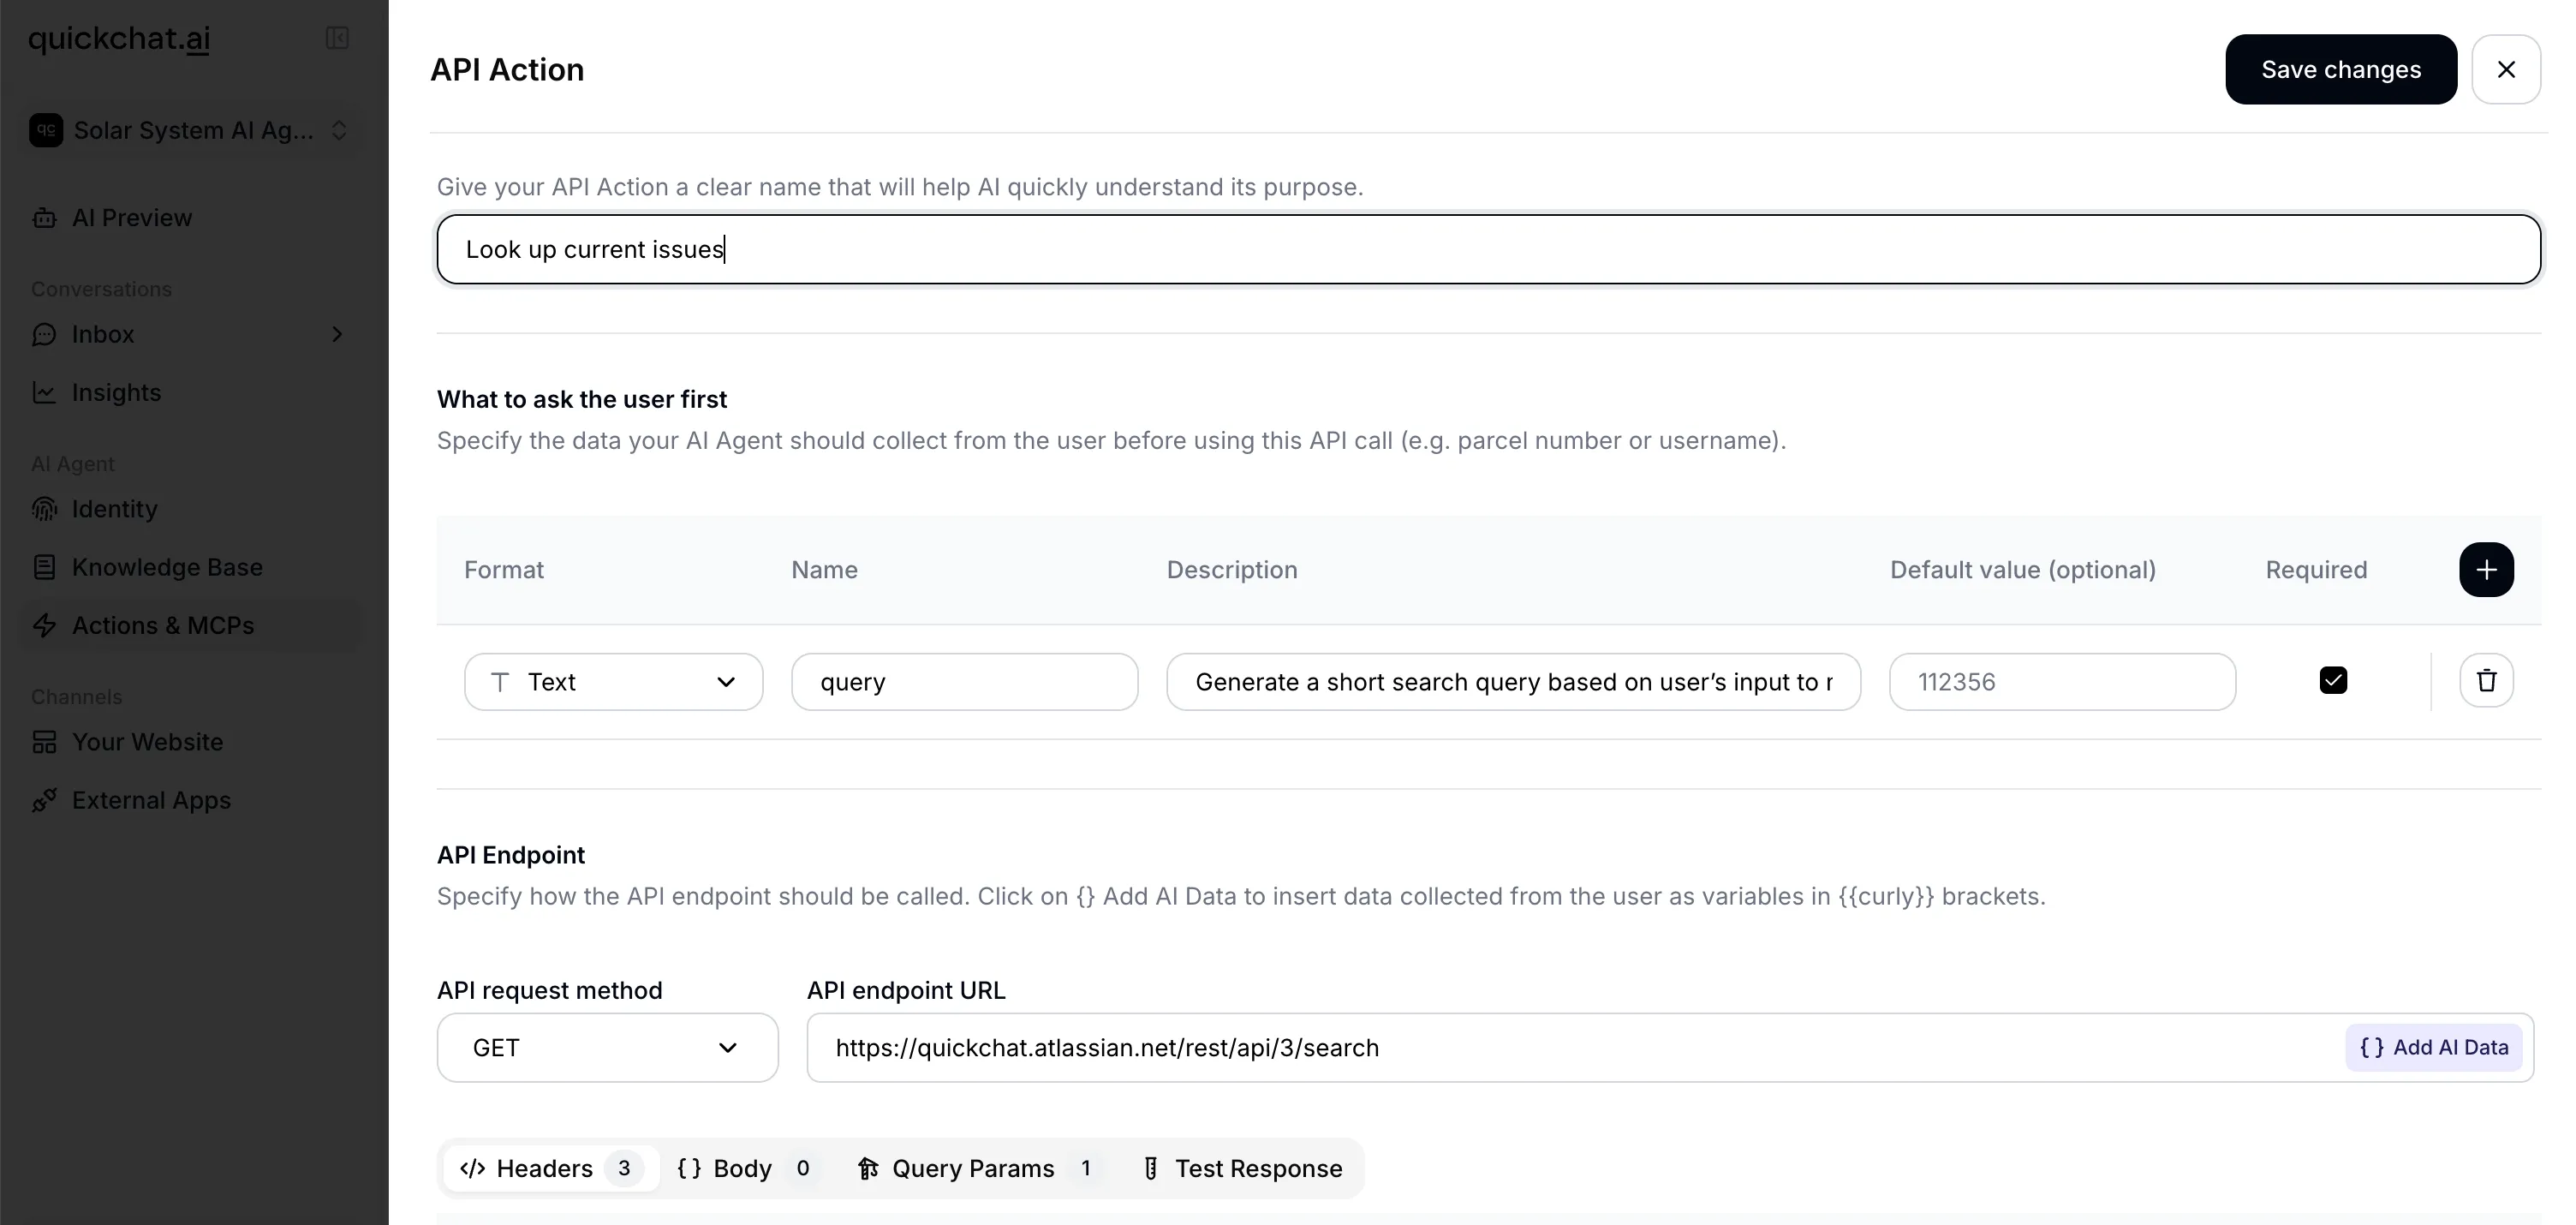 En AI Action konfigurerad för att kontrollera orderstatus, med URL-mall med parameterplatshållare, headers och parameterdefinitioner.
Under huven: Quickchat AI bygger dynamiskt ett typat schema från dina parameterdefinitioner för varje AI Action. De fem stödda typerna (str, int, float, bool, custom) mappas till sina inbyggda motsvarigheter, och detta schema används för att validera LLM:ens indata innan HTTP-begäran görs.
Ett exempel på AI Action för att kontrollera orderstatus:
{
  "name": "check_order_status",
  "description": "När användaren frågar om sin orderstatus och har angett ett ordernummer, anropa denna endpoint för att hämta aktuell status. Rapportera status, beräknat leveransdatum och spårningsnummer (om tillgängligt) tillbaka till användaren.",
  "method": "GET",
  "url": "https://api.example.com/orders/{{order_id}}",
  "headers": [
    { "name": "Authorization", "value": "Bearer YOUR_API_KEY" },
    { "name": "Content-Type", "value": "application/json" }
  ],
  "parameters": [
    {
      "name": "order_id",
      "description": "Order-ID:t som användaren har angett (t.ex. ORD-12345)",
      "type": "str",
      "is_required": true
    }
  ]
}
Testning: Dashboard har en “Test”-knapp som låter dig ange exempelvärden för parametrar och se den faktiska HTTP-begäran (inklusive ett genererat curl-kommando) och svaret innan driftsättning.
Tips för att skriva effektiva AI Action-beskrivningar:
- Var specifik om när agenten ska anropa den: “När användaren frågar om sin orderstatus och anger ett ordernummer, anropa denna endpoint”
- Nämn vilken information som ska samlas in först: “Innan anropet, säkerställ att du har användarens e-postadress och order-ID”
- Beskriv hur svaret ska hanteras: “Om statusen är ‘shipped’, berätta spårningsnumret från svaret för användaren”
- För flerstegsarbetsflöden, beskriv sekvensen i agentens huvudsakliga systemprompt i stället för i enskilda action-beskrivningar, och för att föra ett värde mellan actions och gate the write on it, använd Save to memory plus ett körvillkor
Ett genomarbetat exempel: för en steg-för-steg-AI Action som loggar leads, obesvarade frågor och demoförfrågningar direkt i ett kalkylblad, se hur du ansluter en AI-agent till Google Sheets.
Generate from Text: låt AI lösa det
Det tredje alternativet är för användare som vet vad de vill att agenten ska göra men inte vet vilken API-endpoint (eller ens vilken tjänst) som ska användas.
Så fungerar det:
- Du skriver en beskrivning på naturligt språk av vad du vill, t.ex. “Jag vill att min AI Agent ska kunna starta en användares Tesla när de ber om det”
- Quickchat AI skickar detta till en LLM med verktyget
web_searchaktiverat - Modellen undersöker webben för att hitta rätt API, läser officiell dokumentation och genererar en komplett AI Action-specifikation med URL, metod, headers, parametrar och autentiseringskrav
- Resultatet kommer tillbaka med den fullständiga action-konfigurationen, hänvisningar till dokumentationen den använde och ett förklarande meddelande som noterar antaganden och luckor
- Du granskar, fyller i dina inloggningsuppgifter och aktiverar
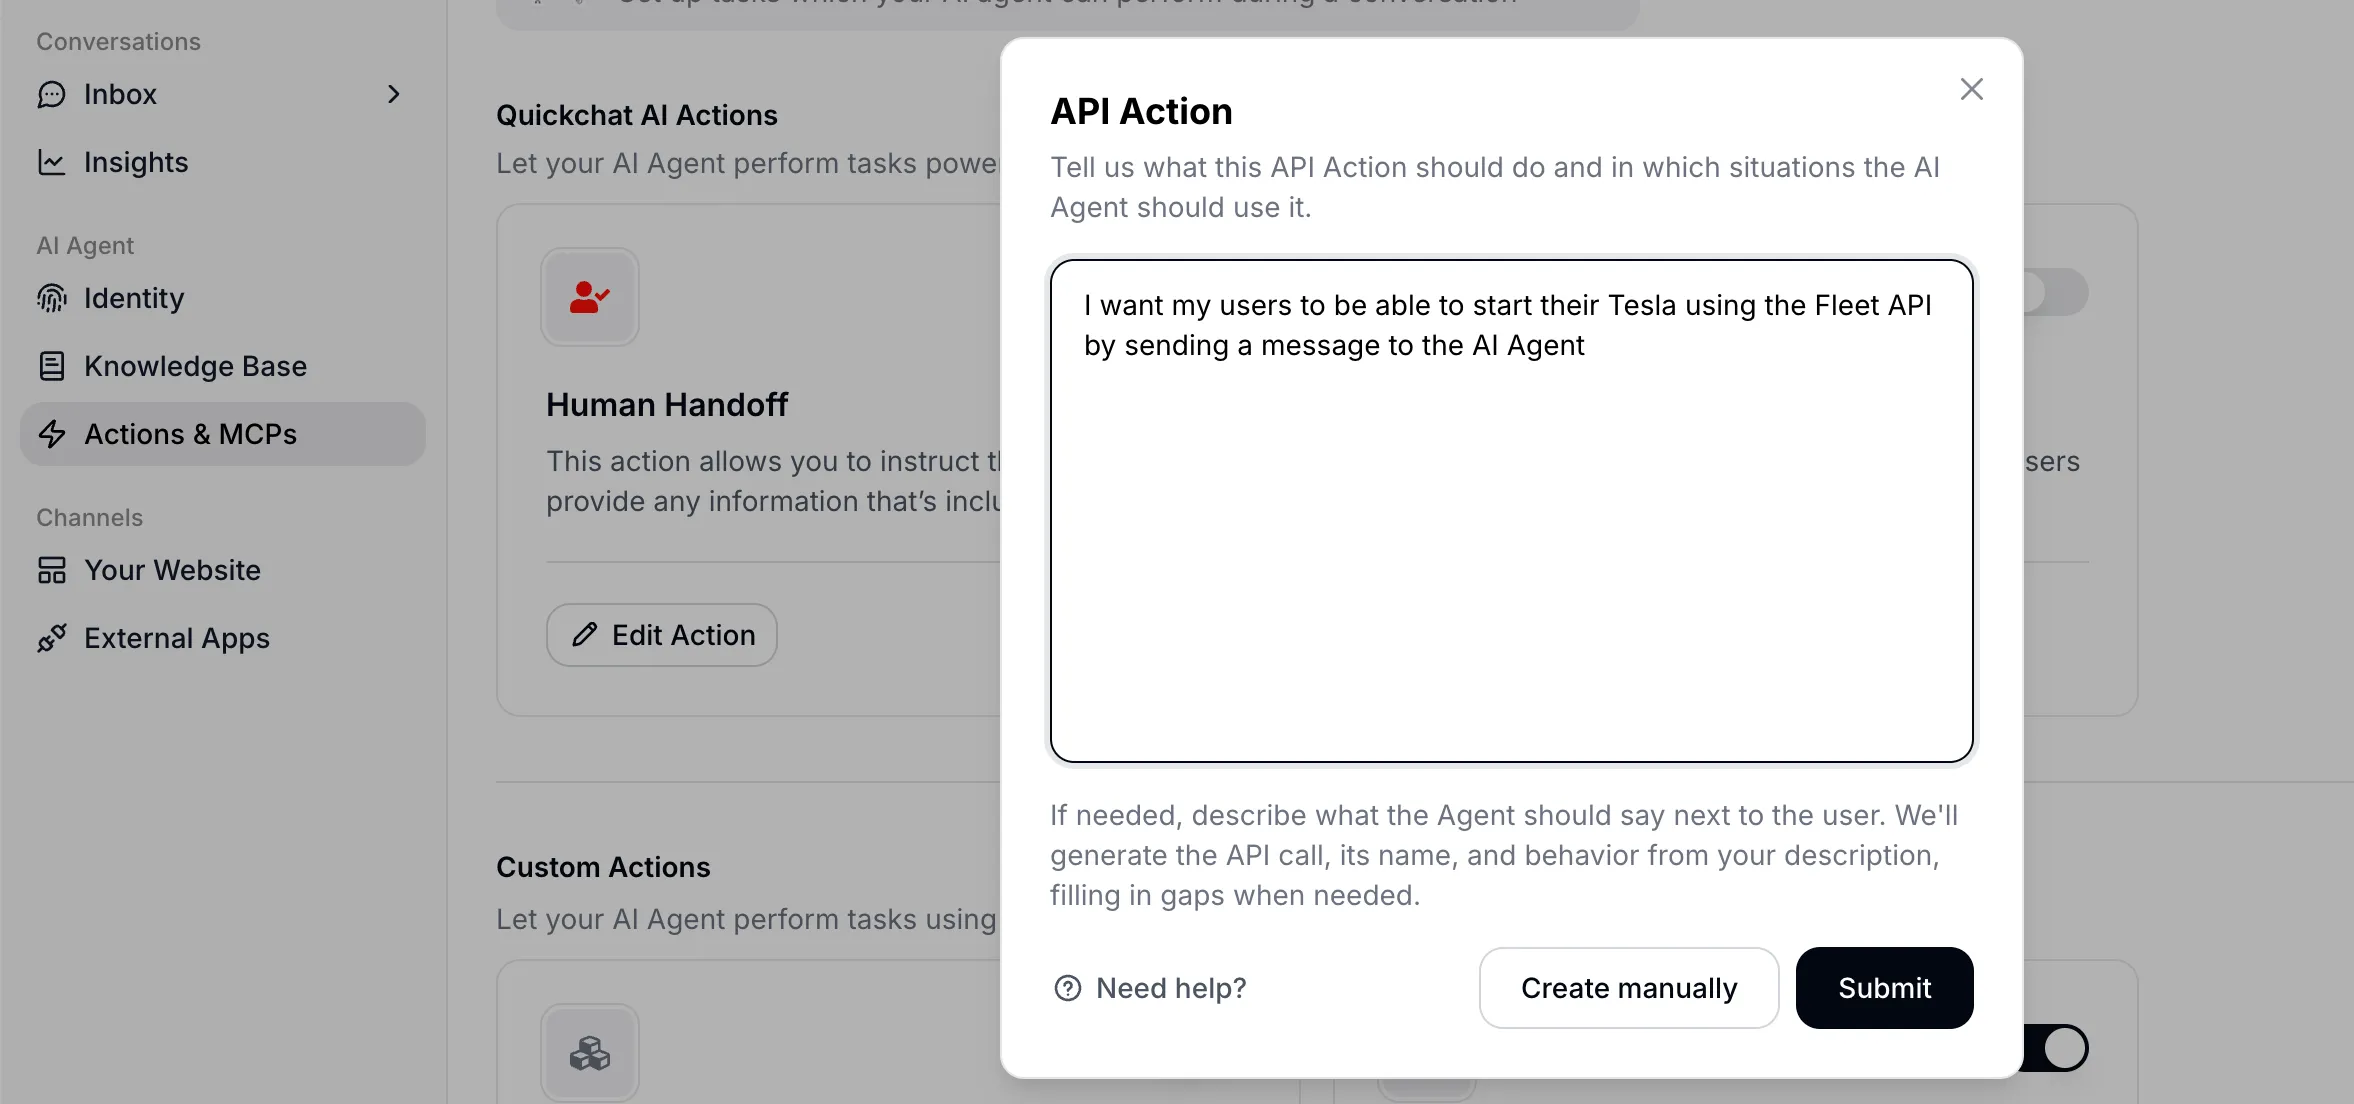 Inmatning av en beskrivning på naturligt språk av den önskade kapabiliteten.
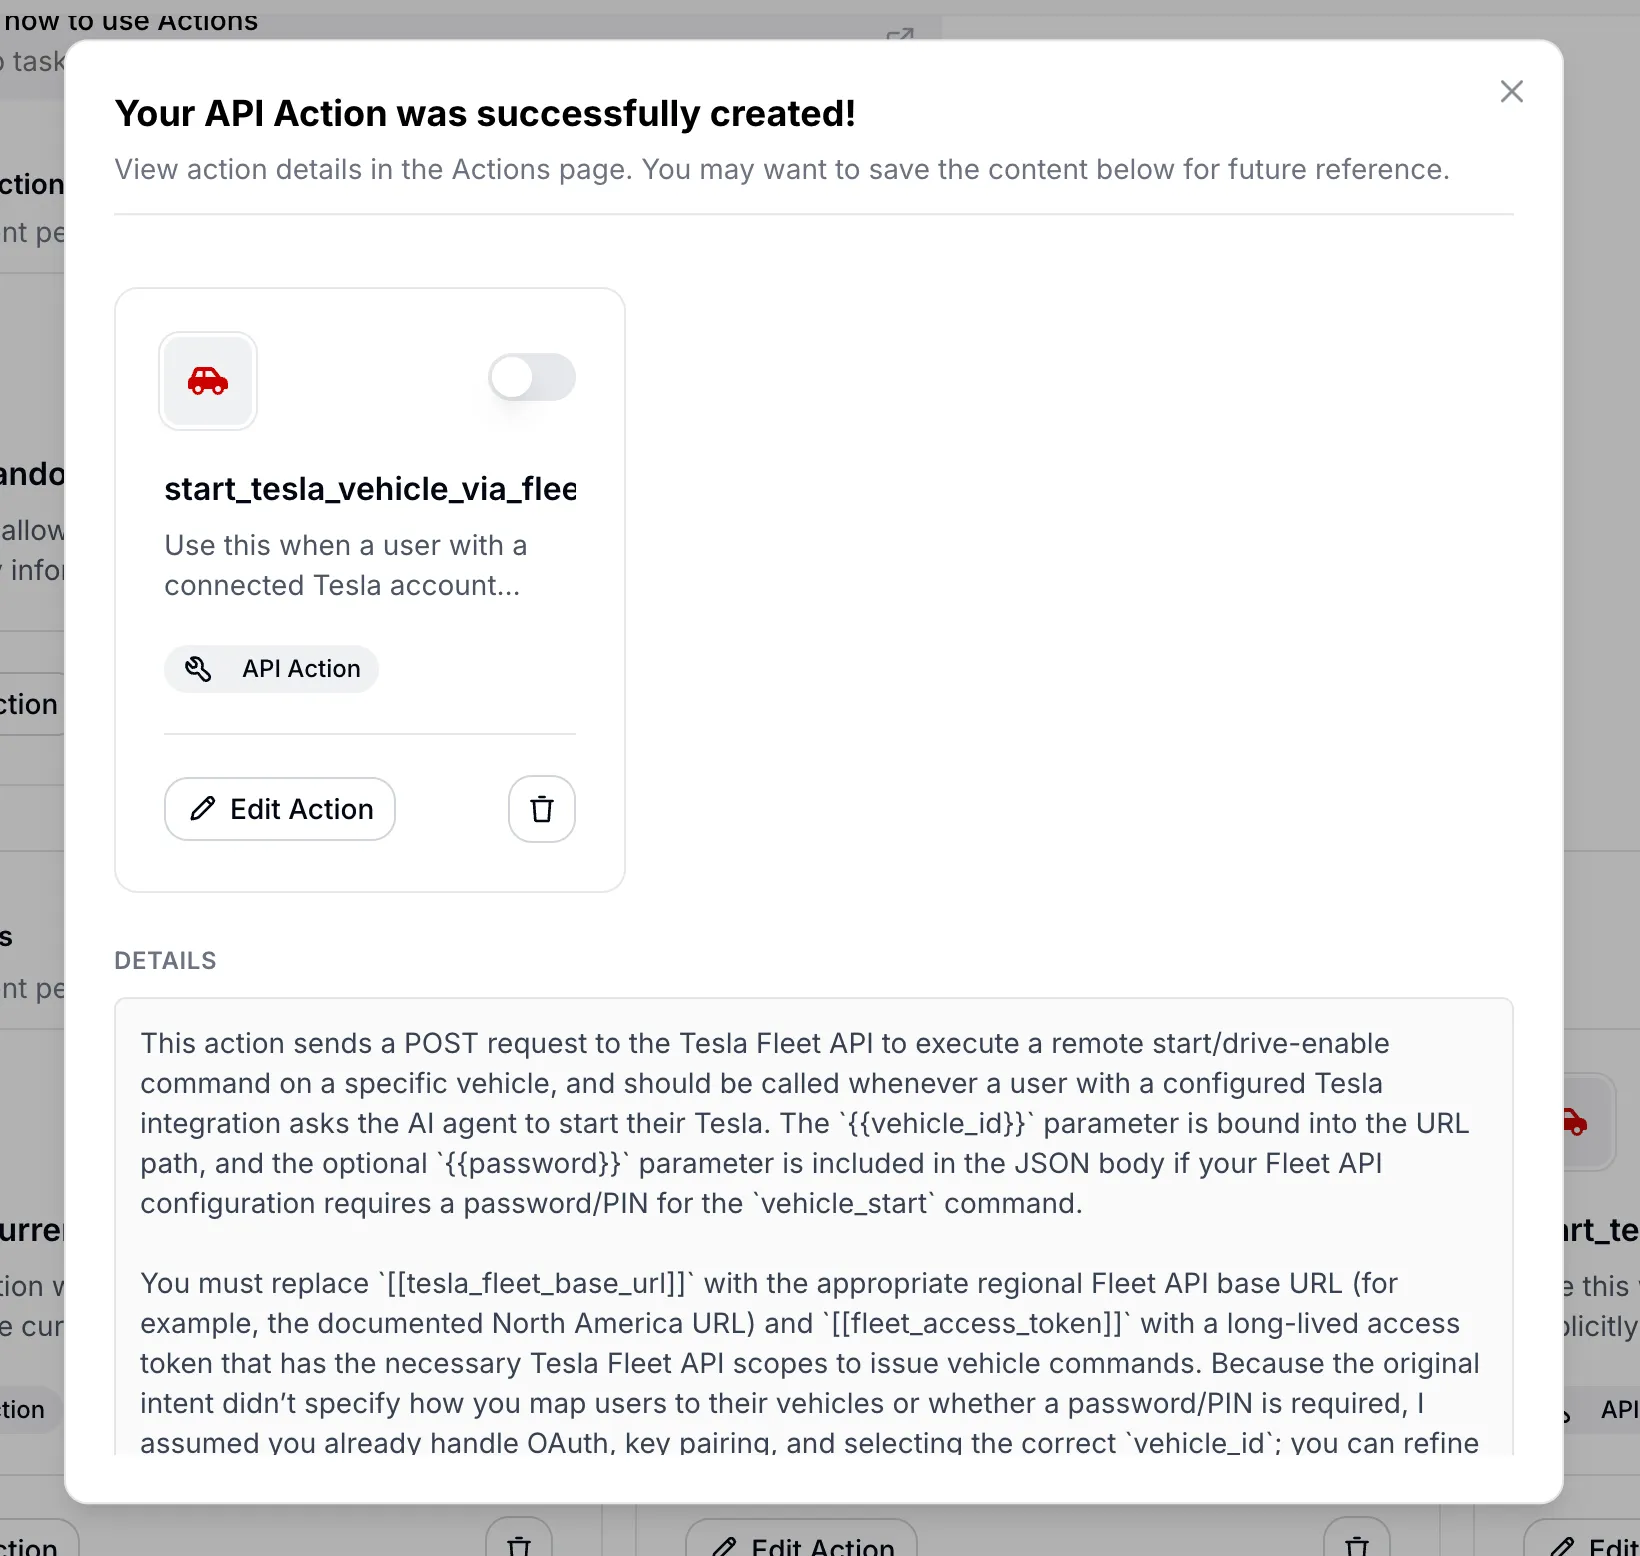 Den genererade AI Action-konfigurationen med hänvisningar till API-dokumentationen som användes.
Automatiserad AI Action-generering är strukturerad kring tre prioriteringar:
- Prioritet 1: Förstå avsikten. Identifiera den exakta kapabilitet som utvecklaren vill ha och den specifika API-endpoint som tillhandahåller den
- Prioritet 2: Förankra i dokumentation. Använd webbsökning för att hitta officiell leverantörsdokumentation, inte gissningar
- Prioritet 3: Utforma konversationsstyrd semantik. Det genererade namnet och beskrivningen ska handla om när i en konversation verktyget används, inte bara vad API:et gör tekniskt
Prompten använder två platshållarkonventioner. {{param}} markerar runtime-parametrar som LLM:en fyller från konversationskontext. [[secret_name]] (dubbla hakparenteser) markerar utvecklarkonstanter som API-nycklar och konto-ID:n som måste konfigureras manuellt före aktivering. Varje parameternamn måste förekomma som en {{that_exact_name}}-platshållare någonstans i request-definitionen, och föräldralösa platshållare tillåts inte.
Systemet använder en fail-closed-policy. Om modellen inte kan bekräfta en kritisk informationsdel från dokumentationen (HTTP-metoden, URL:en, autentiseringsschemat eller den obligatoriska payload-strukturen) skapas ingen action. I stället returnerar systemet en kort förklaring av vad som saknas i stället för att gissa.
Det är här den filosofiska poängen om AI-agenter som upptäcker API:er kopplas till en konkret produktfunktion. Funktionen Generate from Text är bokstavligen en AI-agent (en LLM med webbsökning) som bygger en verktygsdefinition för en annan AI-agent (Quickchat AI-agenten som kommer att använda den i konversationer).
Ett genomarbetat exempel: för den fullständiga handledningen som omvandlar två skrivna meningar till två live, testade actions (en nyckellös väderuppslagning och en nyckelbaserad NASA-action, inklusive fail-closed-vägran), se hur du ansluter din AI-agent till valfritt API på ren engelska.
Vid runtime sätts alla dessa verktygstyper samman. Quickchat AI samlar HTTP request AI Action-verktyg, Shopify MCP-verktyg, knowledge base-verktyg, remote MCP-verktyg, Discord-verktyg och andra anpassade verktyg i en samling som presenteras för LLM:en. Modellen ser ingen skillnad mellan dem. Ett Remote MCP-verktyg och en manuellt konfigurerad AI Action ser identiska ut när de väl finns i verktygslistan.
Öppna API:er som ny SEO
Om AI-agenter ska upptäcka och använda API:er autonomt blir ett väldokumenterat och lättanvänt API en distributionsresurs. Gartner förutspår att över 30% av ökningen i API-efterfrågan kommer från AI-agenter 2026.
Företag som har öppna API:er med minimala behörighetshinder kan upptäcka att deras API:er blir deras bästa förvärvskanal. I stället för exponeringar i Google-sökningar är “exponeringarna” AI-agenter som väljer att använda din tjänst framför en konkurrents.
Samma logik gäller en nivå upp. En AI-agent som svarar från din dokumentation kan själv exponeras som en MCP-server som ChatGPT, Claude och Cursor anropar som ett verktyg, vilket gör din kunskap, inte bara ditt API, upptäckbar av den agentiska webben.
Kvaliteten på din API-dokumentation avgör om en AI-agent kan integrera med dig framgångsrikt på ett enda försök. Parameterbeskrivningar, felmeddelanden och exempelsvar fyller samma funktion som metabeskrivningar och strukturerad data i traditionell SEO. Ett förvirrande felsvar eller ett odokumenterat obligatoriskt fält innebär att en agent misslyckas, och det finns ingen människa på andra sidan som felsöker det.
Företag vars API:er är odokumenterade eller ligger bakom tunga behörighetskrav kan bli osynliga för den agentiska webben, på samma sätt som företag utan webbplatser blev osynliga för Google på 2000-talet.
Computer Use kontra API:er
Det finns betydande investeringar i att lära AI-modeller “computer use” (klicka på knappar, fylla i formulär, navigera i användargränssnitt). Anthropic, OpenAI (Operator) och open source-projekt som Browser Use erbjuder alla versioner av detta.
Men webbläsaranvändning är en omväg runt ett saknat API. Ett POST /orders-anrop tar millisekunder och returnerar strukturerad data. En webbläsaragent som navigerar ett checkout-flöde tar minuter och kan gå sönder när en knapp flyttas tre pixlar åt vänster. API:er är snabbare, mer deterministiska och billigare att köra.
Motargumentet är verkligt: API:er finns inte för allt. Äldre system, enterprise-programvara utan API-yta, fysiska enheter som styrs via GUI:er. Computer use fyller ett faktiskt tomrum i dessa fall.
Det bättre långsiktiga svaret på “vi har inget API för detta” är sannolikt att bygga API:et i stället för att lära AI att använda GUI:t. När mer programvara skrivs av AI-agenter för AI-agenter sjunker kostnaden för att bygga och underhålla API:er. Den ekonomiska kalkyl som gjorde det billigare att skrapa ett UI än att bygga ett API håller på att förändras.
Det finns också en säkerhetsvinkel. Simon Willisons “lethal trifecta” beskriver den farliga kombinationen av åtkomst till privat data + exponering för opålitligt innehåll + extern kommunikation. Detta gäller båda metoderna, men API-baserade verktyg är enklare att granska och begränsa. Du kan logga varje API-anrop, validera varje parameter och hastighetsbegränsa varje endpoint. Att göra motsvarande för en webbläsaragent som kan klicka på vad som helst är mycket svårare.
Verktyg för den fysiska världen
Allt som hittills diskuterats handlar om mjukvara. Samma mönster finns i den fysiska världen.
Google DeepMinds RT-2 och Gemini Robotics använder samma arkitektur, förutom att verktygen skickar kommandon till aktuatorer i stället för API:er. SPCA-ramverket (Sense-Plan-Code-Act) formaliserar detta för robotik: skanna miljön, planera angreppssättet, generera körbar kod, kör den, observera resultaten.
Det finns inget API för “flytta växten på mitt skrivbord åt höger.” Men en robot med kamera skulle kunna definiera move_object(object_id="plant_01", direction="right", distance_cm=15) som ett verktyg i farten och sedan anropa det. Verktygsdefinitionen fungerar som gränssnittet mellan resonemangslagret och det fysiska exekveringslagret, samma roll som API-endpoints har i mjukvara.
Arkitekturen LLM + verktyg + loop är generell. Den råkar vara enklast att implementera i mjukvara i dag, men robotiken håller på att komma ikapp.
API:er skrivna av AI, för AI
På ungefär två år (2024 till 2026) har vi gått från att den mesta koden skrevs av människor till att den mesta koden skrivs av AI. Det är ett bra tillfälle att ompröva vad en API-endpoint är. I allt högre grad är en endpoint en kapabilitetsdeklaration utformad för att upptäckas och exekveras av maskiner, inte ett tekniskt gränssnitt som mänskliga utvecklare ska läsa dokumentation om och sedan integrera manuellt.
MCP:er är ett användbart standardiseringslager, men de är också ett kureringslager som introducerar bias. MCP-skaparen bestämmer vilka verktyg som ska exponeras och hur de ska ramas in. För AI-agenter i produktion kanske den inramningen inte motsvarar vad du faktiskt behöver. (Vi skrev om detta i detalj när vi analyserade utmaningarna med Shopifys MCP.)
Spektrumet vi gick igenom i Quickchat AI Agents återspeglar en bredare poäng. Rätt nivå av kontroll beror på ditt användningsfall. Remote MCP fungerar bra för snabb prototypframtagning. Enskilda AI Actions ger dig finmaskig kontroll för kundnära agenter i produktion. Generate from Text låter AI undersöka API:et och bygga verktygsdefinitionen åt dig när du fortfarande utforskar.
Och på varje nivå är det underliggande mönstret detsamma. En LLM, en uppsättning verktyg, en loop. Oavsett om verktygen är bash-kommandon, API-endpoints, MCP-servrar eller robotaktuatorer är det verktyg hela vägen ned.