

Quand les LLM ont appris à appeler des fonctions
À l’époque de GPT-3, interagir avec un LLM consistait à lui fournir un prompt et à récupérer du texte. Les connaissances du modèle étaient vastes mais statiques, figées dans les données d’entraînement. Vous pouviez lui demander d’expliquer l’informatique quantique ou de rédiger un e-mail, et il produisait un texte plausible. Mais il ne pouvait pas consulter la météo du jour, interroger une base de données ni effectuer une action dans le monde réel.
La fonctionnalité qui a changé cela reçoit étonnamment peu de reconnaissance. Elle a donné au modèle le choix entre générer du texte et appeler une fonction. Au lieu de toujours produire le token suivant, le modèle pouvait désormais générer un objet JSON structuré indiquant un nom de fonction et ses arguments. Le runtime exécutait cette fonction, renvoyait le résultat au modèle, puis le modèle continuait à partir de là. L’article ReAct (Yao et al., 2022) a formalisé ce fonctionnement sous la forme de la boucle Thought-Action-Observation. Le modèle raisonne sur ce qu’il doit faire, effectue une action (appelle un outil), observe le résultat, puis répète. Tout agent IA sérieux en 2026 repose sur une variante de ce schéma.
La boucle
Claude Code, OpenClaw, Codex, Devin et des dizaines d’autres systèmes agentiques fonctionnent tous de la même manière. Appeler un outil, observer le résultat, décider de la prochaine étape, répéter. Simon Willison l’a bien formulé : « An LLM agent runs tools in a loop to achieve a goal. »
Claude Code, par exemple, utilise une boucle maître monothread, sans essaim multi-agent ni graphe d’orchestration complexe : while(tool_call) -> execute -> feed results -> repeat.
Les recherches d’Anthropic sur l’autonomie des agents montrent que les durées de tour dans Claude Code ont presque doublé en trois mois, passant de 25 à plus de 45 minutes. Les utilisateurs font de plus en plus confiance à la boucle pour fonctionner seule. Les données montrent que les utilisateurs expérimentés interrompent plus souvent (en passant d’une approbation action par action à une supervision stratégique), tandis que l’agent lui-même demande des clarifications plus de deux fois plus souvent que les utilisateurs ne l’interrompent.
Ce schéma de boucle apparaît partout, aussi bien dans les agents de développement, les bots de support client que les contrôleurs robotiques.
Qu’est-ce qui compte comme outil ?
Les LLM nous donnent une grande liberté pour décider du niveau d’abstraction auquel un outil doit fonctionner. À une extrémité, vous avez des endpoints API très spécifiques : « créer un contact HubSpot avec ces 12 champs ». À l’autre, vous avez des outils comme « exécuter cette commande bash » ou « exécuter ce code Python », qui reviennent essentiellement à dire « faites ce que vous voulez ».
Devin fonctionne avec trois outils : shell, éditeur de code, navigateur. L’outil principal de Claude Code est également un shell. OpenClaw utilise un système dynamique de plugins de compétences. La tendance dans les outils de développement agentiques va vers un nombre réduit d’outils plus généraux, plutôt que vers de nombreux outils spécifiques.
Simon Willison a observé que MCP « initially exploded but then felt less central » pour les agents de développement, car bash est l’outil universel. Les fichiers et les scripts sont une primitive avec moins de friction que des implémentations complètes de serveurs MCP. Si l’agent peut écrire et exécuter du code, il peut presque tout faire sans avoir besoin d’une définition d’outil dédiée.
Mais les outils généralistes conviennent aux agents généralistes. Pour les agents IA propres à un domaine (support client, ventes, opérations internes), vous avez besoin d’outils propres à ce domaine. Votre agent de support ne devrait pas écrire du Python pour vérifier le statut d’une commande. Il devrait appeler un endpoint API bien défini, avec des paramètres clairs et des réponses prévisibles. La conception de votre ensemble d’outils devient une décision produit.
| Approche | Exemple | Contrôle | Flexibilité | Cas d’usage |
|---|---|---|---|---|
| Outil généraliste | Bash, interpréteur Python | Minimal | Maximale | Agents de développement, assistants personnels |
| Bundle de protocole (MCP) | Shopify MCP, GitHub MCP | Moyen | Moyenne | Intégration rapide, prototypage |
| Endpoint API unique | « Créer un contact HubSpot » | Maximum | Minimale | Agents en production en contact avec les clients |
Ce qu’un endpoint API signifie aujourd’hui
Pour les agents IA, un endpoint API fonctionne comme une déclaration de capacité. En publier un signifie que vous (ou votre agent IA) pouvez désormais faire quelque chose qui n’était pas possible auparavant.
Cela fonctionne dans les deux sens. Un éditeur de logiciel publie une API pour que d’autres puissent s’intégrer à son produit. Mais un agent IA peut aussi découvrir des endpoints par lui-même en recherchant dans la documentation, en lisant des spécifications OpenAPI ou littéralement en cherchant sur Google comment accomplir une tâche.
Un serveur MCP est un bundle organisé d’endpoints API avec une idée préconçue de la manière dont ils doivent être utilisés. Le créateur du MCP a déjà pris des décisions sur les endpoints à exposer, la manière de les nommer, les paramètres à rendre disponibles et, implicitement, les workflows à prendre en charge. Cette curation est à la fois une force (commodité, standardisation) et une faiblesse (rigidité, périmètre orienté). Le serveur de Notion en est un exemple concret : il publie 28 outils, et un agent de centre d’aide en a besoin de quatre, répartis sur deux connexions.
Les MCP échangent le contrôle contre la simplicité d’utilisation. En 2026, l’IA écrit la majeure partie du code d’intégration. Si un agent peut lire la documentation d’une API et écrire lui-même l’intégration, l’argument de la « simplicité d’utilisation » en faveur de MCP s’affaiblit. La couche MCP est peut-être surtout importante pendant la période de transition, tant que l’outillage n’a pas rattrapé les capacités du modèle. Le guide d’Anthropic sur les modèles de conception pour l’utilisation d’outils est une référence pratique pour structurer les schémas d’outils, que vous utilisiez MCP ou des endpoints individuels.
Un développement connexe : llms.txt est un standard proposé dans lequel les sites web publient un fichier /llms.txt pour orienter les modèles IA vers les ressources à forte valeur. Anthropic, Cloudflare, Docker et Stripe l’ont adopté. MCP standardise l’invocation des outils ; llms.txt standardise la découverte de documentation. Les deux cherchent à rendre le web plus lisible pour les machines, sous des angles différents.
Qu’est-ce qu’un endpoint API dans le contexte des agents IA ?
Un endpoint API est une URL spécifique qui accepte une entrée structurée et renvoie une sortie structurée. Pour les agents IA, chaque endpoint représente une capacité distincte, quelque chose que l’agent peut faire dans le monde réel. La description de l’endpoint, les définitions de paramètres et les réponses d’erreur servent de manuel d’instructions pour l’agent. Plus l’endpoint est bien documenté, plus un agent peut l’utiliser de manière fiable.
Contrairement aux développeurs humains, qui peuvent lire des tutoriels et déboguer de manière itérative, un agent s’appuie sur le schéma et la description de l’endpoint pour effectuer un seul appel correct. C’est pourquoi une documentation d’API conçue pour être consommée par l’IA est plus importante que jamais. Seuls 24% des développeurs conçoivent actuellement des API en pensant aux agents IA, malgré 89% qui utilisent l’IA dans leur workflow.
Qu’est-ce que MCP (Model Context Protocol) ?
MCP est un protocole ouvert introduit par Anthropic qui standardise la façon dont les agents IA se connectent aux outils externes et aux sources de données. Considérez-le comme l’USB-C pour l’IA. Un connecteur unique que tout fournisseur d’outil peut implémenter et que tout agent IA peut consommer. Un serveur MCP expose un ensemble d’outils (essentiellement des endpoints API) avec des schémas standardisés, et un client MCP (l’agent) peut les découvrir et les appeler sans code d’intégration personnalisé. Pour une explication technique plus approfondie, consultez notre article MCP Explained. Pour un retour pratique sur MCP en production, consultez notre analyse des défis concrets rencontrés en construisant sur le MCP de Shopify.
Le spectre de contrôle dans Quickchat AI
Quickchat AI vous donne trois façons d’équiper un AI Agent d’outils externes. Elles se situent sur un spectre allant du plus automatisé au plus contrôlé. Chaque approche établit un compromis différent entre la vitesse de configuration et la précision du comportement.
Remote MCP : brancher et démarrer
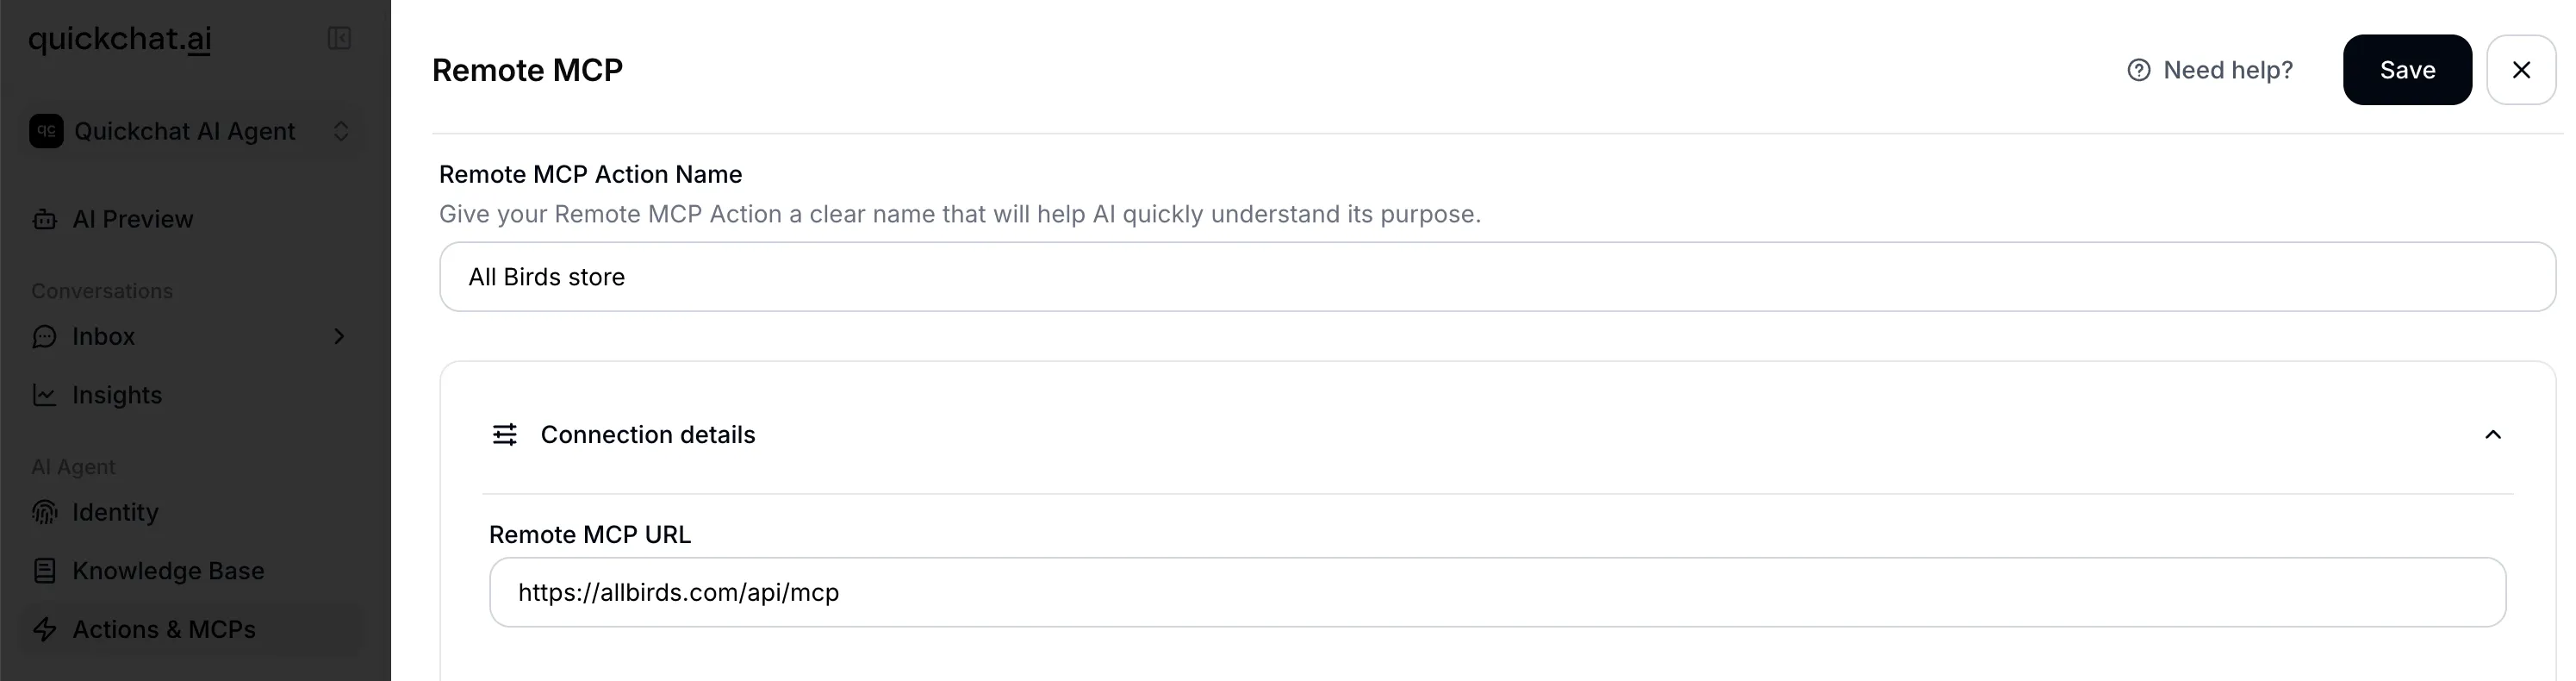
Remote MCP est le moyen le plus rapide de connecter un AI Agent à des fonctionnalités externes. Vous fournissez l’URL d’un serveur MCP, Quickchat AI s’y connecte, découvre tous les outils disponibles et vous permet de sélectionner ceux que votre agent doit utiliser.
Comment le configurer :
- Allez dans AI Actions dans le dashboard Quickchat AI
- Cliquez sur “Add Remote MCP”
- Collez l’URL de votre serveur MCP (par exemple,
https://mcp.example.com/sse) - Ajoutez éventuellement un token d’authentification ou des headers personnalisés (les deux sont mutuellement exclusifs)
- Cliquez sur “Connect.” Quickchat AI découvre tous les outils disponibles et affiche leurs noms
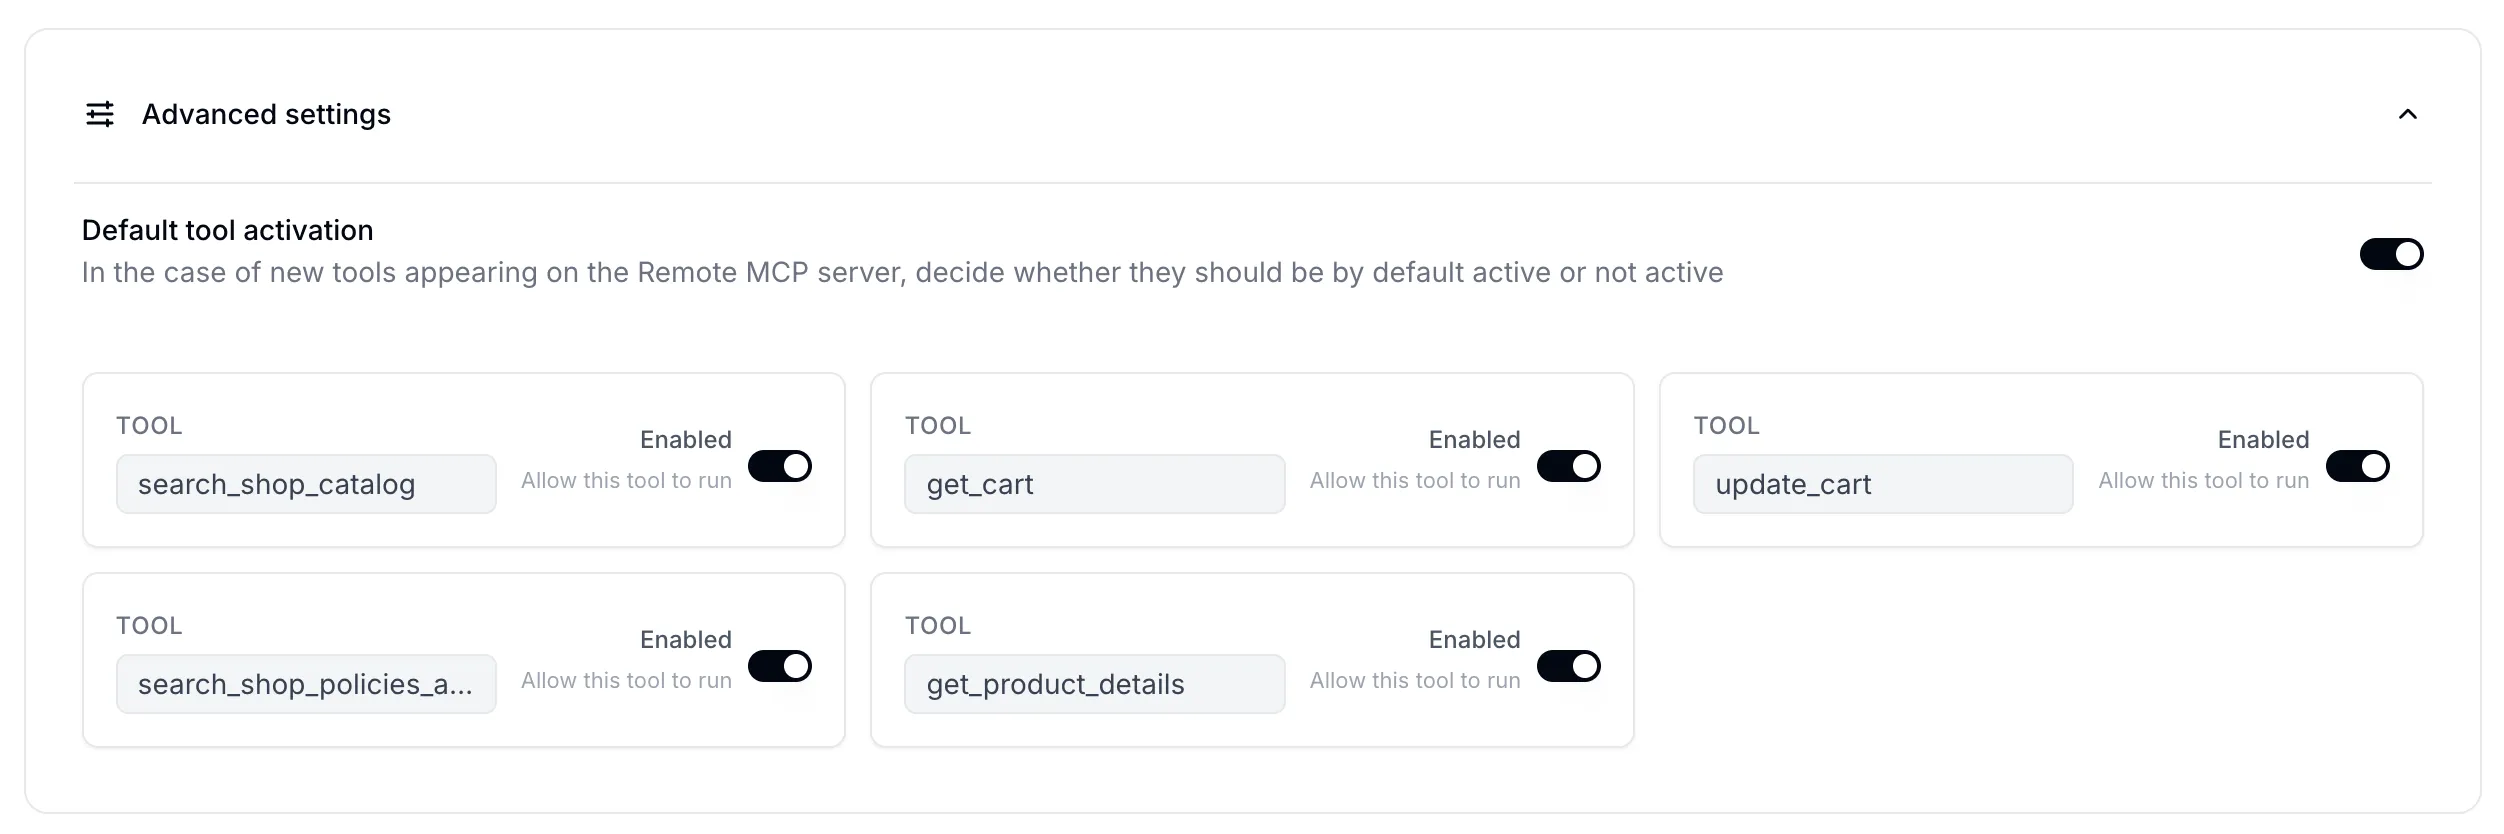
- Activez ou désactivez les outils individuellement pour contrôler ceux que votre agent peut utiliser
- Définissez le flag “default tool is active” pour contrôler si les nouveaux outils découverts sont automatiquement activés ou désactivés
Ce qui se passe sous le capot :
Lorsque vous cliquez sur Connect, Quickchat AI détecte automatiquement le protocole de transport à partir de l’URL. Si l’URL contient sse, le transport SSE est utilisé ; sinon streamable_http est la valeur par défaut. Lorsque vous fournissez un token d’authentification, il est envoyé comme token Bearer dans le header Authorization.
Le filtrage des outils fonctionne avec un système à trois niveaux. Chaque outil du serveur MCP est vérifié par rapport à deux ensembles : les outils explicitement activés sont toujours inclus, les outils explicitement désactivés sont toujours exclus, et tout outil n’appartenant à aucun des deux ensembles revient au réglage “default tool is active” que vous avez choisi. Cela signifie que lorsqu’un serveur MCP ajoute de nouveaux outils, vous contrôlez s’ils sont automatiquement disponibles pour votre agent ou s’ils nécessitent une activation explicite.
À l’exécution, lorsqu’une conversation démarre, toutes les connexions Remote MCP actives pour l’agent sont chargées. Les outils sont récupérés et filtrés selon la configuration de chaque connexion, et l’unicité des noms d’outils est vérifiée sur toutes les sources (avec un avertissement si des doublons sont trouvés).
Le compromis : vous obtenez un accès immédiat à tout ce que le MCP expose, mais vous avez un contrôle limité sur les descriptions d’outils, les définitions de paramètres ou la manière dont l’agent décide de les utiliser. Comme nous l’avons constaté en construisant un AI Agent sur le MCP de Shopify, passer de la démo à la production exige des ajustements soigneux que l’approche groupée de MCP peut rendre difficiles.
Voir aussi : connecter votre agent à un serveur MCP distant, How to Launch Your Quickchat AI MCP, considérations de sécurité MCP, documentation Quickchat AI : canal MCP.
AI Actions (HTTP Request) : un endpoint, contrôle complet
Une AI Action dans Quickchat AI est un endpoint API HTTP unique que vous configurez individuellement pour votre AI Agent. Alors que MCP importe un bundle d’outils en une seule fois, chaque AI Action vous donne un contrôle complet sur une capacité spécifique. Pour un exemple complet, avec quatre actions qui créent et enrichissent des contacts, enregistrent des deals et ouvrent des tickets dans un CRM, consultez le tutoriel HubSpot AI Actions.
Configurer une AI Action :
- Name (64 caractères max) : cela devient le nom de l’outil que le LLM voit. Il est normalisé en identifiant valide (par exemple, “Check Order Status” devient
Check_Order_Status) - Description (1 000 caractères max) : c’est le champ le plus important. La description indique au LLM quand utiliser cet outil. Les bonnes descriptions précisent dans quelles circonstances conversationnelles l’appeler, quelles informations recueillir d’abord auprès de l’utilisateur et comment les résultats doivent être communiqués
- HTTP method : GET, POST, PATCH, DELETE ou PUT
- URL (10 000 caractères max) : peut contenir des placeholders
{{parameter_name}}pour des valeurs dynamiques - Headers : paires clé-valeur pour l’authentification et le type de contenu
- Body items / Body JSON : corps de requête avec injection de paramètres
- Query parameters : valeurs de chaîne de requête d’URL
- Parameters (10 max) : chacun avec un nom, une description (500 caractères max), un type (
str,int,float,booloucustom), un flag obligatoire et une valeur par défaut optionnelle
Les placeholders {{parameter_name}} sont le mécanisme clé. Lorsque le LLM appelle l’outil, il fournit des valeurs pour chaque paramètre à partir du contexte de la conversation. Quickchat AI injecte ensuite ces valeurs dans les modèles d’URL, de headers, de corps et de chaîne de requête avant d’effectuer la requête HTTP. Il existe aussi quatre variables intégrées qui peuvent être injectées de cette façon : scenario_id, conversation_id, conversation_channel et conversation_url.
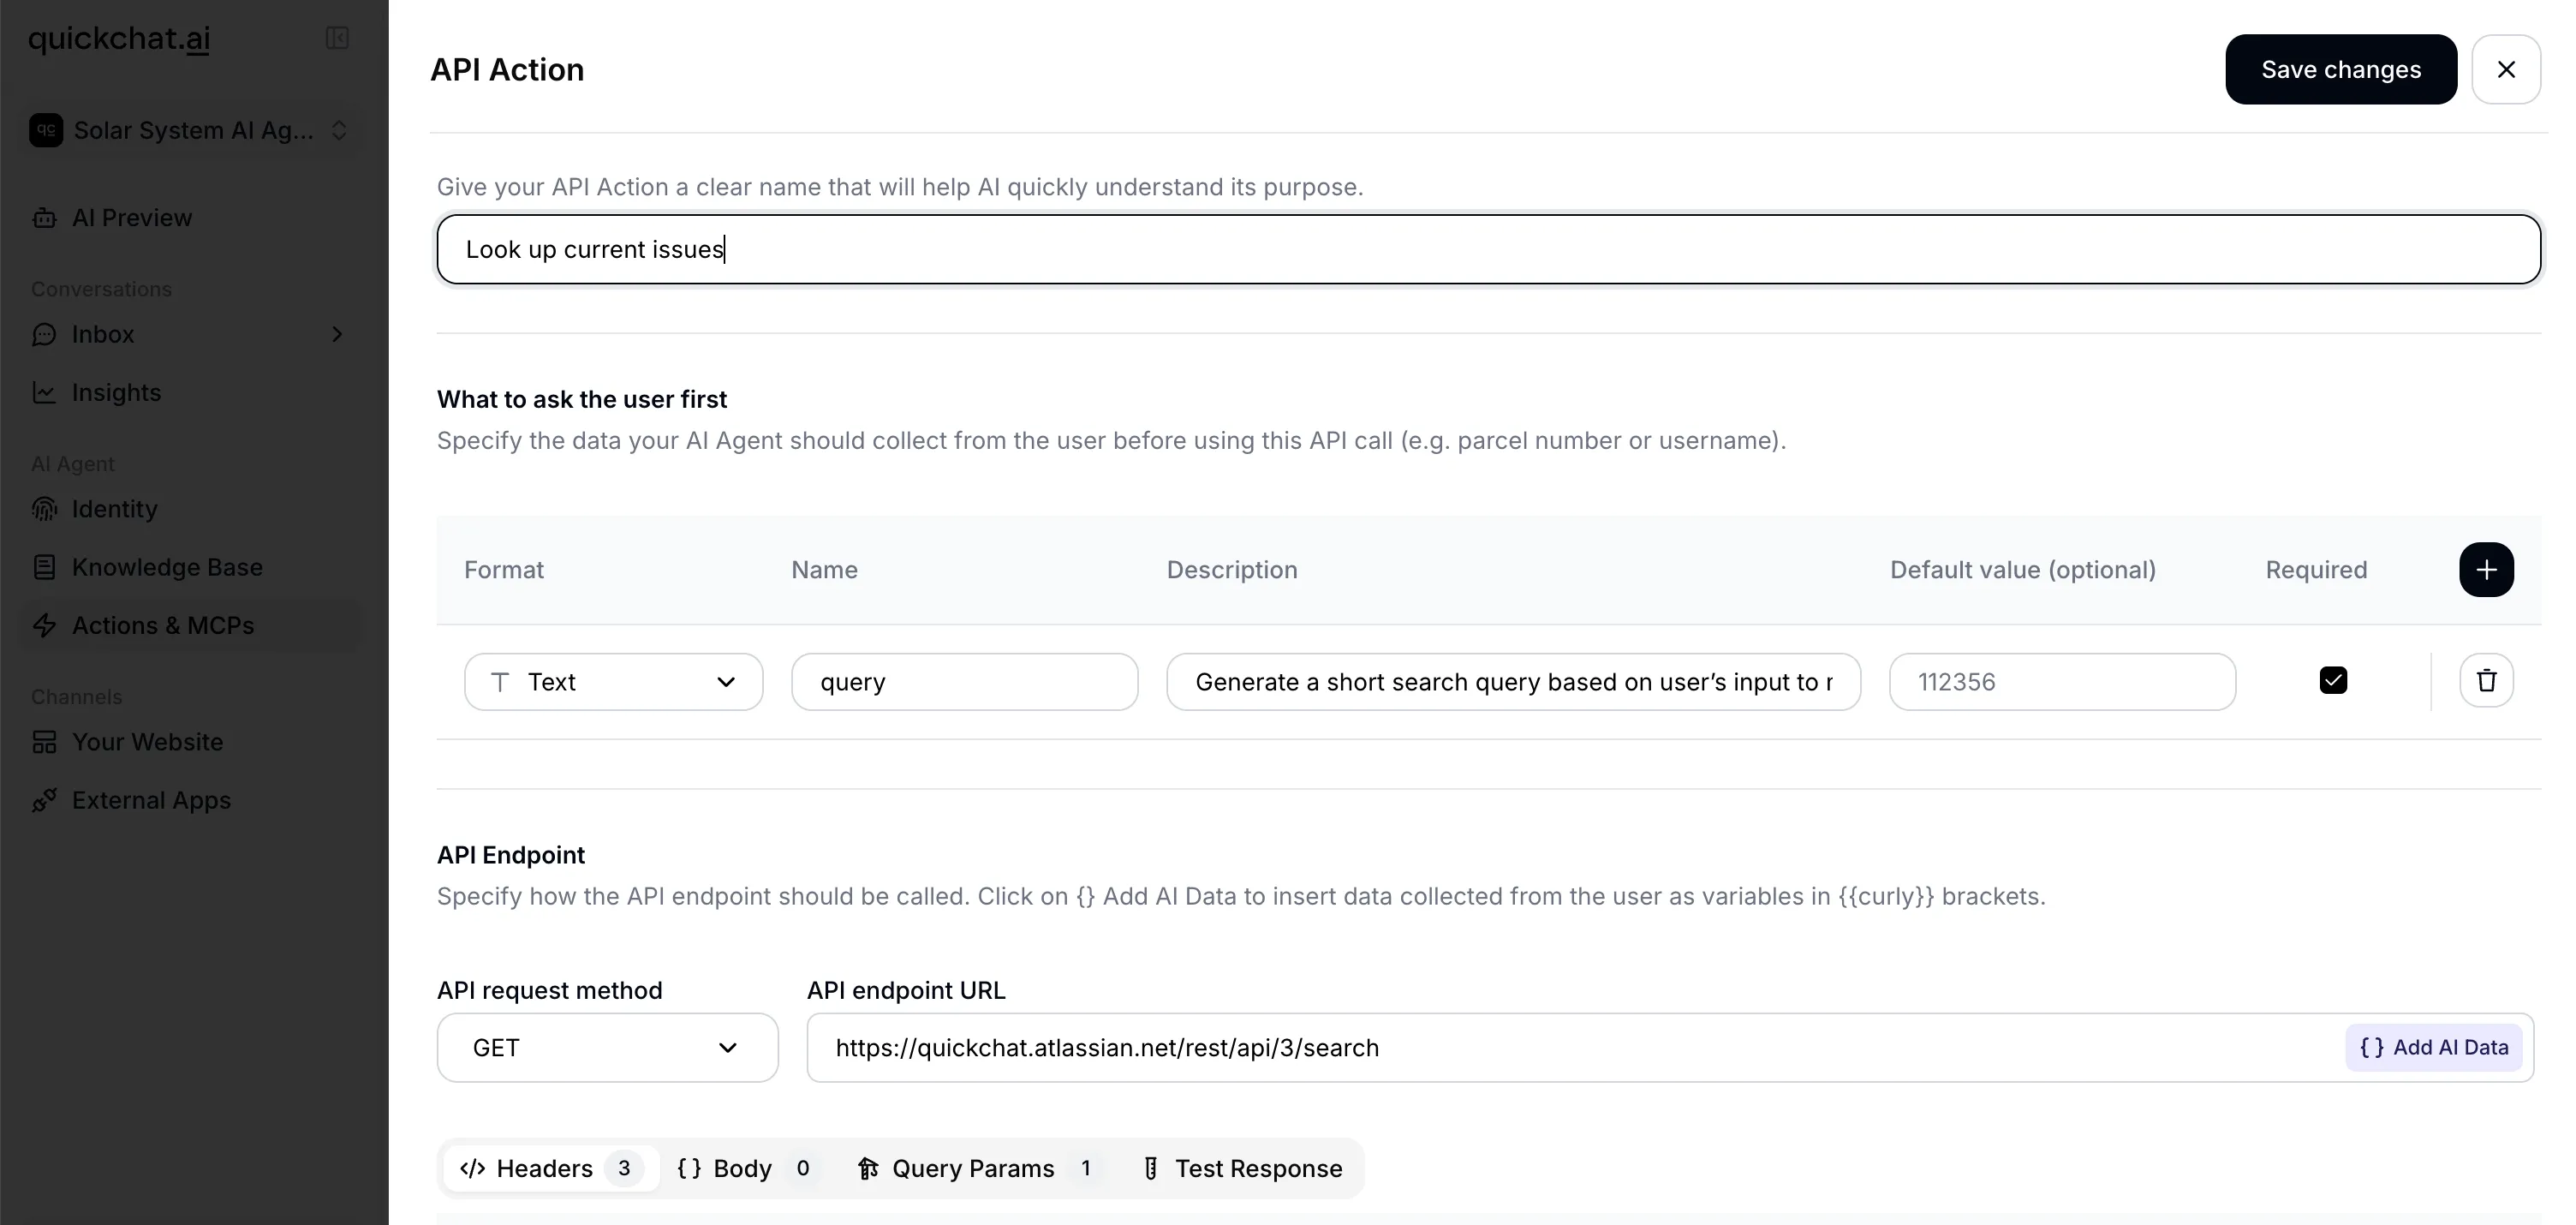 Une AI Action configurée pour vérifier le statut d’une commande, montrant le modèle d’URL avec placeholder de paramètre, les headers et les définitions de paramètres.
Sous le capot : Quickchat AI construit dynamiquement un schéma typé à partir de vos définitions de paramètres pour chaque AI Action. Les cinq types pris en charge (str, int, float, bool, custom) sont mappés vers leurs équivalents natifs, et ce schéma est utilisé pour valider les entrées du LLM avant d’effectuer la requête HTTP.
Exemple d’AI Action pour vérifier le statut d’une commande :
{
  "name": "check_order_status",
  "description": "Lorsque l’utilisateur demande le statut de sa commande et a fourni un numéro de commande, appelez cet endpoint pour récupérer le statut actuel. Communiquez à l’utilisateur le statut, la date de livraison estimée et le numéro de suivi (s’il est disponible).",
  "method": "GET",
  "url": "https://api.example.com/orders/{{order_id}}",
  "headers": [
    { "name": "Authorization", "value": "Bearer YOUR_API_KEY" },
    { "name": "Content-Type", "value": "application/json" }
  ],
  "parameters": [
    {
      "name": "order_id",
      "description": "L’ID de commande fourni par l’utilisateur (par exemple, ORD-12345)",
      "type": "str",
      "is_required": true
    }
  ]
}
Tests : le dashboard dispose d’un bouton “Test” qui vous permet de fournir des exemples de valeurs de paramètres et de voir la requête HTTP réelle (y compris une commande curl générée) et la réponse avant le déploiement.
Conseils pour rédiger des descriptions d’AI Action efficaces :
- Soyez précis sur le moment où l’agent doit l’appeler : « Lorsque l’utilisateur demande le statut de sa commande et fournit un numéro de commande, appelez cet endpoint »
- Mentionnez les informations à collecter d’abord : « Avant l’appel, assurez-vous d’avoir l’adresse e-mail de l’utilisateur et l’ID de commande »
- Décrivez comment gérer la réponse : « Si le statut est “shipped”, indiquez à l’utilisateur le numéro de suivi présent dans la réponse »
- Pour les workflows en plusieurs étapes, décrivez la séquence dans le prompt système principal de l’agent plutôt que dans les descriptions d’actions individuelles, et pour transférer une valeur entre actions et conditionner l’écriture sur cette valeur, utilisez Save to memory avec une condition d’exécution
Un exemple complet : pour une AI Action pas à pas qui enregistre des leads, des questions sans réponse et des demandes de démo directement dans une feuille de calcul, consultez comment connecter un agent IA à Google Sheets.
Generate from Text : laisser l’IA déterminer la configuration
La troisième option s’adresse aux utilisateurs qui savent ce qu’ils veulent que leur agent fasse, mais ne savent pas quel endpoint API (ni même quel service) utiliser.
Fonctionnement :
- Vous saisissez une description en langage naturel de ce que vous voulez, par exemple : « Je veux que mon AI Agent puisse démarrer la Tesla d’un utilisateur lorsqu’il le demande »
- Quickchat AI envoie cette demande à un LLM avec l’outil
web_searchactivé - Le modèle recherche sur le web l’API appropriée, lit la documentation officielle et génère une spécification complète d’AI Action, incluant l’URL, la méthode, les headers, les paramètres et les exigences d’authentification
- Le résultat revient avec la configuration complète de l’action, des citations de la documentation utilisée et un message explicatif indiquant les hypothèses et les lacunes
- Vous vérifiez, renseignez vos identifiants et activez
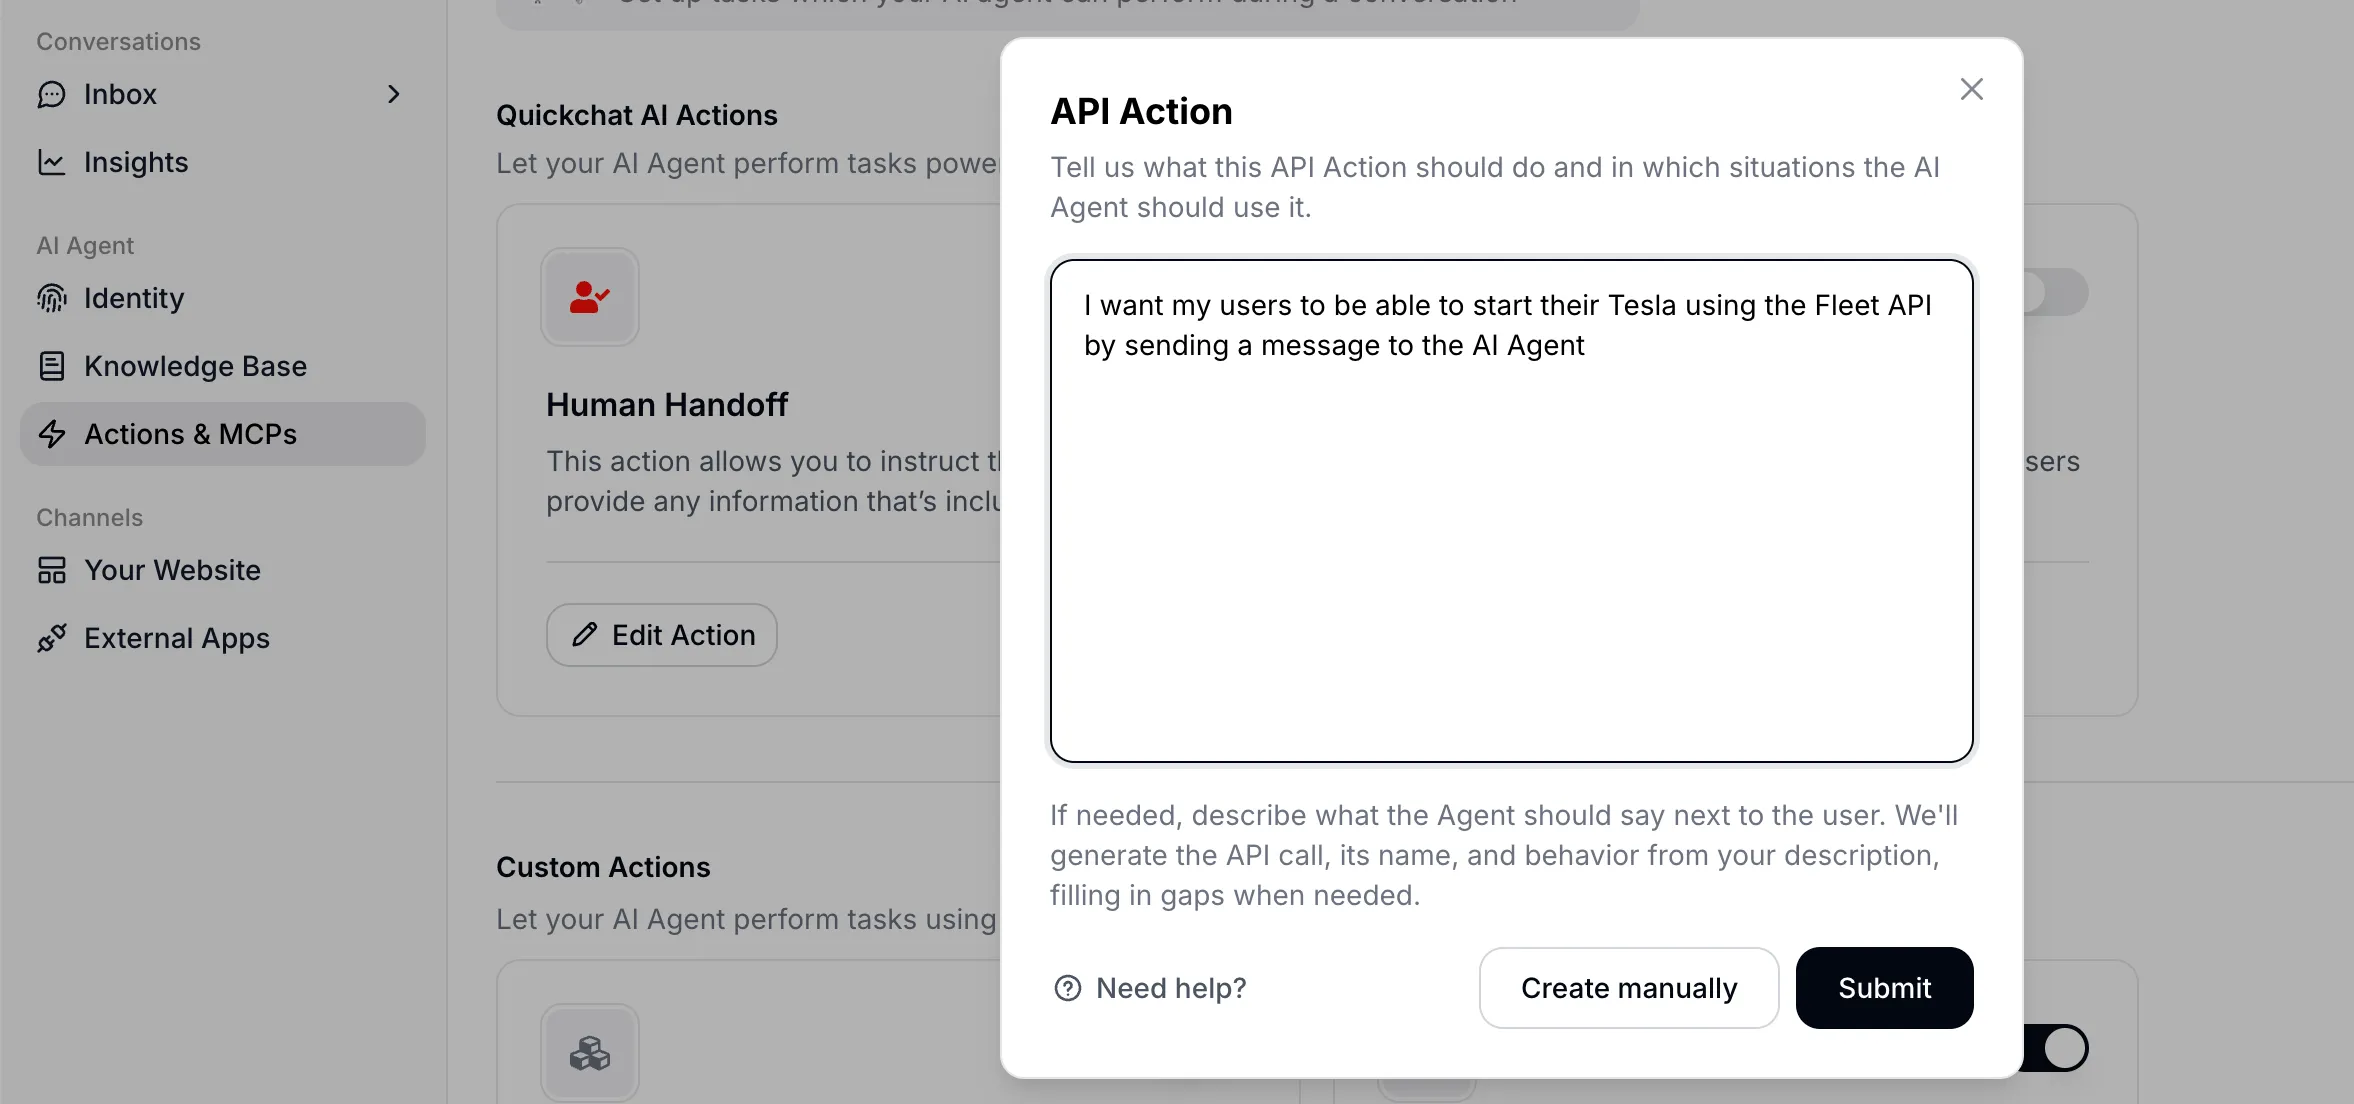 Saisie d’une description en langage naturel de la capacité souhaitée.
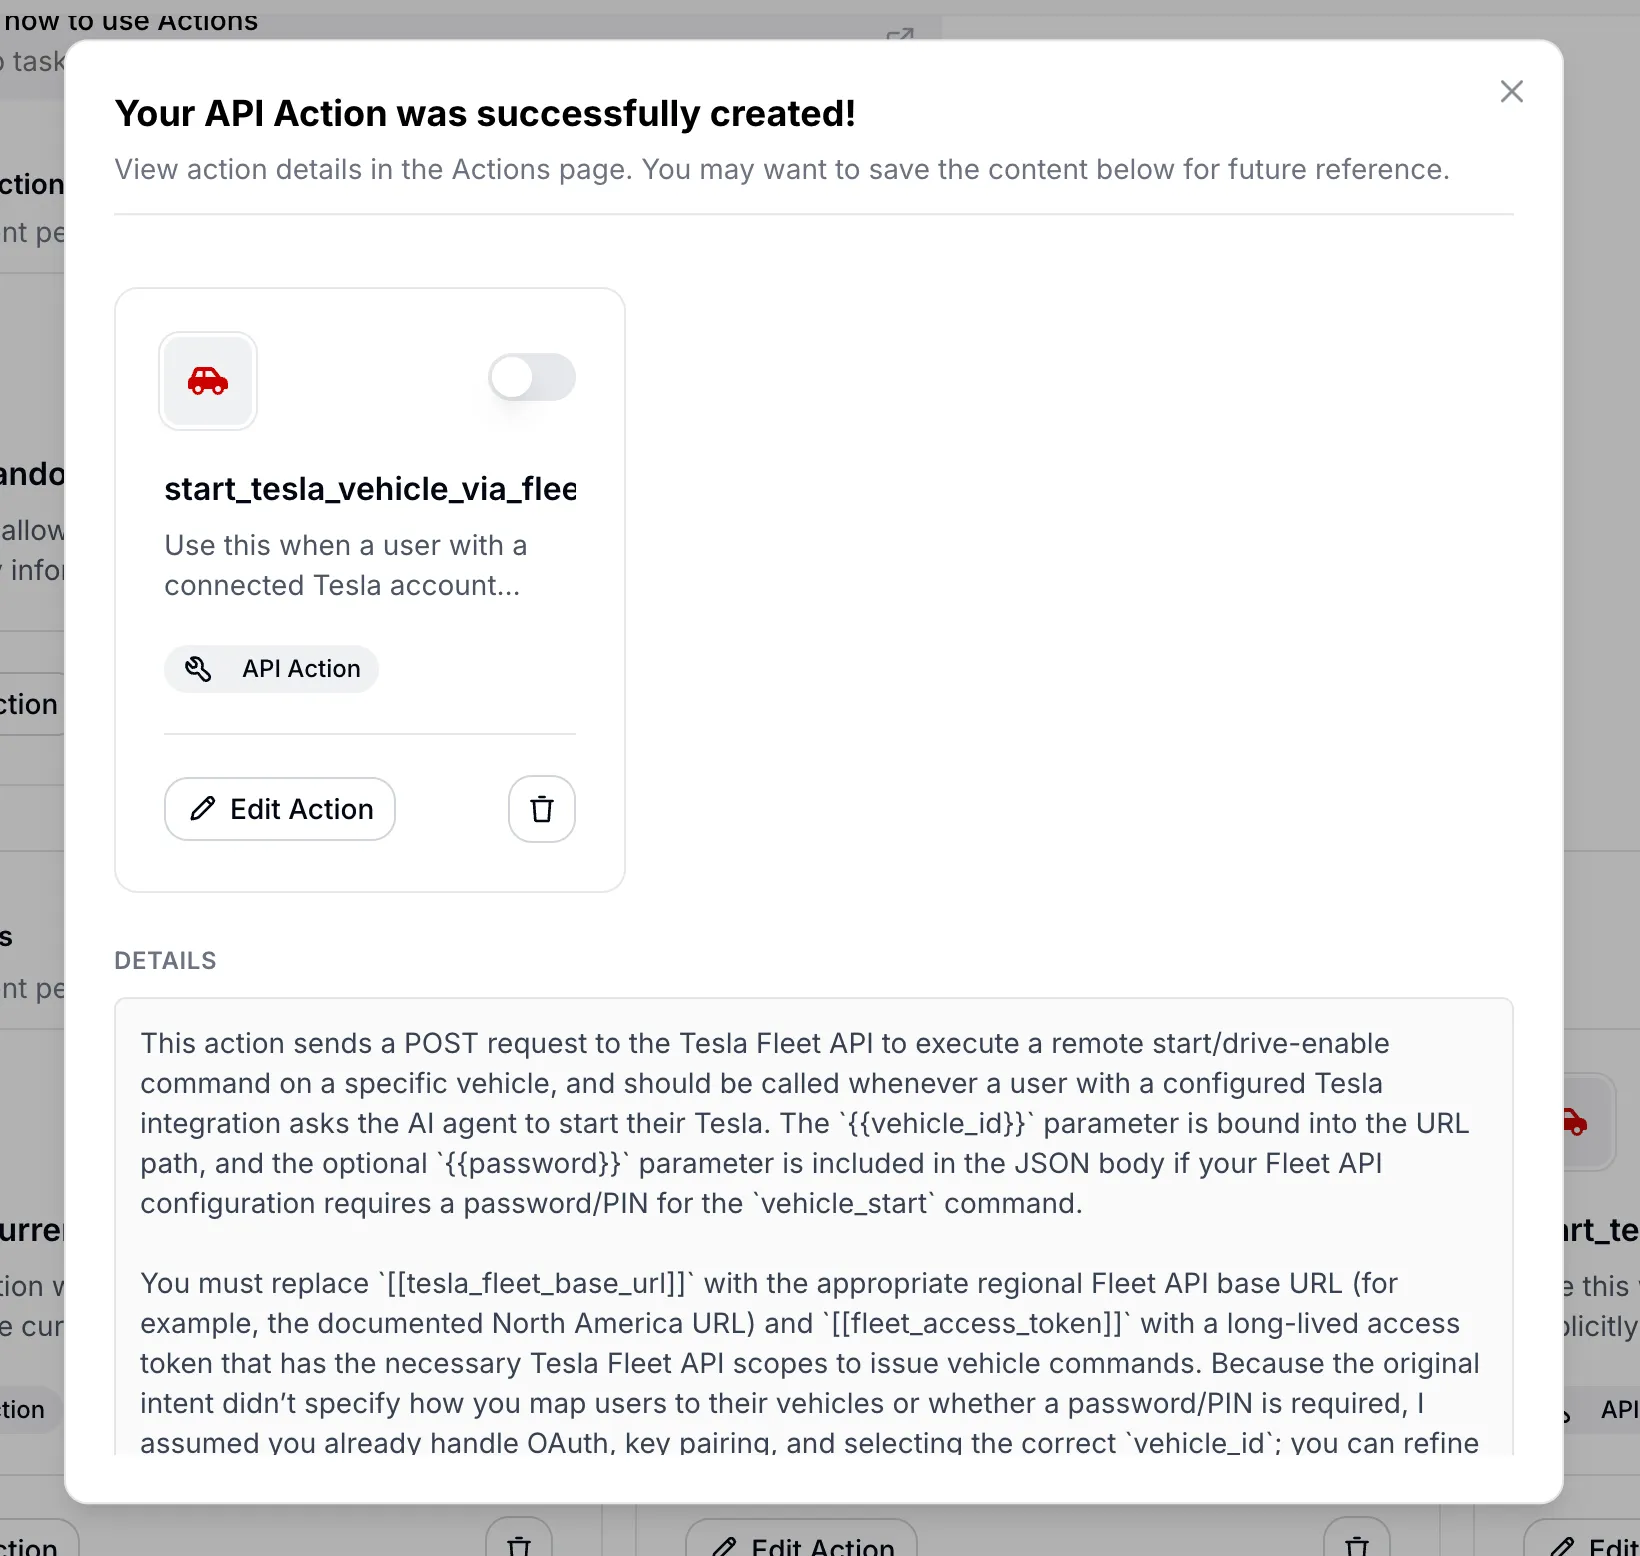 La configuration d’AI Action générée, avec citations de la documentation d’API utilisée.
La génération automatisée d’AI Action est structurée autour de trois priorités :
- Priorité 1 : comprendre l’intention. Identifier la capacité exacte que le développeur souhaite et l’endpoint API spécifique qui la fournit
- Priorité 2 : s’ancrer dans la documentation. Utiliser la recherche web pour trouver la documentation officielle du fournisseur, et non des suppositions
- Priorité 3 : concevoir une sémantique centrée sur la conversation. Le nom et la description générés doivent porter sur le moment de la conversation où cet outil est utilisé, et pas seulement sur ce que fait techniquement l’API
Le prompt utilise deux conventions de placeholders. {{param}} marque les paramètres d’exécution que le LLM remplit à partir du contexte de conversation. [[secret_name]] (doubles crochets) marque les constantes développeur comme les clés API et les ID de compte qui doivent être configurées manuellement avant l’activation. Chaque nom de paramètre doit apparaître comme placeholder {{that_exact_name}} quelque part dans la définition de la requête, et aucun placeholder orphelin n’est autorisé.
Le système utilise une politique fail-closed. Si le modèle ne peut pas confirmer une information critique à partir de la documentation (la méthode HTTP, l’URL, le schéma d’authentification ou la structure de payload requise), aucune action n’est créée. À la place, le système renvoie une explication concise de ce qui manque, plutôt que de deviner.
C’est ici que le point philosophique sur les agents IA qui découvrent des API se relie à une fonctionnalité produit concrète. La fonctionnalité Generate from Text est littéralement un agent IA (un LLM avec recherche web) qui construit une définition d’outil pour un autre agent IA (l’agent Quickchat AI qui l’utilisera dans les conversations).
Un exemple complet : pour le tutoriel complet qui transforme deux phrases saisies en deux actions actives et testées (une recherche météo sans clé et une action NASA avec clé, incluant le refus fail-closed), consultez comment connecter votre agent IA à n’importe quelle API en anglais simple.
À l’exécution, tous ces types d’outils sont assemblés. Quickchat AI collecte les outils AI Action de requête HTTP, les outils Shopify MCP, les outils de base de connaissances, les outils Remote MCP, les outils Discord et d’autres outils personnalisés dans une collection à présenter au LLM. Le modèle ne voit aucune différence entre eux. Un outil Remote MCP et une AI Action configurée manuellement semblent identiques une fois dans la liste des outils.
Les API ouvertes comme nouveau SEO
Si les agents IA doivent découvrir et utiliser des API de manière autonome, alors disposer d’une API bien documentée et facile à utiliser devient un actif de distribution. Gartner prévoit que plus de 30% de l’augmentation de la demande d’API proviendra des agents IA d’ici 2026.
Les entreprises qui disposent d’API ouvertes avec peu de barrières d’identification pourraient constater que leurs API deviennent leur meilleur canal d’acquisition. Au lieu d’impressions dans la recherche Google, les « impressions » sont des agents IA qui choisissent d’utiliser votre service plutôt que celui d’un concurrent.
La même logique s’applique un niveau plus haut. Un agent IA qui répond à partir de votre documentation peut lui-même être exposé comme serveur MCP que ChatGPT, Claude et Cursor appellent comme outil, ce qui rend vos connaissances, et pas seulement votre API, découvrables par le web agentique.
La qualité de votre documentation d’API détermine si un agent IA peut réussir à s’intégrer à vous en une seule tentative. Les descriptions de paramètres, les messages d’erreur et les exemples de réponses remplissent la même fonction que les meta descriptions et les données structurées dans le SEO traditionnel. Une réponse d’erreur confuse ou un champ obligatoire non documenté signifie qu’un agent échouera, et il n’y a pas d’humain de l’autre côté pour déboguer.
Les entreprises dont les API ne sont pas documentées ou sont bloquées derrière de lourdes exigences d’identification peuvent devenir invisibles pour le web agentique, de la même manière que les entreprises sans site web sont devenues invisibles pour Google dans les années 2000.
Computer Use vs. API
Il existe des investissements importants pour apprendre aux modèles IA le « computer use » (cliquer sur des boutons, remplir des formulaires, naviguer dans des interfaces utilisateur). Anthropic, OpenAI (Operator) et des projets open-source comme Browser Use en proposent tous des variantes.
Mais l’utilisation du navigateur est une solution de contournement lorsqu’une API manque. Un appel POST /orders prend quelques millisecondes et renvoie des données structurées. Un agent navigateur qui parcourt un tunnel de paiement prend plusieurs minutes et peut échouer lorsqu’un bouton se déplace de trois pixels vers la gauche. Les API sont plus rapides, plus déterministes et moins coûteuses à exécuter.
Le contre-argument est réel : les API n’existent pas pour tout. Systèmes legacy, logiciels d’entreprise sans surface API, appareils physiques contrôlés via des interfaces graphiques. Le computer use comble un vrai manque dans ces cas.
La meilleure réponse à long terme à « nous n’avons pas d’API pour cela » consiste probablement à construire l’API plutôt qu’à apprendre à l’IA à utiliser l’interface graphique. À mesure que davantage de logiciels sont écrits par des agents IA pour des agents IA, le coût de création et de maintenance des API diminue. Le calcul économique qui rendait le scraping d’une interface utilisateur moins coûteux que la construction d’une API est en train de changer.
Il existe aussi un angle sécurité. Le « lethal trifecta » de Simon Willison décrit la combinaison dangereuse entre accès à des données privées + exposition à du contenu non fiable + communication externe. Cela s’applique aux deux approches, mais les outils basés sur des API sont plus faciles à auditer et à contraindre. Vous pouvez journaliser chaque appel API, valider chaque paramètre et limiter le débit de chaque endpoint. Faire l’équivalent pour un agent navigateur capable de cliquer n’importe où est beaucoup plus difficile.
Des outils pour le monde physique
Tout ce qui a été abordé jusqu’ici concerne le logiciel. Le même schéma apparaît dans le monde physique.
RT-2 et Gemini Robotics de Google DeepMind utilisent la même architecture, sauf que les outils dispatchent vers des actionneurs plutôt que vers des API. Le framework SPCA (Sense-Plan-Code-Act) formalise cela pour la robotique : scanner l’environnement, planifier l’approche, générer du code exécutable, l’exécuter, observer les résultats.
Il n’existe pas d’API pour « déplacer la plante sur mon bureau vers la droite ». Mais un robot équipé d’une caméra pourrait définir move_object(object_id="plant_01", direction="right", distance_cm=15) comme outil à la volée, puis l’appeler. La définition de l’outil sert d’interface entre la couche de raisonnement et la couche d’exécution physique, le même rôle que jouent les endpoints API dans le logiciel.
L’architecture LLM + outils + boucle est généraliste. Elle est aujourd’hui plus facile à implémenter dans le logiciel, mais la robotique rattrape son retard.
Des API écrites par l’IA, pour l’IA
En environ deux ans (2024 à 2026), nous sommes passés d’un monde où la plupart du code était écrit par des humains à un monde où la plupart du code est écrit par l’IA. C’est un bon moment pour reconsidérer ce qu’est un endpoint API. De plus en plus, un endpoint est une déclaration de capacité conçue pour être découverte et exécutée par des machines, et non une interface technique que des développeurs humains doivent documenter, lire, puis intégrer manuellement.
Les MCP sont une couche de standardisation utile, mais ils sont aussi une couche de curation qui introduit un biais. Le créateur du MCP décide quels outils exposer et comment les présenter. Pour des agents IA en production, ce cadrage peut ne pas correspondre à ce dont vous avez réellement besoin. (Nous avons écrit en détail à ce sujet dans notre analyse des défis liés au MCP de Shopify.)
Le spectre que nous avons parcouru dans Quickchat AI Agents reflète un point plus large. Le bon niveau de contrôle dépend de votre cas d’usage. Remote MCP fonctionne bien pour le prototypage rapide. Les AI Actions individuelles vous donnent un contrôle fin pour des agents en production en contact avec les clients. Generate from Text laisse l’IA rechercher l’API et construire la définition d’outil pour vous lorsque vous êtes encore en phase d’exploration.
Et à chaque niveau, le schéma sous-jacent est le même. Un LLM, un ensemble d’outils, une boucle. Que les outils soient des commandes bash, des endpoints API, des serveurs MCP ou des actionneurs robotiques, tout repose sur des outils, jusqu’au bout.