

Als LLMs lernten, Funktionen aufzurufen
In der GPT-3-Ära bedeutete die Interaktion mit einem LLM, ihm einen Prompt zu geben und Text zurückzubekommen. Das Wissen des Modells war groß, aber statisch, eingefroren auf dem Stand der Trainingsdaten. Du konntest es bitten, Quantencomputing zu erklären oder eine E-Mail zu entwerfen, und es erzeugte plausiblen Text. Aber es konnte nicht das heutige Wetter prüfen, eine Datenbank abfragen oder in der realen Welt handeln.
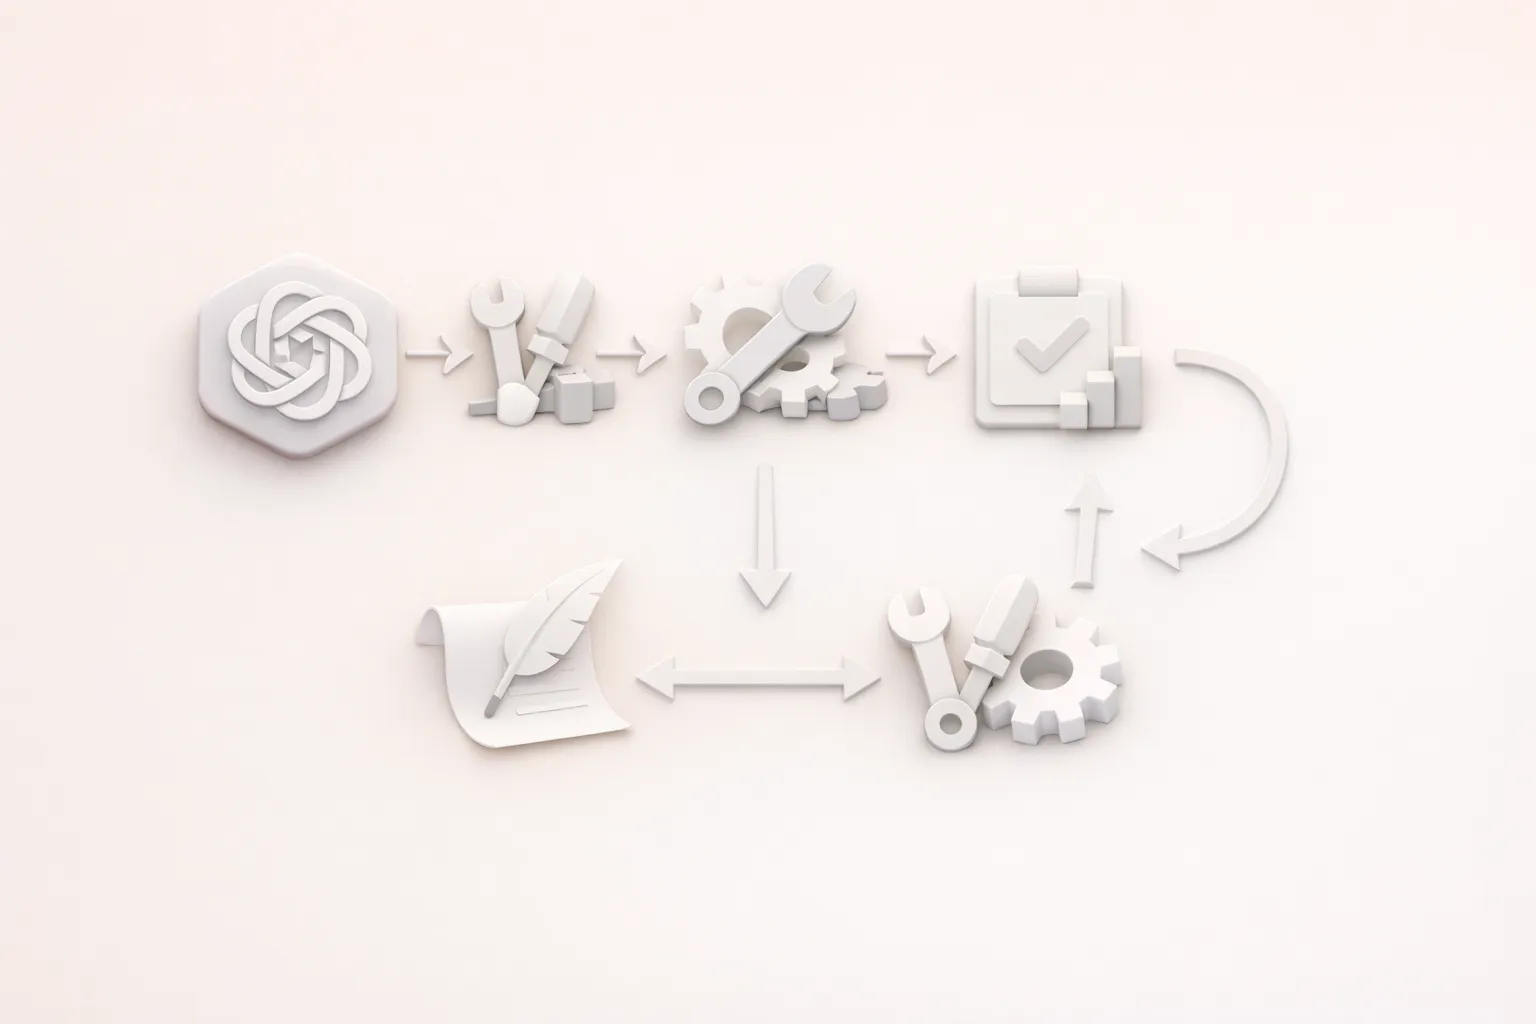
Das Feature, das dies änderte, bekommt erstaunlich wenig Anerkennung. Es gab dem Modell die Wahl zwischen dem Generieren von Text und dem Aufrufen einer Funktion. Statt immer das nächste Token zu erzeugen, konnte das Modell nun ein strukturiertes JSON-Objekt ausgeben, das einen Funktionsnamen und seine Argumente angibt. Die Laufzeitumgebung führte diese Funktion aus, gab das Ergebnis an das Modell zurück, und das Modell machte von dort aus weiter. Das ReAct-Paper (Yao et al., 2022) formalisierte dies als Thought-Action-Observation-Schleife. Das Modell überlegt, was zu tun ist, führt eine Aktion aus (ruft ein Tool auf), beobachtet das Ergebnis und wiederholt den Vorgang. Jeder ernstzunehmende AI Agent im Jahr 2026 läuft auf einer Variante dieses Musters.
Die Schleife
Claude Code, OpenClaw, Codex, Devin und Dutzende andere agentische Systeme arbeiten alle auf dieselbe Weise. Ein Tool aufrufen, das Ergebnis beobachten, entscheiden, was als Nächstes zu tun ist, wiederholen. Simon Willison hat es treffend formuliert: „Ein LLM-Agent führt Tools in einer Schleife aus, um ein Ziel zu erreichen.“
Claude Code verwendet zum Beispiel eine single-threaded Master Loop ohne Multi-Agent-Schwarm oder komplexen Orchestrierungsgraphen: while(tool_call) -> execute -> feed results -> repeat.
Anthropics Forschung zur Agentenautonomie zeigt, dass sich die Dauer von Turns in Claude Code innerhalb von drei Monaten nahezu verdoppelte, von 25 auf über 45 Minuten. Nutzer vertrauen der Schleife zunehmend, eigenständig zu laufen. Die Daten zeigen, dass erfahrene Nutzer häufiger unterbrechen (sie wechseln von der Genehmigung einzelner Aktionen zu strategischem Monitoring), während der Agent selbst mehr als doppelt so oft um Klärung bittet, wie Nutzer ihn unterbrechen.
Dieses Schleifenmuster findet sich überall, gleichermaßen in Coding Agents, Kundensupport-Bots und Robotik-Controllern.
Was zählt als Tool?
LLMs geben uns erhebliche Freiheit bei der Entscheidung, auf welcher Abstraktionsebene ein Tool arbeiten soll. An einem Ende stehen hochspezifische API-Endpunkte: „einen HubSpot-Kontakt mit diesen 12 Feldern erstellen“. Am anderen Ende stehen Tools wie „diesen Bash-Befehl ausführen“ oder „diesen Python-Code ausführen“, die im Wesentlichen bedeuten: „Tu, was du willst.“
Devin arbeitet mit drei Tools: Shell, Code-Editor, Browser. Das primäre Tool von Claude Code ist ebenfalls eine Shell. OpenClaw verwendet ein dynamisches Skills-Plugin-System. Der Trend bei agentischen Coding-Tools ging hin zu weniger, allgemeineren Tools statt vielen spezifischen.
Simon Willison beobachtete, dass MCP für Coding Agents „anfangs explodierte, dann aber weniger zentral wirkte“, weil Bash das universelle Tool ist. Dateien und Skripte sind ein Primitive mit geringerem Overhead als vollständige MCP-Server-Implementierungen. Wenn der Agent Code schreiben und ausführen kann, kann er fast alles tun, ohne eine dedizierte Tool-Definition zu benötigen.
Aber allgemeine Tools funktionieren für allgemeine Agenten. Für domänenspezifische AI Agents (Kundensupport, Vertrieb, interne Abläufe) brauchst du domänenspezifische Tools. Dein Support-Agent sollte nicht Python schreiben, um den Status einer Bestellung zu prüfen. Er sollte einen klar definierten API-Endpunkt mit klaren Parametern und vorhersehbaren Antworten aufrufen. Das Design deines Tool-Sets wird zu einer Produktentscheidung.
| Ansatz | Beispiel | Kontrolle | Flexibilität | Anwendungsfall |
|---|---|---|---|---|
| Allgemeines Tool | Bash, Python-Interpreter | Minimal | Maximal | Coding Agents, persönliche Assistenten |
| Protokoll-Bundle (MCP) | Shopify MCP, GitHub MCP | Mittel | Mittel | Schnelle Integration, Prototyping |
| Einzelner API-Endpunkt | „HubSpot-Kontakt erstellen“ | Maximal | Minimal | Produktive kundenorientierte Agenten |
Was ein API-Endpunkt heute bedeutet
Für AI Agents funktioniert ein API-Endpunkt als Fähigkeitserklärung. Einen zu veröffentlichen bedeutet, dass du (oder dein AI Agent) nun etwas tun kannst, was vorher nicht möglich war.
Das funktioniert in beide Richtungen. Ein Softwareanbieter veröffentlicht eine API, damit andere sein Produkt integrieren können. Ein AI Agent kann aber auch selbst Endpunkte finden, indem er Dokumentation durchsucht, OpenAPI-Spezifikationen liest oder wörtlich googelt, wie eine Aufgabe zu erledigen ist.
Ein MCP-Server ist ein kuratiertes Bundle von API-Endpunkten mit einer vorgefassten Vorstellung davon, wie sie verwendet werden sollten. Der MCP-Ersteller hat bereits entschieden, welche Endpunkte verfügbar gemacht werden, wie sie heißen, welche Parameter sichtbar sind und implizit welche Workflows unterstützt werden. Diese Kuration ist zugleich die Stärke (Komfort, Standardisierung) und die Schwäche (Starrheit, meinungsstarke Eingrenzung). Notions Server ist ein konkretes Beispiel: Er veröffentlicht 28 Tools, und ein Help-Center-Agent benötigt vier davon, aufgeteilt auf zwei Verbindungen.
MCPs tauschen Kontrolle gegen einfache Nutzung. Im Jahr 2026 schreibt KI den Großteil des Integrationscodes. Wenn ein Agent API-Dokumentation lesen und die Integration selbst schreiben kann, wird das „einfache Nutzung“-Argument für MCP schwächer. Die MCP-Schicht ist möglicherweise vor allem in der Übergangszeit wichtig, solange das Tooling noch nicht zur Fähigkeit des Modells aufgeschlossen hat. Anthropics Leitfaden zu Designmustern für Tool-Nutzung ist eine praktische Referenz für die Strukturierung von Tool-Schemas, unabhängig davon, ob du MCP oder einzelne Endpunkte verwendest.
Eine verwandte Entwicklung: llms.txt ist ein vorgeschlagener Standard, bei dem Websites eine /llms.txt-Datei veröffentlichen, um KI-Modelle zu hochwertigen Ressourcen zu leiten. Anthropic, Cloudflare, Docker und Stripe haben ihn übernommen. MCP standardisiert Tool-Aufrufe; llms.txt standardisiert die Entdeckung von Dokumentation. Beide versuchen, das Web aus unterschiedlichen Blickwinkeln maschinenlesbarer zu machen.
Was ist ein API-Endpunkt im Kontext von AI Agents?
Ein API-Endpunkt ist eine bestimmte URL, die strukturierte Eingaben akzeptiert und strukturierte Ausgaben zurückgibt. Für AI Agents stellt jeder Endpunkt eine abgegrenzte Fähigkeit dar, also etwas, das der Agent in der realen Welt tun kann. Die Beschreibung des Endpunkts, Parameterdefinitionen und Fehlerantworten dienen als Bedienungsanleitung des Agenten. Je besser der Endpunkt dokumentiert ist, desto zuverlässiger kann ein Agent ihn verwenden.
Anders als menschliche Entwickler, die Tutorials lesen und iterativ debuggen können, verlässt sich ein Agent auf das Schema und die Beschreibung des Endpunkts, um einen einzelnen korrekten Aufruf zu machen. Deshalb ist API-Dokumentation, die für KI-Nutzung konzipiert ist, wichtiger denn je. Nur 24% der Entwickler entwerfen APIs derzeit mit AI Agents im Blick, obwohl 89% KI in ihrem Workflow nutzen.
Was ist MCP (Model Context Protocol)?
MCP ist ein offenes Protokoll, das von Anthropic eingeführt wurde, und standardisiert, wie AI Agents sich mit externen Tools und Datenquellen verbinden. Stell es dir als USB-C für KI vor. Ein einzelner Connector, den jeder Tool-Anbieter implementieren und jeder AI Agent nutzen kann. Ein MCP-Server stellt eine Reihe von Tools (im Wesentlichen API-Endpunkte) mit standardisierten Schemas bereit, und ein MCP-Client (der Agent) kann sie ohne eigenen Integrationscode entdecken und aufrufen. Eine ausführlichere technische Erklärung findest du in unserem Beitrag MCP erklärt. Einen praktischen Bericht zu MCP in Produktion findest du in unserer Analyse der realen Herausforderungen beim Aufbau auf Shopifys MCP.
Das Spektrum der Kontrolle in Quickchat AI
Quickchat AI bietet dir drei Möglichkeiten, einen AI Agent mit externen Tools auszustatten. Sie liegen auf einem Spektrum von maximal automatisiert bis maximal kontrolliert. Jeder Ansatz bringt einen anderen Kompromiss zwischen Einrichtungsgeschwindigkeit und Präzision des Verhaltens mit sich.
Remote MCP: Einstecken und loslegen
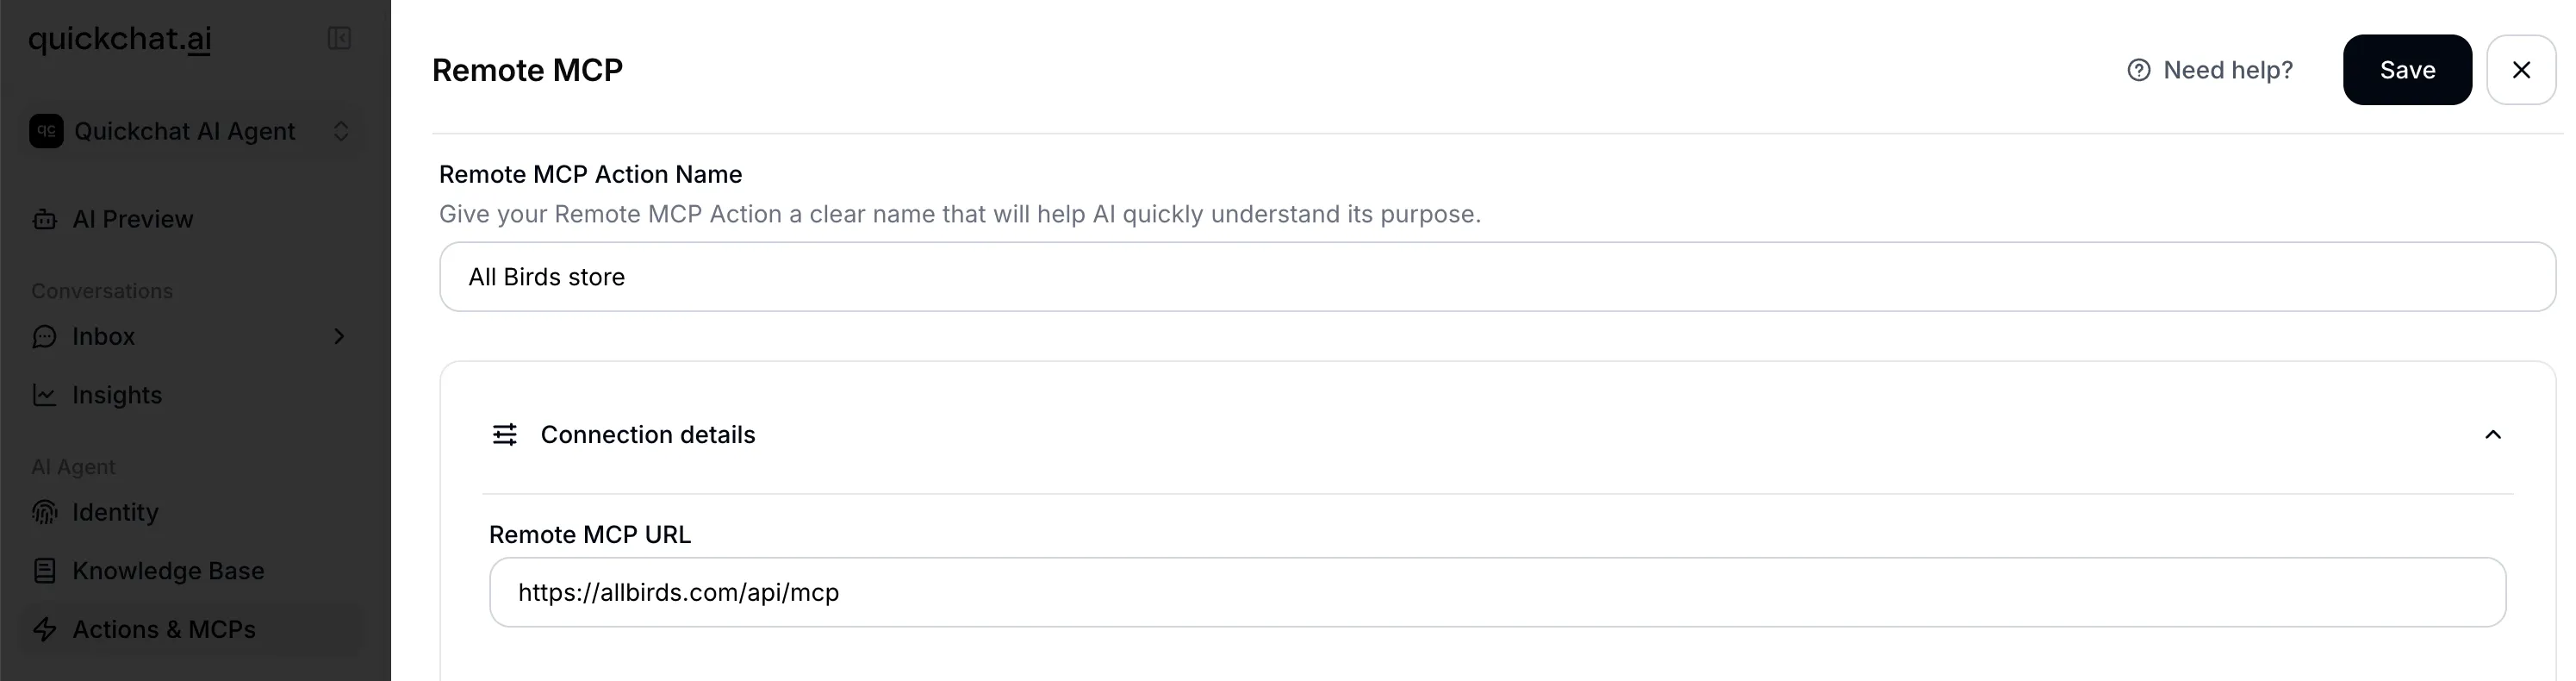
Remote MCP ist der schnellste Weg, einen AI Agent mit externer Funktionalität zu verbinden. Du stellst eine MCP-Server-URL bereit, Quickchat AI verbindet sich damit, erkennt alle verfügbaren Tools und lässt dich auswählen, welche davon dein Agent verwenden soll.
So richtest du es ein:
- Gehe zu AI Actions im Quickchat AI Dashboard
- Klicke auf “Add Remote MCP”
- Füge deine MCP-Server-URL ein (z. B.
https://mcp.example.com/sse) - Füge optional ein Authentifizierungstoken oder benutzerdefinierte Header hinzu (beides schließt sich gegenseitig aus)
- Klicke auf “Connect.” Quickchat AI erkennt alle verfügbaren Tools und zeigt ihre Namen an
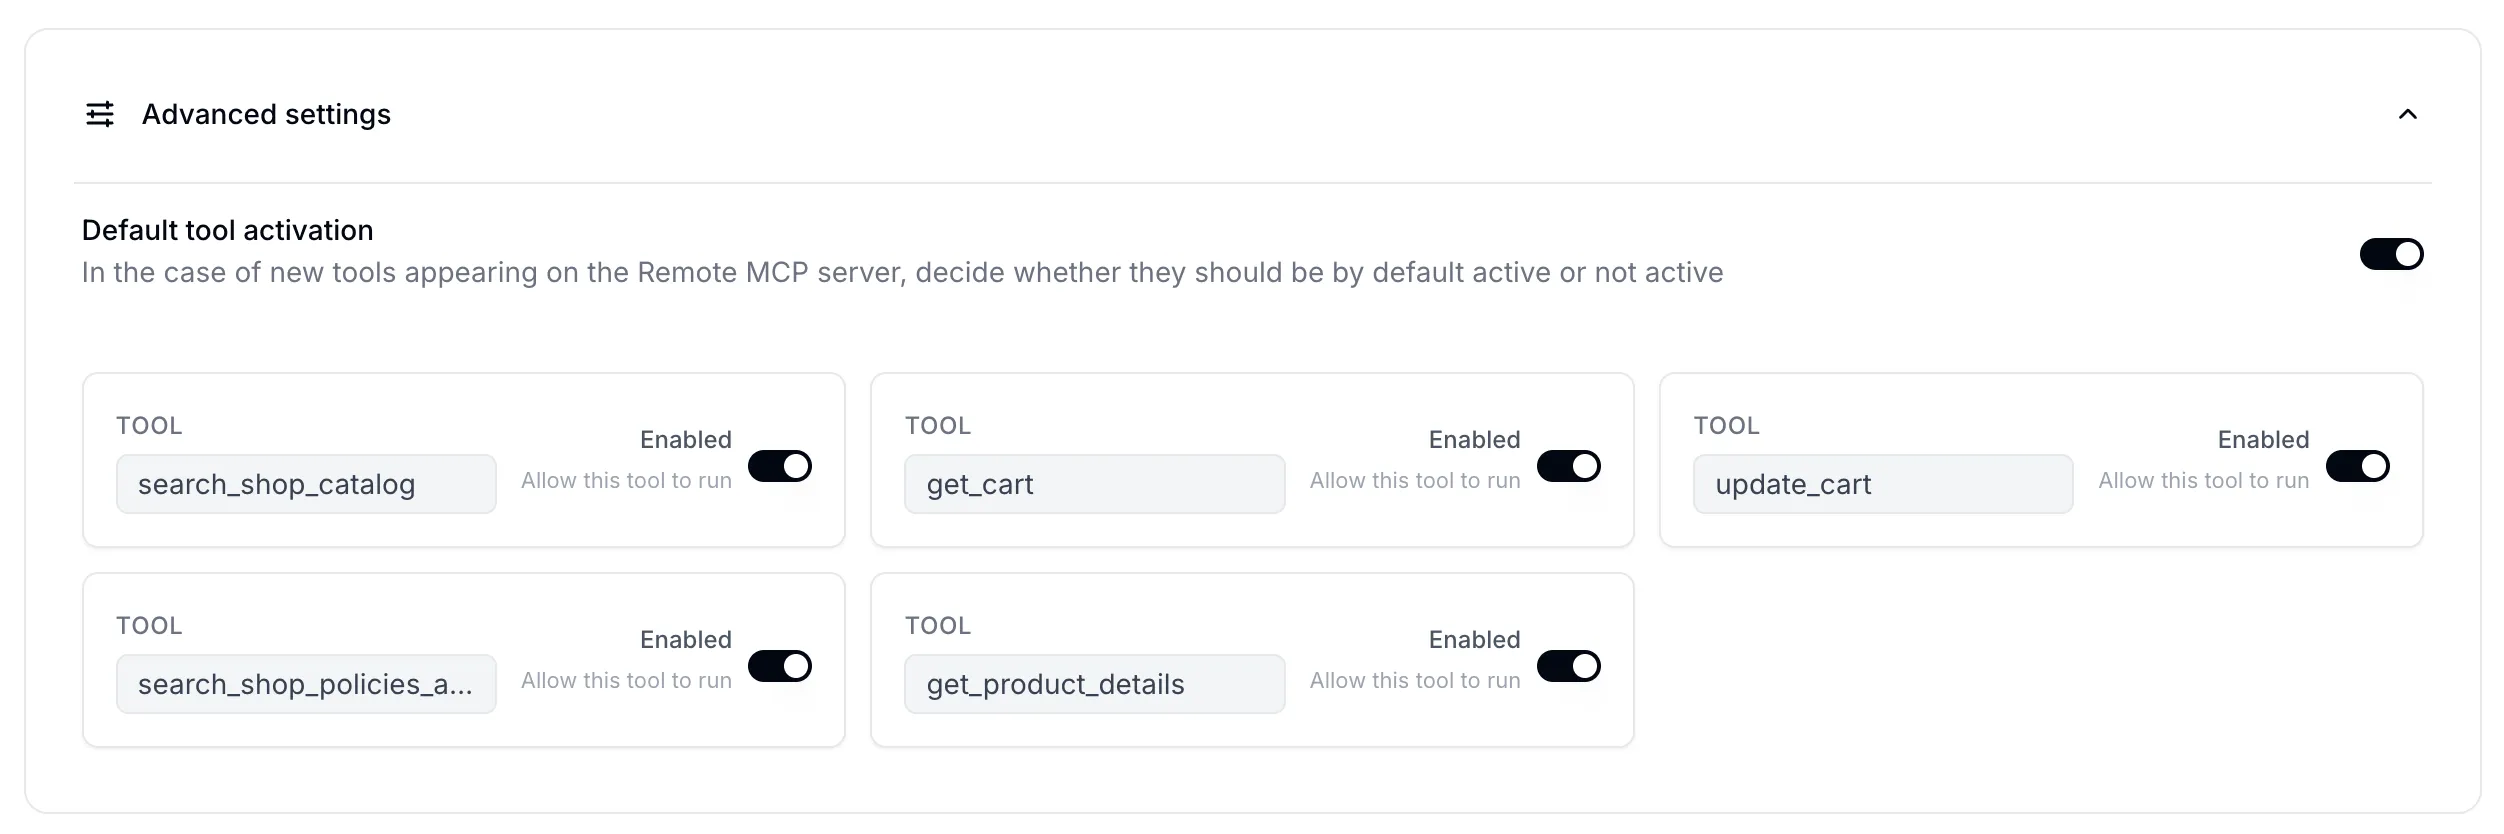
- Schalte einzelne Tools ein oder aus, um zu steuern, welche dein Agent verwenden kann
- Setze das Flag “default tool is active”, um zu steuern, ob neu entdeckte Tools automatisch aktiviert oder deaktiviert werden
Was unter der Haube passiert:
Wenn du auf Connect klickst, erkennt Quickchat AI das Transportprotokoll automatisch anhand der URL. Wenn die URL sse enthält, wird SSE-Transport verwendet, andernfalls ist streamable_http der Standard. Wenn du ein Auth-Token angibst, wird es als Bearer-Token im Authorization-Header gesendet.
Tool-Filtering funktioniert über ein dreistufiges System. Jedes Tool vom MCP-Server wird gegen zwei Mengen geprüft: explizit aktivierte Tools werden immer eingeschlossen, explizit deaktivierte Tools werden immer ausgeschlossen, und jedes Tool, das in keiner der beiden Mengen enthalten ist, fällt auf die von dir gewählte Einstellung “default tool is active” zurück. Das bedeutet: Wenn ein MCP-Server neue Tools hinzufügt, steuerst du, ob sie deinem Agenten automatisch zur Verfügung stehen oder eine explizite Aktivierung erfordern.
Zur Laufzeit, wenn eine Unterhaltung beginnt, werden alle aktiven Remote-MCP-Verbindungen für den Agenten geladen. Tools werden pro Konfiguration der jeweiligen Verbindung abgerufen und gefiltert, und die Eindeutigkeit der Tool-Namen wird über alle Quellen hinweg geprüft (mit einer Warnung, falls Duplikate gefunden werden).
Der Kompromiss: Du erhältst sofortigen Zugriff auf alles, was MCP bereitstellt, hast aber nur begrenzte Kontrolle über Tool-Beschreibungen, Parameterdefinitionen oder darüber, wie der Agent entscheidet, sie zu verwenden. Wie wir beim Aufbau eines AI Agent auf Shopifys MCP festgestellt haben, erfordert der Weg von der Demo zur Produktion sorgfältiges Tuning, das der gebündelte Ansatz von MCP erschweren kann.
Siehe auch: deinen Agenten mit einem Remote-MCP-Server verbinden, So startest du dein Quickchat AI MCP, Sicherheitsüberlegungen zu MCP, Quickchat AI Docs: MCP Channel.
AI Actions (HTTP Request): Ein Endpunkt, volle Kontrolle
Eine AI Action in Quickchat AI ist ein einzelner HTTP-API-Endpunkt, den du individuell für deinen AI Agent konfigurierst. Während MCP ein Bundle von Tools auf einmal importiert, gibt dir jede AI Action volle Kontrolle über eine bestimmte Fähigkeit. Ein vollständiges Beispiel mit vier Actions, die Kontakte erstellen und anreichern, Deals protokollieren und Tickets in einem CRM öffnen, findest du im HubSpot AI Actions-Tutorial.
Eine AI Action konfigurieren:
- Name (max. 64 Zeichen): Dies wird der Tool-Name, den das LLM sieht. Er wird zu einem gültigen Bezeichner normalisiert (z. B. wird “Check Order Status” zu
Check_Order_Status) - Description (max. 1.000 Zeichen): Dies ist das wichtigste Feld. Die Beschreibung sagt dem LLM, wann es dieses Tool verwenden soll. Gute Beschreibungen geben an, unter welchen Gesprächsumständen es aufgerufen werden soll, welche Informationen zuerst vom Nutzer einzuholen sind und wie Ergebnisse zurückkommuniziert werden sollen
- HTTP method: GET, POST, PATCH, DELETE oder PUT
- URL (max. 10.000 Zeichen): kann
{{parameter_name}}-Platzhalter für dynamische Werte enthalten - Headers: Schlüssel-Wert-Paare für Authentifizierung und Content Type
- Body items / Body JSON: Request Body mit Parameter-Injektion
- Query parameters: Werte für den URL-Query-String
- Parameters (max. 10): jeweils mit Name, Beschreibung (max. 500 Zeichen), Typ (
str,int,float,boolodercustom), Required-Flag und optionalem Standardwert
Die {{parameter_name}}-Platzhalter sind der zentrale Mechanismus. Wenn das LLM das Tool aufruft, liefert es Werte für jeden Parameter auf Basis des Gesprächskontexts. Quickchat AI fügt diese Werte dann in die Templates für URL, Header, Body und Query String ein, bevor der HTTP-Request ausgeführt wird. Es gibt außerdem vier eingebaute Variablen, die auf diese Weise eingefügt werden können: scenario_id, conversation_id, conversation_channel und conversation_url.
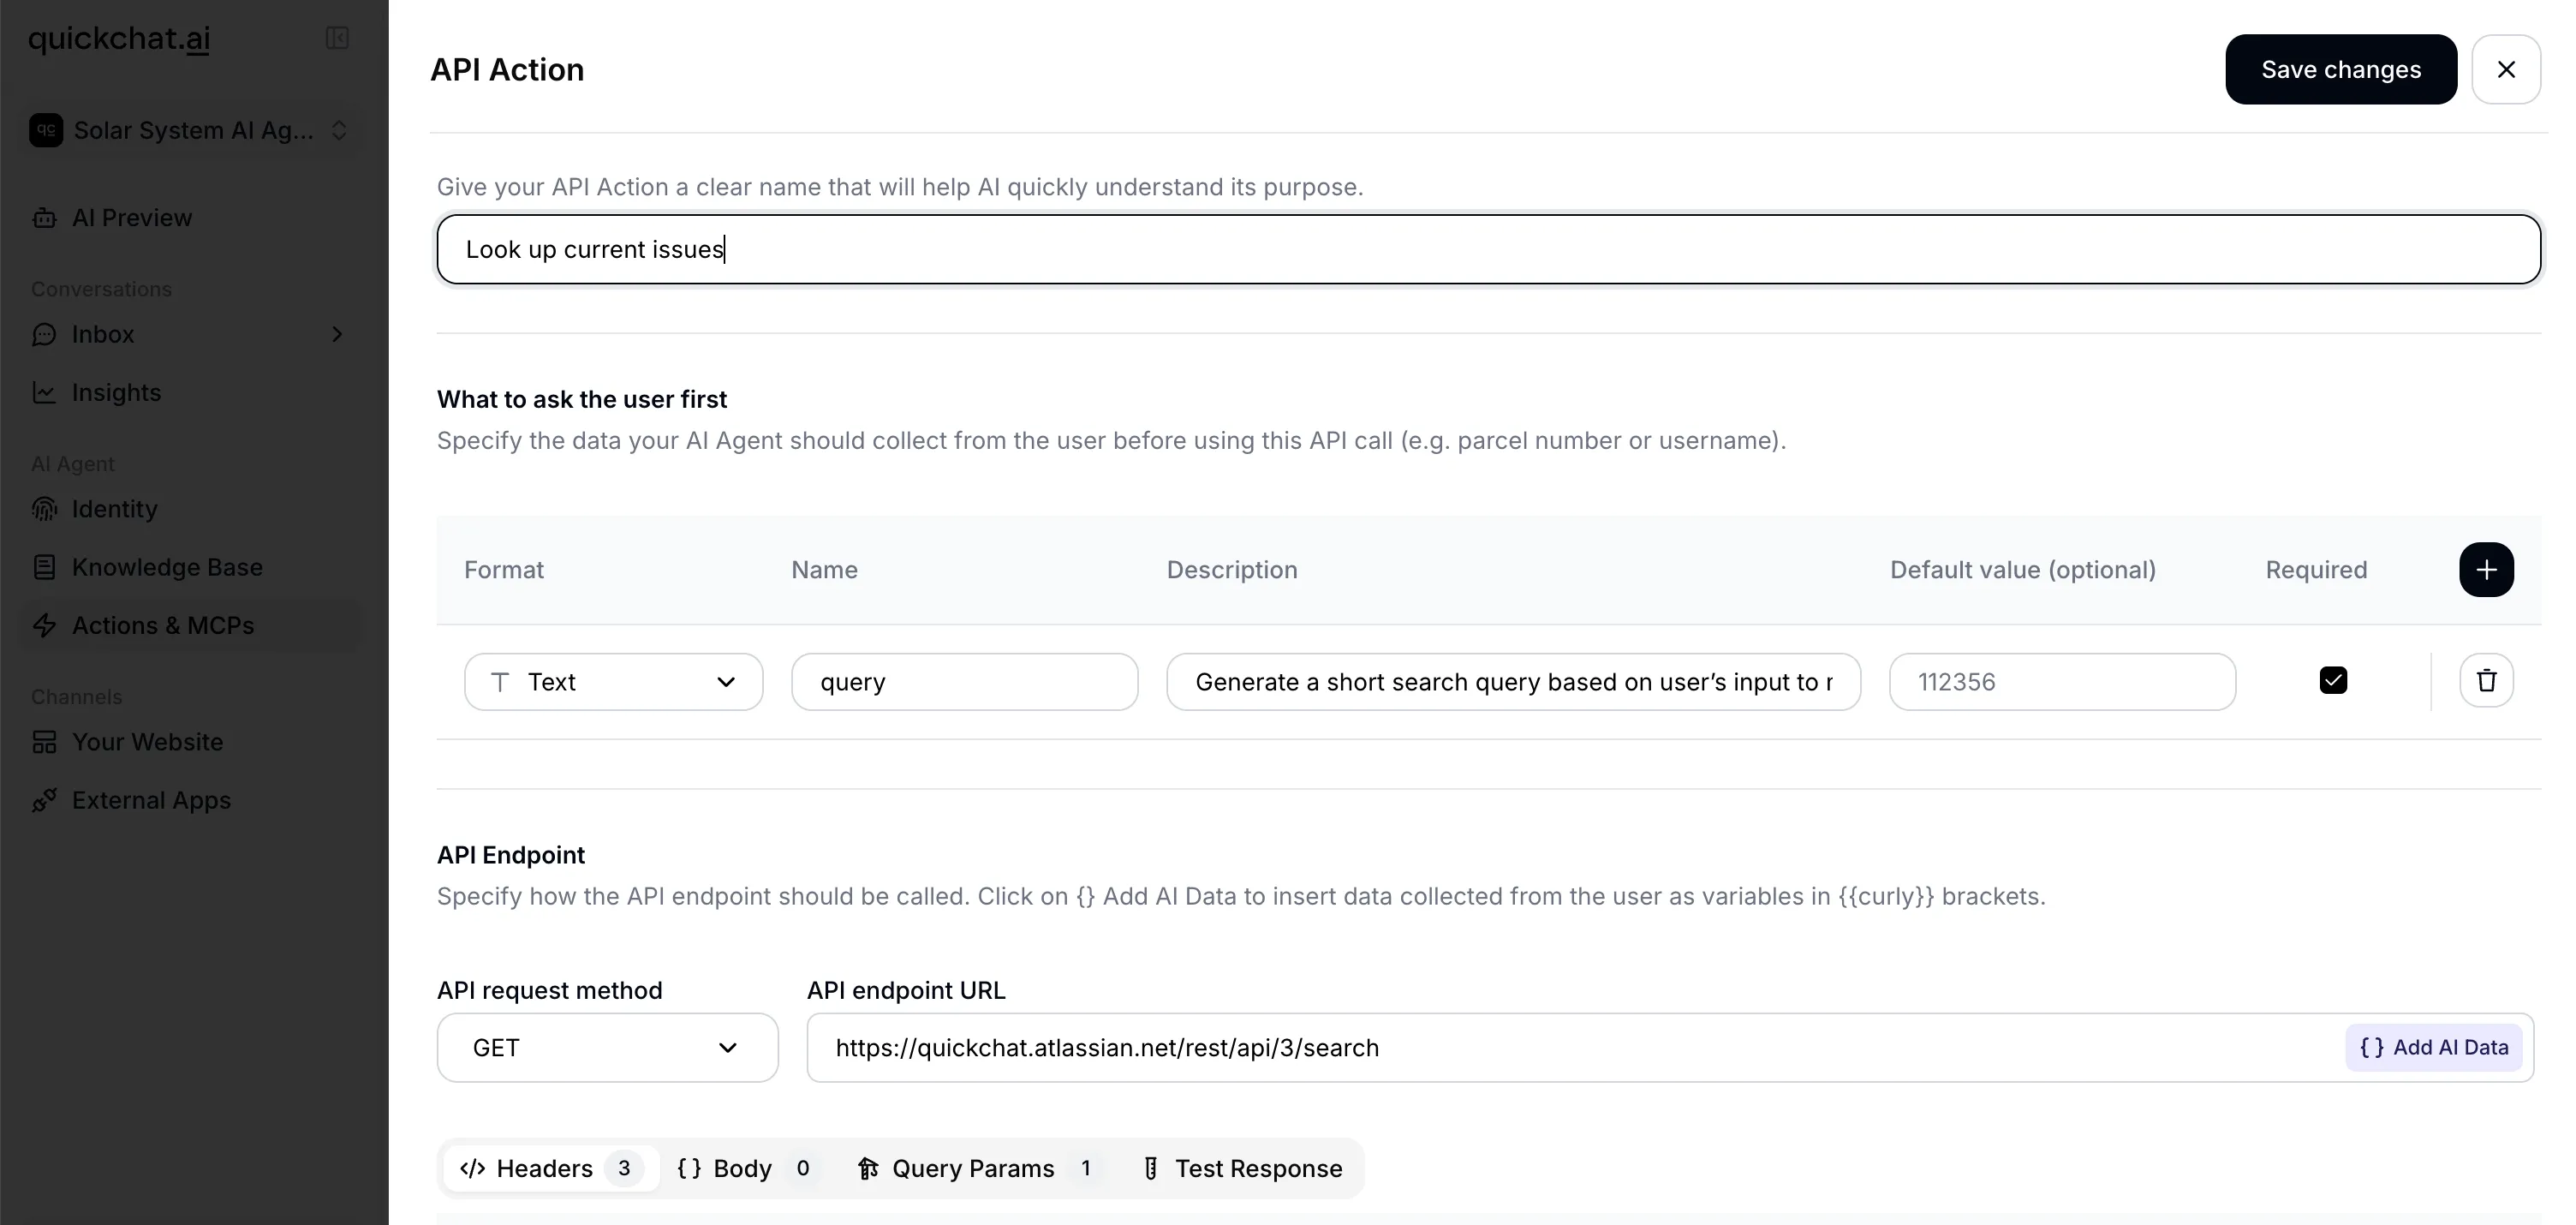 Eine AI Action, die zur Prüfung des Bestellstatus konfiguriert ist, mit URL-Template samt Parameter-Platzhalter, Headern und Parameterdefinitionen.
Unter der Haube: Quickchat AI erstellt für jede AI Action dynamisch ein typisiertes Schema aus deinen Parameterdefinitionen. Die fünf unterstützten Typen (str, int, float, bool, custom) werden ihren nativen Entsprechungen zugeordnet, und dieses Schema wird verwendet, um die Eingaben des LLM zu validieren, bevor der HTTP-Request ausgeführt wird.
Ein Beispiel für eine AI Action zur Prüfung des Bestellstatus:
{
  "name": "check_order_status",
  "description": "Wenn der Nutzer nach dem Status seiner Bestellung fragt und eine Bestellnummer angegeben hat, rufe diesen Endpunkt auf, um den aktuellen Status abzurufen. Teile dem Nutzer den Status, das geschätzte Lieferdatum und die Sendungsverfolgungsnummer (falls verfügbar) mit.",
  "method": "GET",
  "url": "https://api.example.com/orders/{{order_id}}",
  "headers": [
    { "name": "Authorization", "value": "Bearer YOUR_API_KEY" },
    { "name": "Content-Type", "value": "application/json" }
  ],
  "parameters": [
    {
      "name": "order_id",
      "description": "Die vom Nutzer angegebene Bestell-ID (z. B. ORD-12345)",
      "type": "str",
      "is_required": true
    }
  ]
}
Testing: Das Dashboard hat einen “Test”-Button, mit dem du Beispielwerte für Parameter angeben und den tatsächlichen HTTP-Request (einschließlich eines generierten curl-Befehls) sowie die Antwort sehen kannst, bevor du ihn bereitstellst.
Tipps zum Schreiben wirksamer AI Action-Beschreibungen:
- Gib genau an, wann der Agent sie aufrufen soll: „Wenn der Nutzer nach dem Status seiner Bestellung fragt und eine Bestellnummer angibt, rufe diesen Endpunkt auf“
- Erwähne, welche Informationen zuerst gesammelt werden sollen: „Stelle vor dem Aufruf sicher, dass du die E-Mail-Adresse des Nutzers und die Bestell-ID hast“
- Beschreibe, wie die Antwort zu behandeln ist: „Wenn der Status ‘shipped’ ist, teile dem Nutzer die Sendungsverfolgungsnummer aus der Antwort mit“
- Beschreibe bei mehrstufigen Workflows die Sequenz im Haupt-System-Prompt des Agenten statt in einzelnen Action-Beschreibungen. Um einen Wert zwischen Actions weiterzugeben und den Schreibvorgang daran zu knüpfen, verwende Save to memory plus eine Run-Condition
Ein ausgearbeitetes Beispiel: Eine Schritt-für-Schritt-AI Action, die Leads, unbeantwortete Fragen und Demo-Anfragen direkt in eine Tabelle protokolliert, findest du unter wie du einen AI Agent mit Google Sheets verbindest.
Generate from Text: Lass die KI es herausfinden
Die dritte Option ist für Nutzer, die wissen, was ihr Agent tun soll, aber nicht wissen, welchen API-Endpunkt (oder sogar welchen Dienst) sie verwenden sollen.
So funktioniert es:
- Du gibst eine Beschreibung in natürlicher Sprache ein, was du möchtest, z. B. „Ich möchte, dass mein AI Agent den Tesla eines Nutzers starten kann, wenn er darum bittet“
- Quickchat AI sendet dies an ein LLM mit aktiviertem
web_search-Tool - Das Modell recherchiert im Web, um die richtige API zu finden, liest offizielle Dokumentation und generiert eine vollständige AI Action-Spezifikation einschließlich URL, Methode, Headern, Parametern und Authentifizierungsanforderungen
- Das Ergebnis kommt mit der vollständigen Action-Konfiguration, Zitaten aus der verwendeten Dokumentation und einer erklärenden Nachricht zurück, die Annahmen und Lücken nennt
- Du prüfst das Ergebnis, trägst deine Zugangsdaten ein und aktivierst es
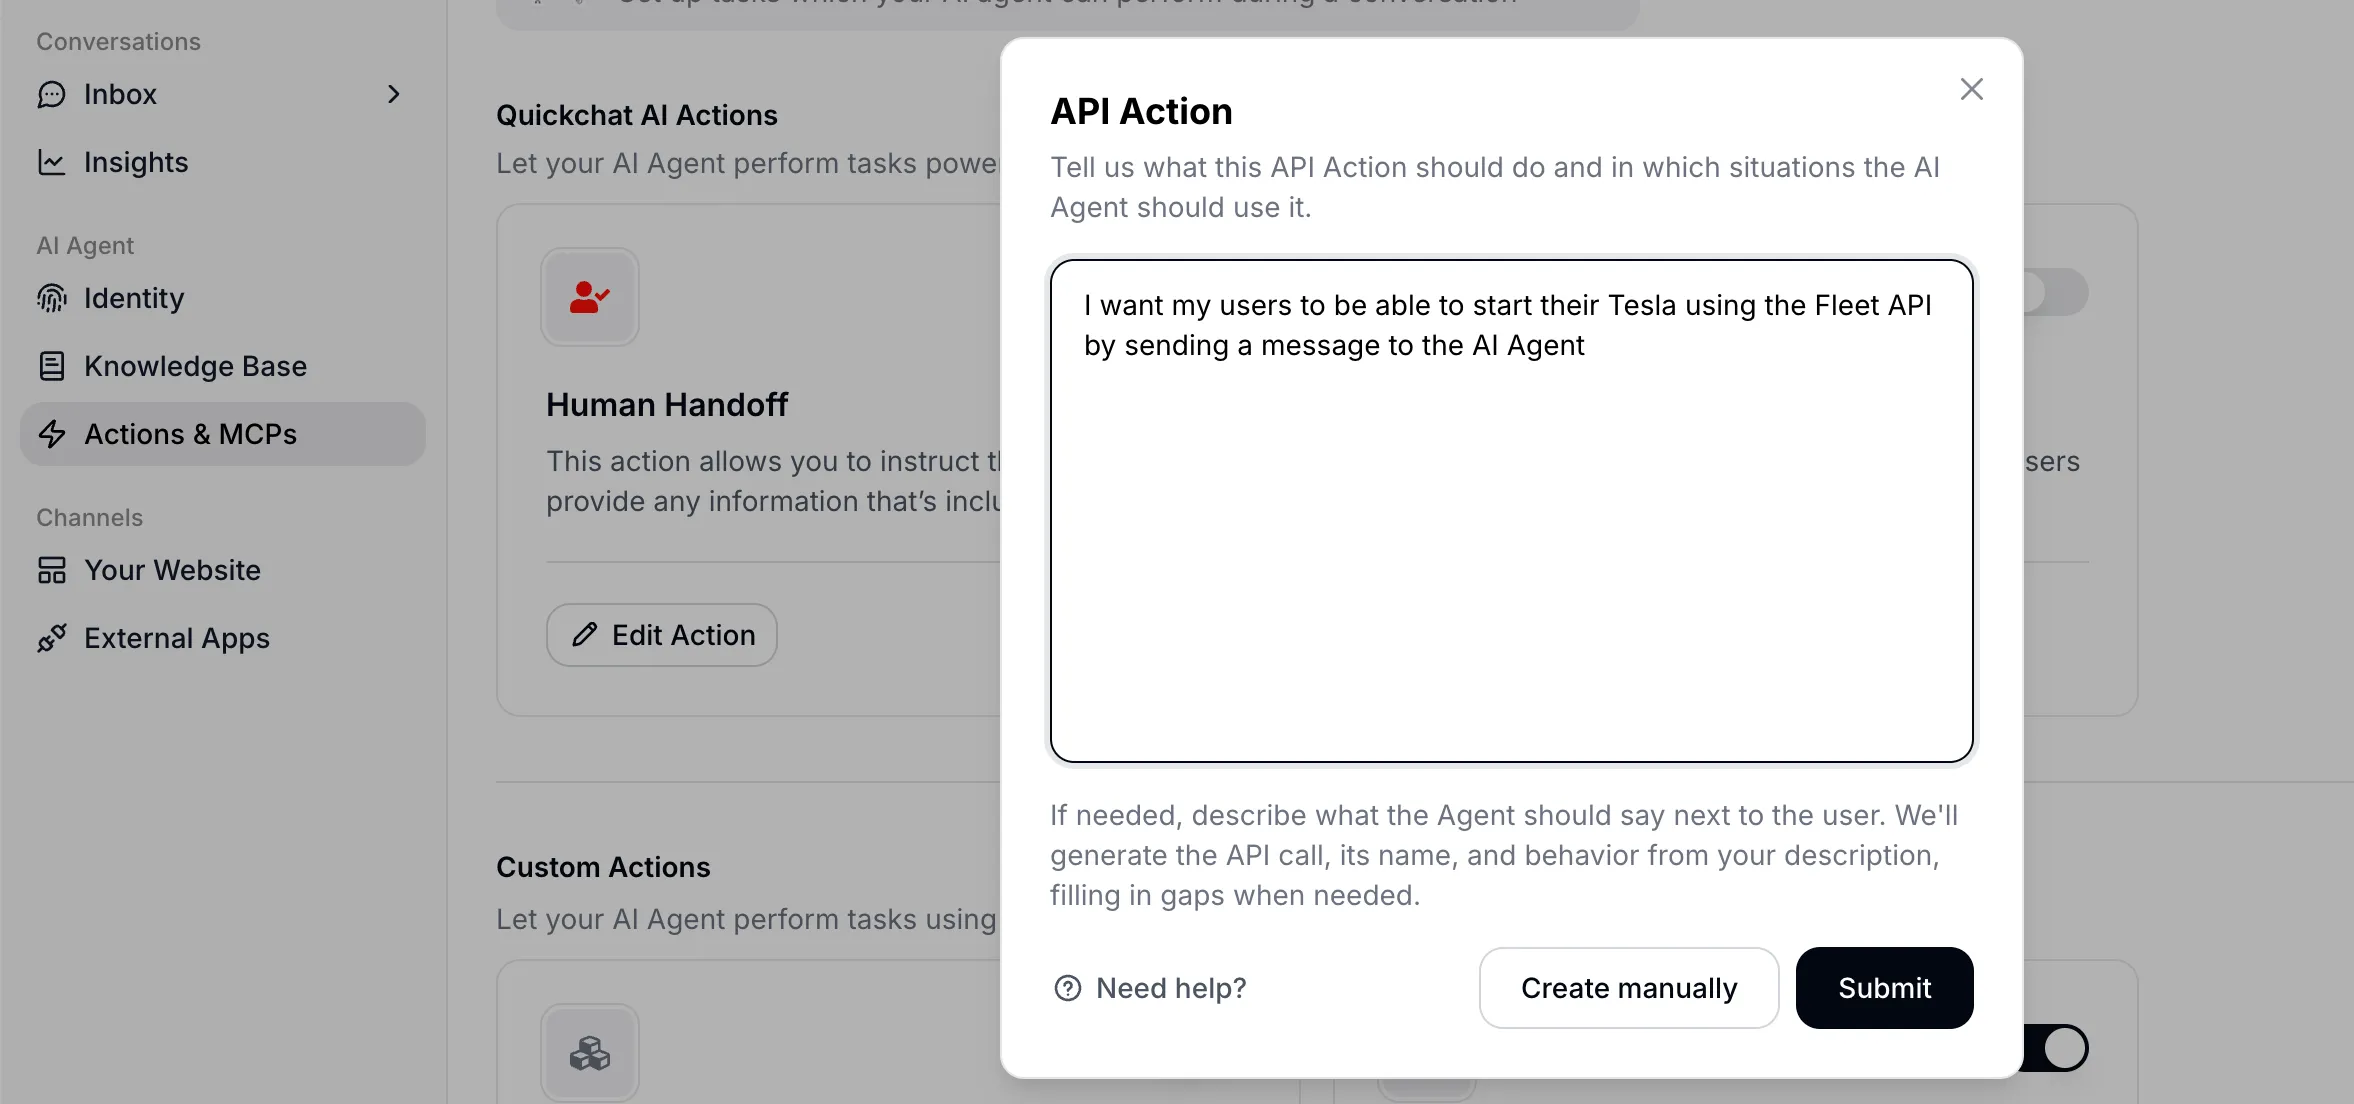 Eingabe einer Beschreibung der gewünschten Fähigkeit in natürlicher Sprache.
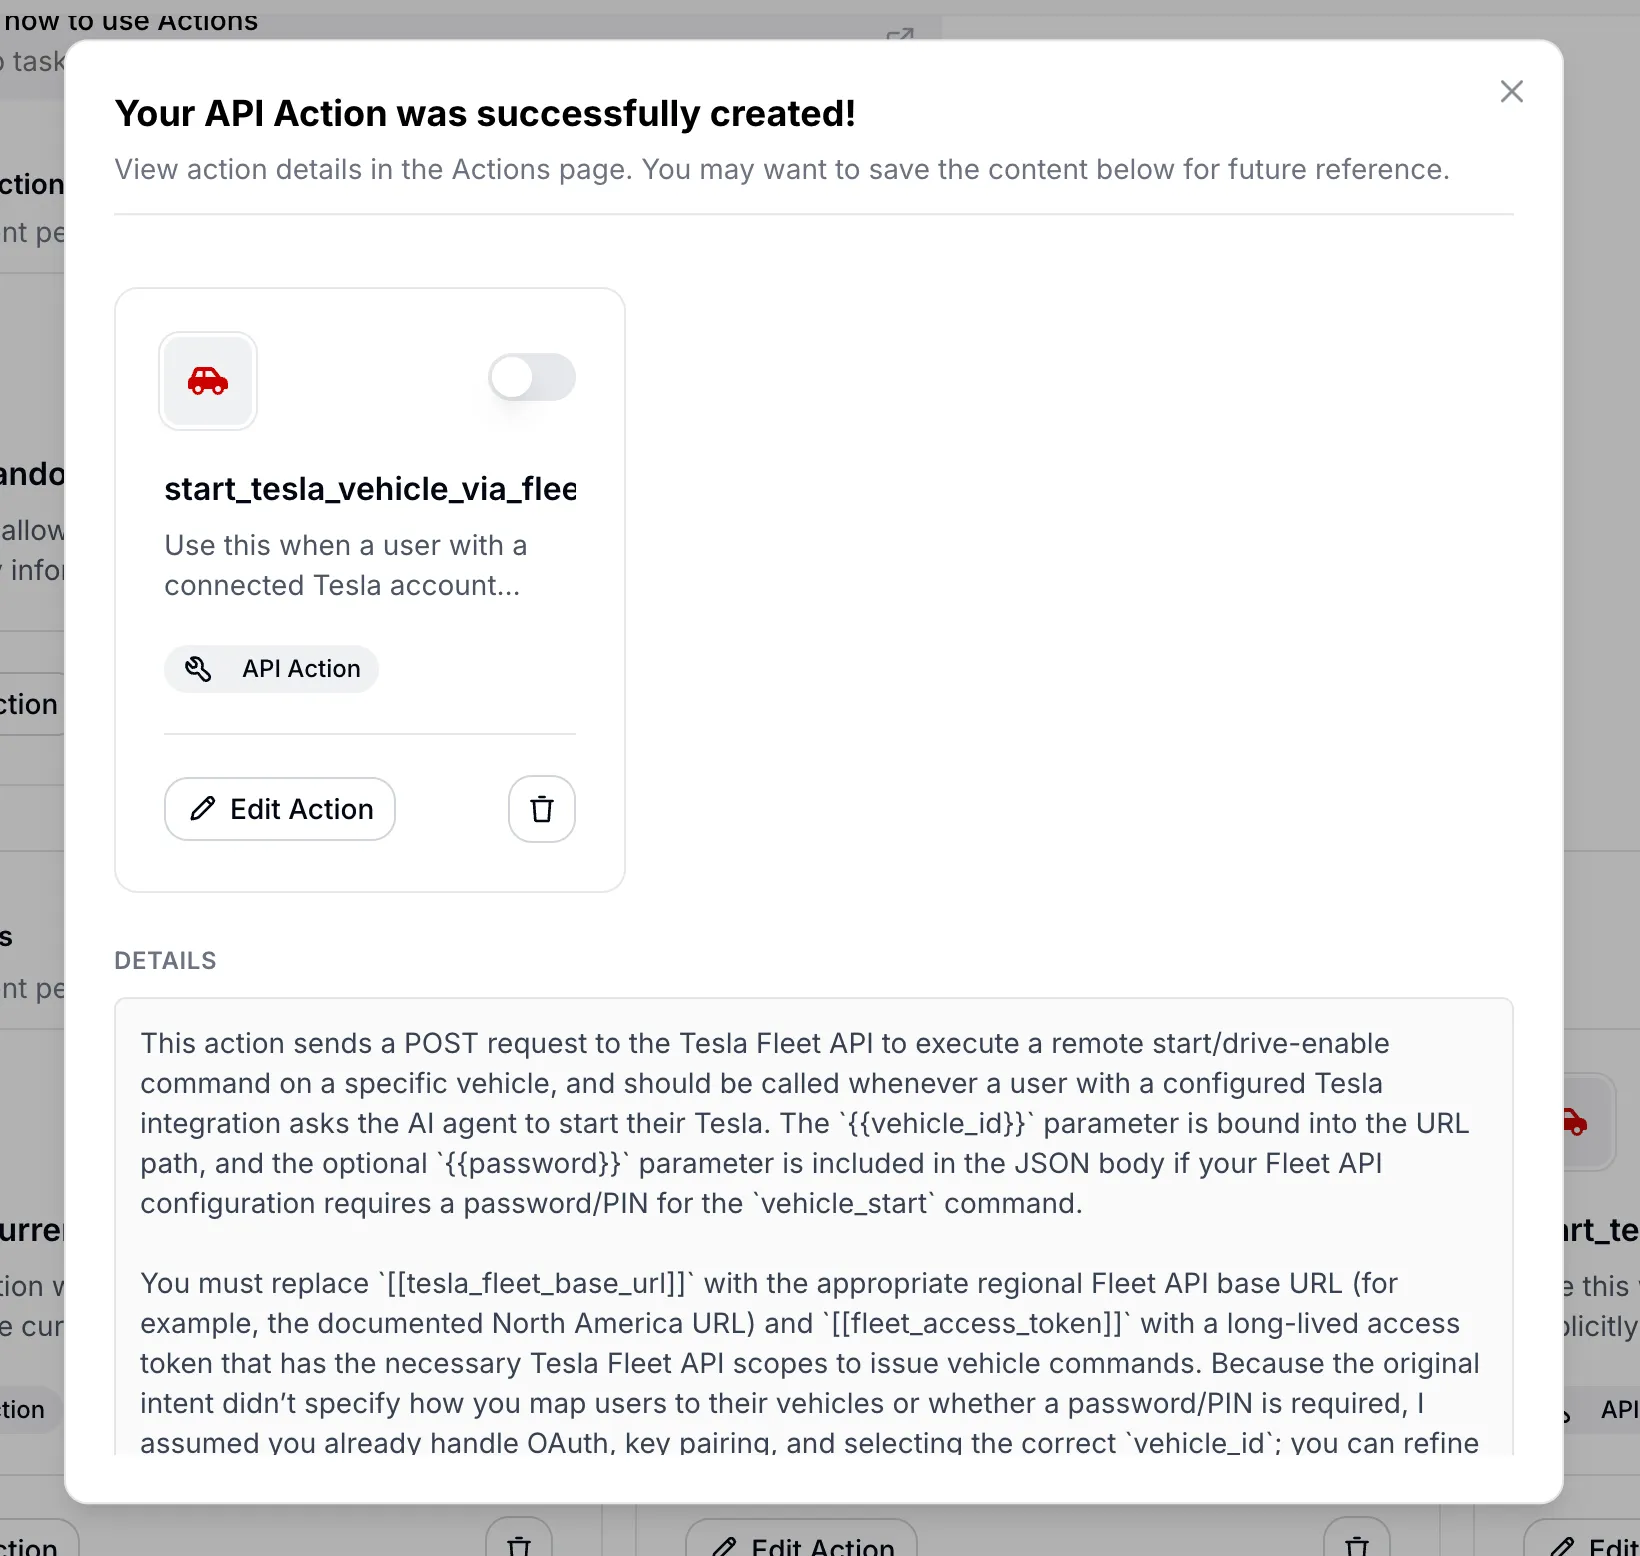 Die generierte AI Action-Konfiguration mit Zitaten aus der verwendeten API-Dokumentation.
Die automatisierte Generierung von AI Actions ist um drei Prioritäten herum strukturiert:
- Priorität 1: Absicht verstehen. Die genaue Fähigkeit identifizieren, die der Entwickler möchte, und den spezifischen API-Endpunkt, der sie bereitstellt
- Priorität 2: In Dokumentation verankern. Websuche verwenden, um offizielle Anbieter-Dokumentation zu finden, keine Vermutungen
- Priorität 3: Gesprächsorientierte Semantik entwerfen. Der generierte Name und die Beschreibung sollten darum gehen, wann in einer Unterhaltung dieses Tool verwendet wird, nicht nur darum, was die API technisch tut
Der Prompt verwendet zwei Platzhalter-Konventionen. {{param}} markiert Laufzeitparameter, die das LLM aus dem Gesprächskontext füllt. [[secret_name]] (doppelte eckige Klammern) markiert Entwicklerkonstanten wie API-Schlüssel und Account-IDs, die vor der Aktivierung manuell konfiguriert werden müssen. Jeder Parametername muss irgendwo in der Request-Definition als {{that_exact_name}}-Platzhalter erscheinen, und verwaiste Platzhalter sind nicht erlaubt.
Das System verwendet eine Fail-Closed-Policy. Wenn das Modell eine kritische Information nicht aus der Dokumentation bestätigen kann (die HTTP-Methode, URL, das Authentifizierungsschema oder die erforderliche Payload-Struktur), wird keine Action erstellt. Stattdessen gibt das System eine knappe Erklärung zurück, was fehlt, anstatt zu raten.
Hier verbindet sich der philosophische Punkt über AI Agents, die APIs entdecken, mit einem konkreten Produktfeature. Das Feature Generate from Text ist wörtlich ein AI Agent (ein LLM mit Websuche), der eine Tool-Definition für einen anderen AI Agent (den Quickchat AI Agent, der sie in Unterhaltungen verwenden wird) erstellt.
Ein ausgearbeitetes Beispiel: Das vollständige Tutorial, das aus zwei getippten Sätzen zwei live getestete Actions macht (eine Wetterabfrage ohne Schlüssel und eine NASA-Action mit Schlüssel, einschließlich der Fail-Closed-Ablehnung), findest du unter wie du deinen AI Agent in einfachem Englisch mit jeder API verbindest.
Zur Laufzeit werden all diese Tool-Typen zusammengeführt. Quickchat AI sammelt HTTP-Request-AI Action-Tools, Shopify MCP-Tools, Knowledge Base-Tools, Remote MCP-Tools, Discord-Tools und andere benutzerdefinierte Tools in einer Sammlung, die dem LLM präsentiert wird. Das Modell sieht keinen Unterschied zwischen ihnen. Ein Remote MCP-Tool und eine manuell konfigurierte AI Action sehen identisch aus, sobald sie in der Tool-Liste stehen.
Offene APIs als neues SEO
Wenn AI Agents APIs autonom entdecken und verwenden werden, wird eine gut dokumentierte, einfach zu nutzende API zu einem Distributionsasset. Gartner prognostiziert, dass bis 2026 über 30% des Anstiegs der API-Nachfrage von AI Agents kommen wird.
Unternehmen mit offenen APIs und niedrigen Hürden bei Zugangsdaten können feststellen, dass ihre APIs zu ihrem besten Akquisitionskanal werden. Statt Google-Suchimpressionen sind die „Impressionen“ AI Agents, die deinen Dienst statt den eines Wettbewerbers wählen.
Dieselbe Logik gilt eine Ebene höher. Ein AI Agent, der aus deiner Dokumentation antwortet, kann selbst als MCP-Server bereitgestellt werden, den ChatGPT, Claude und Cursor als Tool aufrufen. Dadurch wird dein Wissen, nicht nur deine API, für das agentische Web auffindbar.
Die Qualität deiner API-Dokumentation bestimmt, ob ein AI Agent sich in einem einzigen Versuch erfolgreich mit dir integrieren kann. Parameterbeschreibungen, Fehlermeldungen und Beispielantworten erfüllen dieselbe Funktion wie Meta-Beschreibungen und strukturierte Daten im traditionellen SEO. Eine verwirrende Fehlerantwort oder ein undokumentiertes Pflichtfeld bedeutet, dass ein Agent scheitert, und auf der anderen Seite ist kein Mensch, der es debuggt.
Unternehmen, deren APIs undokumentiert sind oder hinter umfangreichen Zugangsdatenanforderungen liegen, könnten für das agentische Web unsichtbar werden, ähnlich wie Unternehmen ohne Websites in den 2000er-Jahren für Google unsichtbar wurden.
Computer Use vs. APIs
Es gibt erhebliche Investitionen darin, KI-Modellen „Computer Use“ beizubringen (Buttons anklicken, Formulare ausfüllen, UIs navigieren). Anthropic, OpenAI (Operator) und Open-Source-Projekte wie Browser Use bieten alle Varianten davon an.
Aber Browser-Nutzung ist ein Workaround für eine fehlende API. Ein POST /orders-Aufruf dauert Millisekunden und gibt strukturierte Daten zurück. Ein Browser-Agent, der einen Checkout-Flow navigiert, braucht Minuten und kann scheitern, wenn ein Button drei Pixel nach links verschoben wird. APIs sind schneller, deterministischer und günstiger auszuführen.
Das Gegenargument ist real: APIs existieren nicht für alles. Legacy-Systeme, Unternehmenssoftware ohne API-Oberfläche, physische Geräte, die über GUIs gesteuert werden. Computer Use schließt in diesen Fällen eine echte Lücke.
Die bessere langfristige Antwort auf „Wir haben dafür keine API“ ist wahrscheinlich, die API zu bauen, statt KI beizubringen, die GUI zu benutzen. Wenn mehr Software von AI Agents für AI Agents geschrieben wird, sinken die Kosten für Aufbau und Wartung von APIs. Die wirtschaftliche Rechnung, die es günstiger machte, eine UI zu scrapen, als eine API zu bauen, verschiebt sich.
Es gibt auch einen Sicherheitsaspekt. Simon Willisons “lethal trifecta” beschreibt die gefährliche Kombination aus Zugriff auf private Daten + Exposition gegenüber nicht vertrauenswürdigen Inhalten + externe Kommunikation. Das gilt für beide Ansätze, aber API-basierte Tools sind leichter zu auditieren und einzuschränken. Du kannst jeden API-Aufruf protokollieren, jeden Parameter validieren und für jeden Endpunkt Rate Limits setzen. Dasselbe für einen Browser-Agenten zu tun, der auf alles klicken kann, ist deutlich schwieriger.
Tools für die physische Welt
Alles, was bisher besprochen wurde, betrifft Software. Dasselbe Muster zeigt sich in der physischen Welt.
Google DeepMinds RT-2 und Gemini Robotics verwenden dieselbe Architektur, nur dass die Tools an Aktuatoren statt an APIs dispatchen. Das SPCA (Sense-Plan-Code-Act)-Framework formalisiert dies für die Robotik: Umgebung erfassen, Vorgehen planen, ausführbaren Code generieren, ihn ausführen, Ergebnisse beobachten.
Es gibt keine API für „verschiebe die Pflanze auf meinem Schreibtisch nach rechts“. Aber ein Roboter mit Kamera könnte move_object(object_id="plant_01", direction="right", distance_cm=15) spontan als Tool definieren und es dann aufrufen. Die Tool-Definition dient als Schnittstelle zwischen der Reasoning-Schicht und der physischen Ausführungsschicht, also derselben Rolle, die API-Endpunkte in Software spielen.
Die Architektur LLM + Tools + Schleife ist universell einsetzbar. Sie ist heute zufällig am einfachsten in Software umzusetzen, aber die Robotik holt auf.
APIs, geschrieben von KI für KI
In ungefähr zwei Jahren (2024 bis 2026) sind wir von einer Welt, in der der meiste Code von Menschen geschrieben wurde, zu einer Welt übergegangen, in der der meiste Code von KI geschrieben wird. Dies ist ein guter Moment, um neu zu betrachten, was ein API-Endpunkt ist. Zunehmend ist ein Endpunkt eine Fähigkeitserklärung, die dafür entworfen ist, von Maschinen entdeckt und ausgeführt zu werden, nicht eine technische Schnittstelle, über die menschliche Entwickler Dokumentation lesen und die sie dann manuell integrieren.
MCPs sind eine nützliche Standardisierungsschicht, aber sie sind auch eine Kurationsschicht, die Bias einführt. Der MCP-Ersteller entscheidet, welche Tools verfügbar gemacht und wie sie gerahmt werden. Für produktive AI Agents passt dieses Framing möglicherweise nicht zu dem, was du tatsächlich brauchst. (Wir haben darüber ausführlich geschrieben, als wir die Herausforderungen mit Shopifys MCP analysiert haben.)
Das Spektrum, das wir in Quickchat AI Agents durchgegangen sind, spiegelt einen breiteren Punkt wider. Das richtige Maß an Kontrolle hängt von deinem Anwendungsfall ab. Remote MCP funktioniert gut für schnelles Prototyping. Einzelne AI Actions geben dir feingranulare Kontrolle für produktive kundenorientierte Agenten. Generate from Text lässt KI die API recherchieren und die Tool-Definition für dich erstellen, während du noch explorierst.
Und auf jeder Ebene ist das zugrunde liegende Muster dasselbe. Ein LLM, ein Satz von Tools, eine Schleife. Ob die Tools Bash-Befehle, API-Endpunkte, MCP-Server oder Roboter-Aktuatoren sind, es sind Tools bis ganz nach unten.