

Když se LLM naučily volat funkce
V éře GPT-3 znamenala interakce s LLM předání promptu a získání textu zpět. Znalosti modelu byly rozsáhlé, ale statické, zmrazené v podobě toho, co obsahovala trénovací data. Mohl ses ho zeptat na vysvětlení kvantových počítačů nebo ho požádat o návrh e-mailu a vytvořil by věrohodný text. Nemohl ale zkontrolovat dnešní počasí, dotázat se databáze ani provést žádnou akci v reálném světě.
Funkci, která to změnila, se překvapivě nedostává velkého uznání. Dala modelu možnost volby mezi generováním textu a voláním funkce. Místo toho, aby model vždy vytvářel další token, mohl nově vypsat strukturovaný objekt JSON určující název funkce a její argumenty. Runtime by tuto funkci spustil, výsledek předal zpět modelu a model by odtud pokračoval. Článek ReAct (Yao et al., 2022) to formalizoval jako smyčku Thought-Action-Observation. Model uvažuje, co udělat, provede akci (zavolá nástroj), pozoruje výsledek a opakuje to. Každý seriózní AI agent v roce 2026 běží na nějaké verzi tohoto vzoru.
Smyčka
Claude Code, OpenClaw, Codex, Devin a desítky dalších agentních systémů fungují stejně. Zavolej nástroj, pozoruj výsledek, rozhodni se, co udělat dál, opakuj. Simon Willison to formuloval dobře: „LLM agent spouští nástroje ve smyčce, aby dosáhl cíle.“
Claude Code například používá jednovláknovou hlavní smyčku bez multiagentního roje nebo složitého orchestračního grafu: while(tool_call) -> execute -> feed results -> repeat.
Výzkum autonomie agentů od Anthropic ukazuje, že délka turnů v Claude Code se za tři měsíce téměř zdvojnásobila, z 25 na více než 45 minut. Uživatelé smyčce stále více důvěřují, že poběží samostatně. Data ukazují, že zkušení uživatelé přerušují častěji (přesun od schvalování každé akce ke strategickému monitorování), zatímco agent sám žádá o upřesnění více než dvakrát častěji, než ho uživatelé přerušují.
Tento vzor smyčky se objevuje všude, u programovacích agentů, botů zákaznické podpory i robotických řadičů.
Co se počítá jako nástroj?
LLM nám dávají značnou volnost při rozhodování, na jaké úrovni abstrakce má nástroj fungovat. Na jednom konci jsou vysoce specifické API endpointy: „vytvoř kontakt v HubSpot s těmito 12 poli“. Na druhém konci jsou nástroje jako „spusť tento bash příkaz“ nebo „spusť tento Python kód“, což v podstatě znamená „udělej, co chceš“.
Devin pracuje se třemi nástroji: shell, editor kódu, prohlížeč. Hlavním nástrojem Claude Code je také shell. OpenClaw používá dynamický systém pluginů pro dovednosti. Trend u agentních programovacích nástrojů směřuje k menšímu počtu obecnějších nástrojů, nikoli k mnoha specifickým nástrojům.
Simon Willison poznamenal, že MCP „zpočátku explodovalo, ale pak působilo méně centrálně“ pro programovací agenty, protože bash je univerzální nástroj. Soubory a skripty jsou primitivum s nižší režií než plné implementace MCP serverů. Pokud agent může psát a spouštět kód, může udělat téměř cokoli bez potřeby vyhrazené definice nástroje.
Obecné nástroje ale fungují pro obecné agenty. Pro doménově specifické AI agenty (zákaznická podpora, prodej, interní provoz) potřebuješ doménově specifické nástroje. Tvůj agent podpory by neměl psát Python, aby zkontroloval stav objednávky. Měl by zavolat dobře definovaný API endpoint s jasnými parametry a předvídatelnými odpověďmi. Návrh tvé sady nástrojů se stává produktovým rozhodnutím.
| Přístup | Příklad | Kontrola | Flexibilita | Případ použití |
|---|---|---|---|---|
| Obecný nástroj | Bash, Python interpreter | Minimální | Maximální | Programovací agenti, osobní asistenti |
| Balík protokolu (MCP) | Shopify MCP, GitHub MCP | Střední | Střední | Rychlá integrace, prototypování |
| Jeden API endpoint | „Create HubSpot contact“ | Maximální | Minimální | Produkční agenti pro zákazníky |
Co dnes znamená API endpoint
Pro AI agenty funguje API endpoint jako deklarace schopnosti. Jeho zveřejnění říká, že ty (nebo tvůj AI agent) teď umíš udělat něco, co předtím možné nebylo.
Funguje to oběma směry. Dodavatel softwaru publikuje API, aby se ostatní mohli integrovat s jeho produktem. AI agent ale může endpointy objevovat i sám, vyhledáváním v dokumentaci, čtením OpenAPI specifikací nebo doslova googlením, jak splnit úkol.
MCP server je kurátorovaný balík API endpointů s předem vytvořenou představou o tom, jak se mají používat. Tvůrce MCP už rozhodl, které endpointy vystavit, jak je pojmenovat, jaké parametry ukázat a implicitně jaké workflow podporovat. Tato kurace je silnou stránkou (pohodlí, standardizace) i slabinou (rigidita, názorově vymezený rozsah). Server Notion je konkrétní příklad: publikuje 28 nástrojů a agent help centra potřebuje čtyři z nich, rozdělené přes dvě připojení.
MCP vyměňuje kontrolu za snadné použití. V roce 2026 píše většinu integračního kódu AI. Pokud agent umí číst API dokumentaci a napsat integraci sám, argument „snadného použití“ pro MCP slábne. Vrstva MCP může být nejdůležitější během přechodného období, dokud nástroje nedoženou schopnosti modelu. Průvodce návrhovými vzory pro používání nástrojů od Anthropic je praktická reference pro strukturování schémat nástrojů bez ohledu na to, jestli používáš MCP nebo jednotlivé endpointy.
Související vývoj: llms.txt je navrhovaný standard, v němž weby publikují soubor /llms.txt, který navádí AI modely k hodnotným zdrojům. Přijaly ho Anthropic, Cloudflare, Docker a Stripe. MCP standardizuje volání nástrojů, llms.txt standardizuje objevování dokumentace. Oba se snaží udělat web čitelnější pro stroje, každý z jiného úhlu.
Co je API endpoint v kontextu AI agentů?
API endpoint je konkrétní URL, která přijímá strukturovaný vstup a vrací strukturovaný výstup. Pro AI agenty představuje každý endpoint samostatnou schopnost, něco, co agent dokáže udělat v reálném světě. Popis endpointu, definice parametrů a chybové odpovědi slouží jako návod k použití pro agenta. Čím lépe je endpoint zdokumentovaný, tím spolehlivěji ho agent dokáže použít.
Na rozdíl od lidských vývojářů, kteří mohou číst tutoriály a iterativně ladit, se agent spoléhá na schéma a popis endpointu, aby provedl jedno správné volání. Proto je API dokumentace navržená pro spotřebu AI důležitější než kdy dřív. Jen 24% vývojářů dnes navrhuje API s ohledem na AI agenty, přestože 89% používá AI ve svém workflow.
Co je MCP (Model Context Protocol)?
MCP je otevřený protokol představený společností Anthropic, který standardizuje, jak se AI agenti připojují k externím nástrojům a datovým zdrojům. Představ si ho jako USB-C pro AI. Jeden konektor, který může implementovat libovolný poskytovatel nástroje a používat libovolný AI agent. MCP server vystavuje sadu nástrojů (v podstatě API endpointů) se standardizovanými schématy a MCP klient (agent) je může objevovat a volat bez vlastního integračního kódu. Hlubší technické vysvětlení najdeš v našem článku MCP Explained. Praktický pohled na MCP v produkci najdeš v naší analýze reálných výzev při stavbě na Shopify’s MCP.
Spektrum kontroly v Quickchat AI
Quickchat AI ti dává tři způsoby, jak vybavit AI Agenta externími nástroji. Leží na spektru od nejvíce automatizovaného po nejvíce kontrolovaný. Každý přístup dělá jiný kompromis mezi rychlostí nastavení a přesností chování.
Remote MCP: připoj a používej
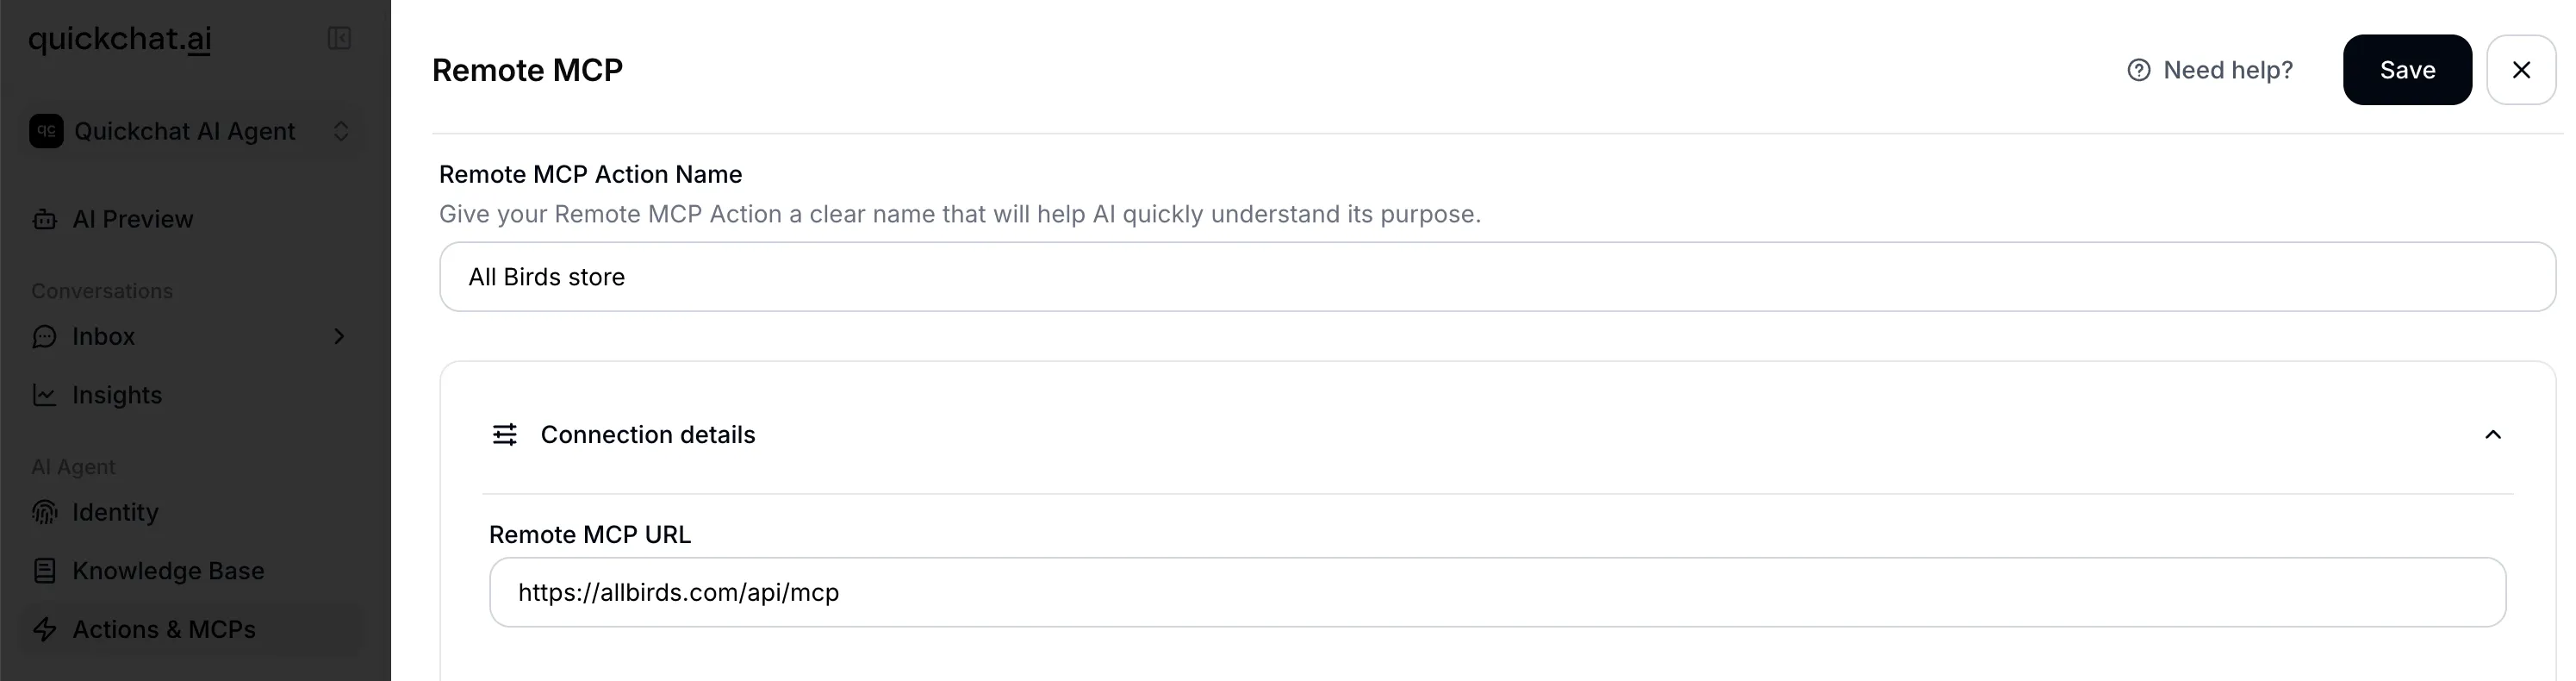
Remote MCP je nejrychlejší způsob, jak připojit AI Agenta k externí funkcionalitě. Zadáš URL MCP serveru, Quickchat AI se k němu připojí, objeví všechny dostupné nástroje a umožní ti vybrat, které má tvůj agent používat.
Jak ho nastavit:
- Přejdi do AI Actions v dashboardu Quickchat AI
- Klikni na “Add Remote MCP”
- Vlož URL svého MCP serveru (např.
https://mcp.example.com/sse) - Volitelně přidej autentizační token nebo vlastní hlavičky (tyto dvě možnosti se vzájemně vylučují)
- Klikni na “Connect.” Quickchat AI objeví všechny dostupné nástroje a zobrazí jejich názvy
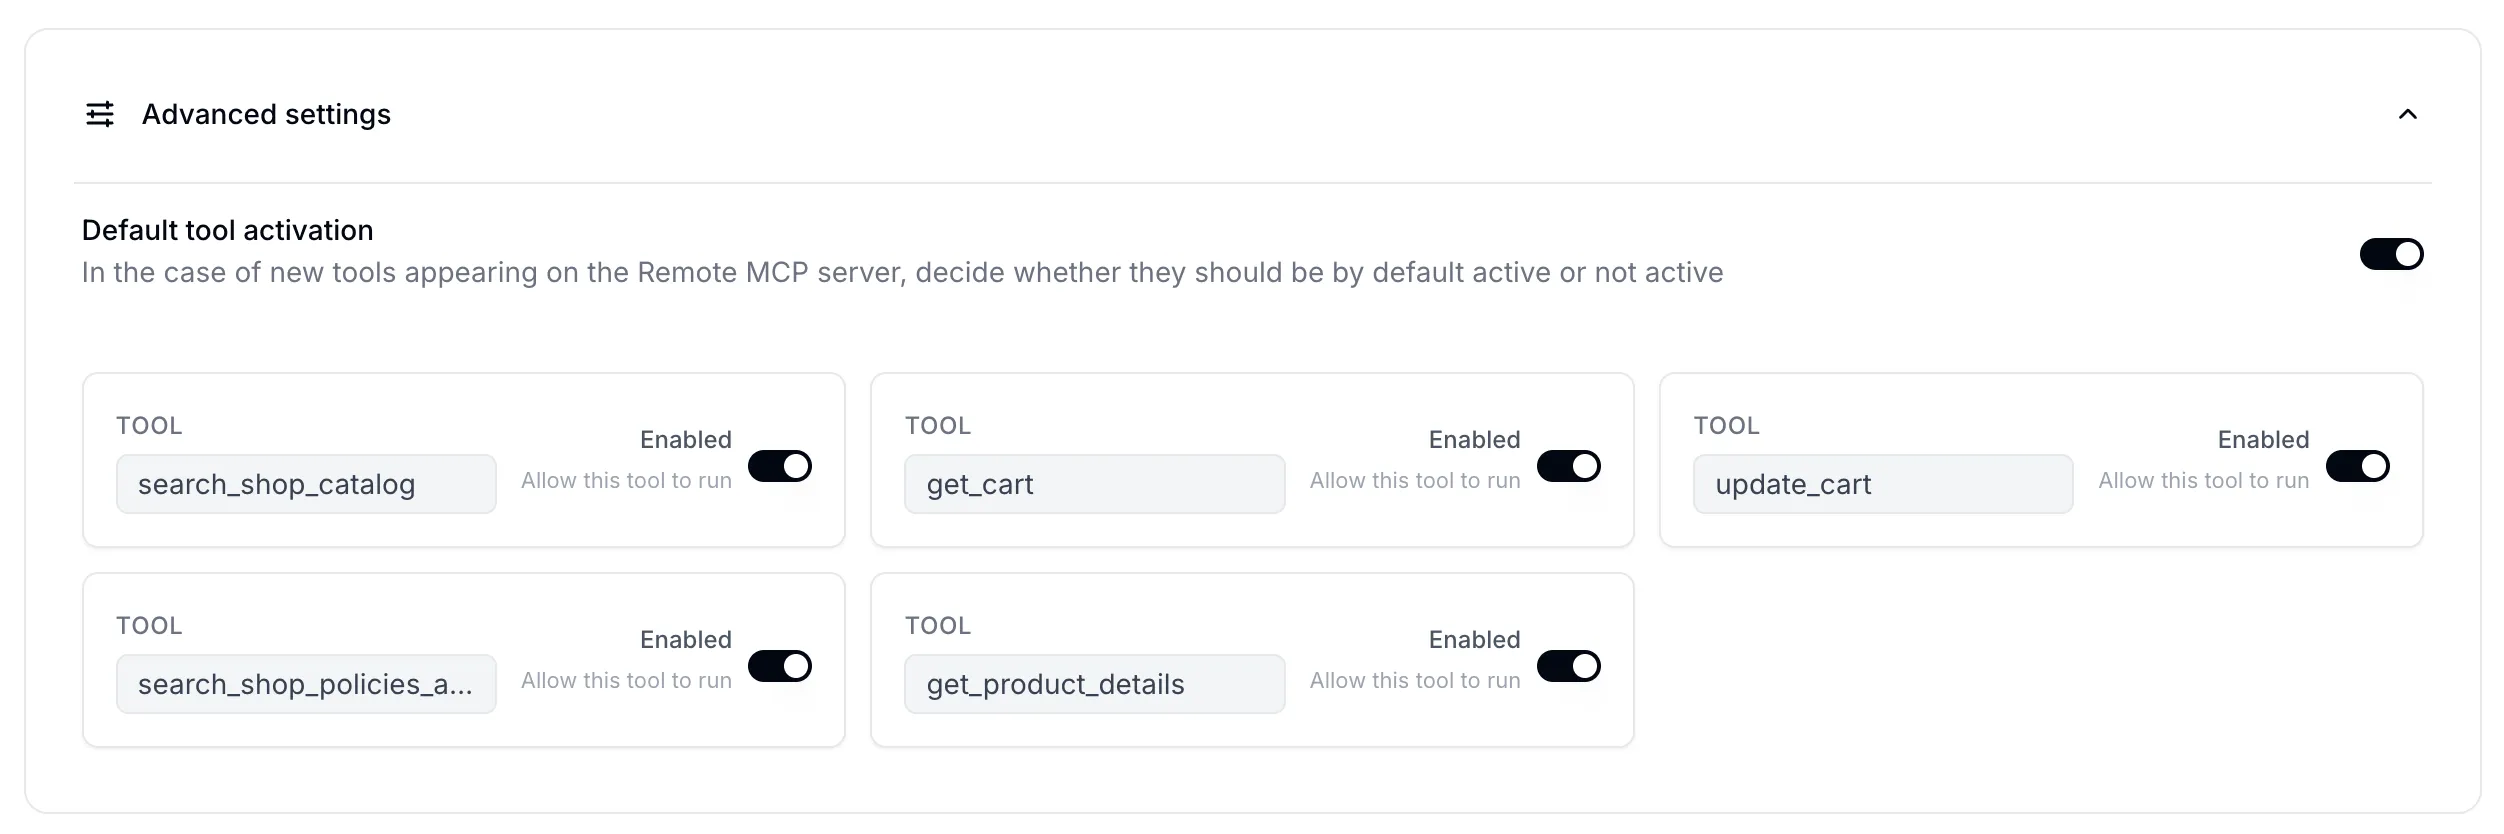
- Zapínej nebo vypínej jednotlivé nástroje a určuj, které z nich může tvůj agent používat
- Nastav příznak “default tool is active”, který řídí, jestli jsou nově objevené nástroje automaticky povolené nebo zakázané
Co se děje pod kapotou:
Když klikneš na Connect, Quickchat AI automaticky detekuje transportní protokol z URL. Pokud URL obsahuje sse, použije se transport SSE, jinak je výchozí streamable_http. Když zadáš auth token, pošle se jako token Bearer v hlavičce Authorization.
Filtrování nástrojů funguje přes tříúrovňový systém. Každý nástroj z MCP serveru se kontroluje proti dvěma sadám: explicitně povolené nástroje se vždy zahrnou, explicitně zakázané nástroje se vždy vyloučí a každý nástroj, který není v žádné sadě, se řídí nastavením “default tool is active”, které sis zvolil. To znamená, že když MCP server přidá nové nástroje, ty řídíš, jestli budou pro tvého agenta automaticky dostupné, nebo budou vyžadovat explicitní aktivaci.
Za běhu se při zahájení konverzace načtou všechna aktivní připojení Remote MCP pro agenta. Nástroje se načtou a vyfiltrují podle konfigurace každého připojení a ověří se jedinečnost názvů nástrojů napříč všemi zdroji (s varováním, pokud se najdou duplicity).
Kompromis: získáš okamžitý přístup ke všemu, co MCP vystavuje, ale máš omezenou kontrolu nad popisy nástrojů, definicemi parametrů nebo tím, jak se agent rozhoduje je používat. Jak jsme zjistili při stavbě AI Agenta na Shopify’s MCP, přechod od dema do produkce vyžaduje pečlivé ladění, které může balíkový přístup MCP ztěžovat.
Viz také: připoj svého agenta ke vzdálenému MCP serveru, Jak spustit svůj Quickchat AI MCP, bezpečnostní aspekty MCP, dokumentace Quickchat AI: MCP channel.
AI Actions (HTTP Request): jeden endpoint, plná kontrola
AI Action v Quickchat AI je jeden HTTP API endpoint, který samostatně nakonfiguruješ pro svého AI Agenta. Zatímco MCP importuje balík nástrojů najednou, každá AI Action ti dává plnou kontrolu nad jednou konkrétní schopností. Kompletní propracovaný příklad, čtyři akce, které vytvářejí a obohacují kontakty, zapisují obchody a otevírají tickety v CRM, najdeš v tutoriálu HubSpot AI Actions.
Konfigurace AI Action:
- Name (max 64 znaků): stane se názvem nástroje, který vidí LLM. Normalizuje se na platný identifikátor (např. “Check Order Status” se změní na
Check_Order_Status) - Description (max 1 000 znaků): toto je nejdůležitější pole. Popis říká LLM, kdy má tento nástroj použít. Dobré popisy určují, za jakých konverzačních okolností ho volat, jaké informace nejdřív získat od uživatele a jak mají být výsledky předány zpět
- HTTP method: GET, POST, PATCH, DELETE nebo PUT
- URL (max 10 000 znaků): může obsahovat placeholdery
{{parameter_name}}pro dynamické hodnoty - Headers: páry klíč-hodnota pro autentizaci a typ obsahu
- Body items / Body JSON: tělo požadavku s injektováním parametrů
- Query parameters: hodnoty query stringu v URL
- Parameters (max 10): každý má název, popis (max 500 znaků), typ (
str,int,float,boolnebocustom), příznak povinnosti a volitelnou výchozí hodnotu
Placeholdery {{parameter_name}} jsou klíčový mechanismus. Když LLM volá nástroj, poskytne hodnoty pro každý parametr podle kontextu konverzace. Quickchat AI pak tyto hodnoty vloží do šablon URL, hlaviček, těla a query stringu před odesláním HTTP požadavku. Existují také čtyři vestavěné proměnné, které lze tímto způsobem vložit: scenario_id, conversation_id, conversation_channel a conversation_url.
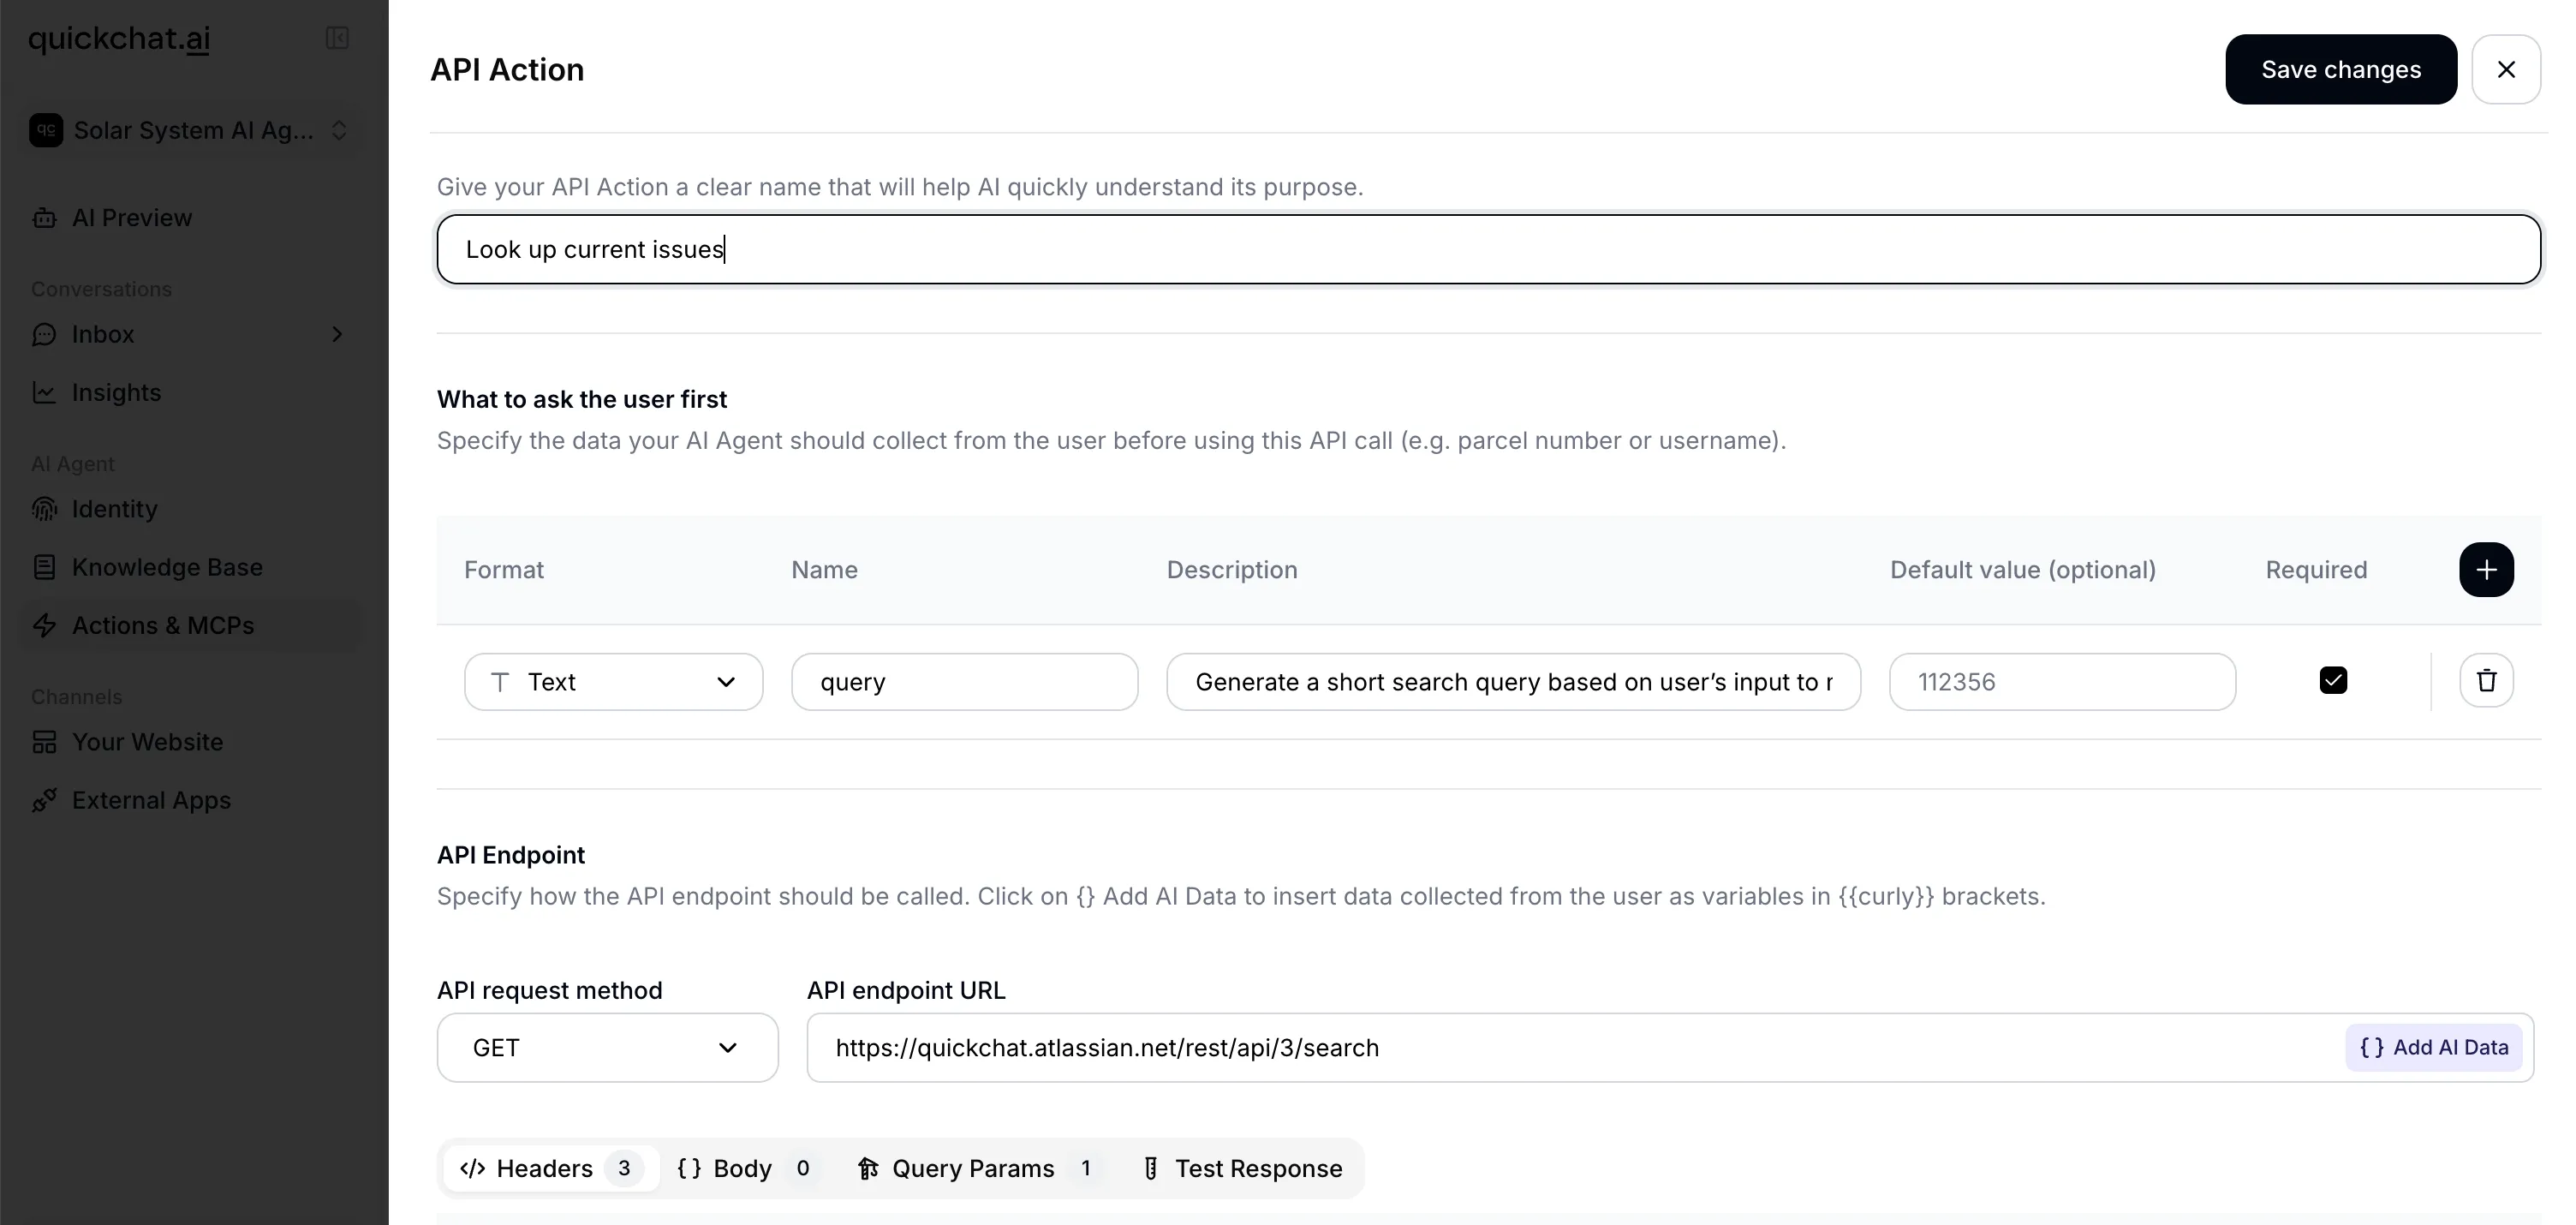 AI Action nakonfigurovaná pro kontrolu stavu objednávky, zobrazující šablonu URL s placeholderem parametru, hlavičky a definice parametrů.
Pod kapotou: Quickchat AI pro každou AI Action dynamicky sestaví typované schéma z tvých definic parametrů. Pět podporovaných typů (str, int, float, bool, custom) se mapuje na jejich nativní ekvivalenty a toto schéma se používá k validaci vstupů z LLM před odesláním HTTP požadavku.
Příklad AI Action pro kontrolu stavu objednávky:
{
  "name": "check_order_status",
  "description": "Když se uživatel ptá na stav své objednávky a poskytl číslo objednávky, zavolej tento endpoint a načti aktuální stav. Sděl uživateli stav, odhadované datum doručení a sledovací číslo (pokud je dostupné).",
  "method": "GET",
  "url": "https://api.example.com/orders/{{order_id}}",
  "headers": [
    { "name": "Authorization", "value": "Bearer YOUR_API_KEY" },
    { "name": "Content-Type", "value": "application/json" }
  ],
  "parameters": [
    {
      "name": "order_id",
      "description": "ID objednávky poskytnuté uživatelem (např. ORD-12345)",
      "type": "str",
      "is_required": true
    }
  ]
}
Testování: Dashboard má tlačítko “Test”, které ti umožní zadat ukázkové hodnoty parametrů a před nasazením zobrazit skutečný HTTP požadavek (včetně vygenerovaného příkazu curl) a odpověď.
Tipy pro psaní účinných popisů AI Action:
- Buď konkrétní v tom, kdy ji má agent volat: „Když se uživatel ptá na stav své objednávky a poskytne číslo objednávky, zavolej tento endpoint“
- Uveď, jaké informace je potřeba nejdřív získat: „Před voláním se ujisti, že máš e-mailovou adresu uživatele a ID objednávky“
- Popiš, jak zpracovat odpověď: „Pokud je stav ‘shipped’, řekni uživateli sledovací číslo z odpovědi“
- U vícekrokových workflow popiš sekvenci v hlavním systémovém promptu agenta, nikoli v popisech jednotlivých akcí, a pro přenesení hodnoty mezi akcemi a podmínění zápisu touto hodnotou použij Save to memory plus podmínku spuštění
Propracovaný příklad: podrobnou AI Action, která zapisuje leady, nezodpovězené otázky a žádosti o demo přímo do tabulky, najdeš v článku jak připojit AI agenta ke Google Sheets.
Generate from Text: nech AI, ať na to přijde
Třetí možnost je pro uživatele, kteří vědí, co chtějí, aby jejich agent dělal, ale nevědí, který API endpoint (nebo dokonce kterou službu) použít.
Jak to funguje:
- Napíšeš popis v přirozeném jazyce, co chceš, například „Chci, aby můj AI Agent uměl nastartovat uživatelovu Teslu, když o to požádá“
- Quickchat AI to odešle do LLM se zapnutým nástrojem
web_search - Model prozkoumá web, najde správné API, přečte oficiální dokumentaci a vygeneruje kompletní specifikaci AI Action včetně URL, metody, hlaviček, parametrů a požadavků na autentizaci
- Výsledek se vrátí s plnou konfigurací akce, citacemi použité dokumentace a vysvětlující zprávou uvádějící předpoklady a mezery
- Zkontroluješ ho, doplníš své přihlašovací údaje a aktivuješ
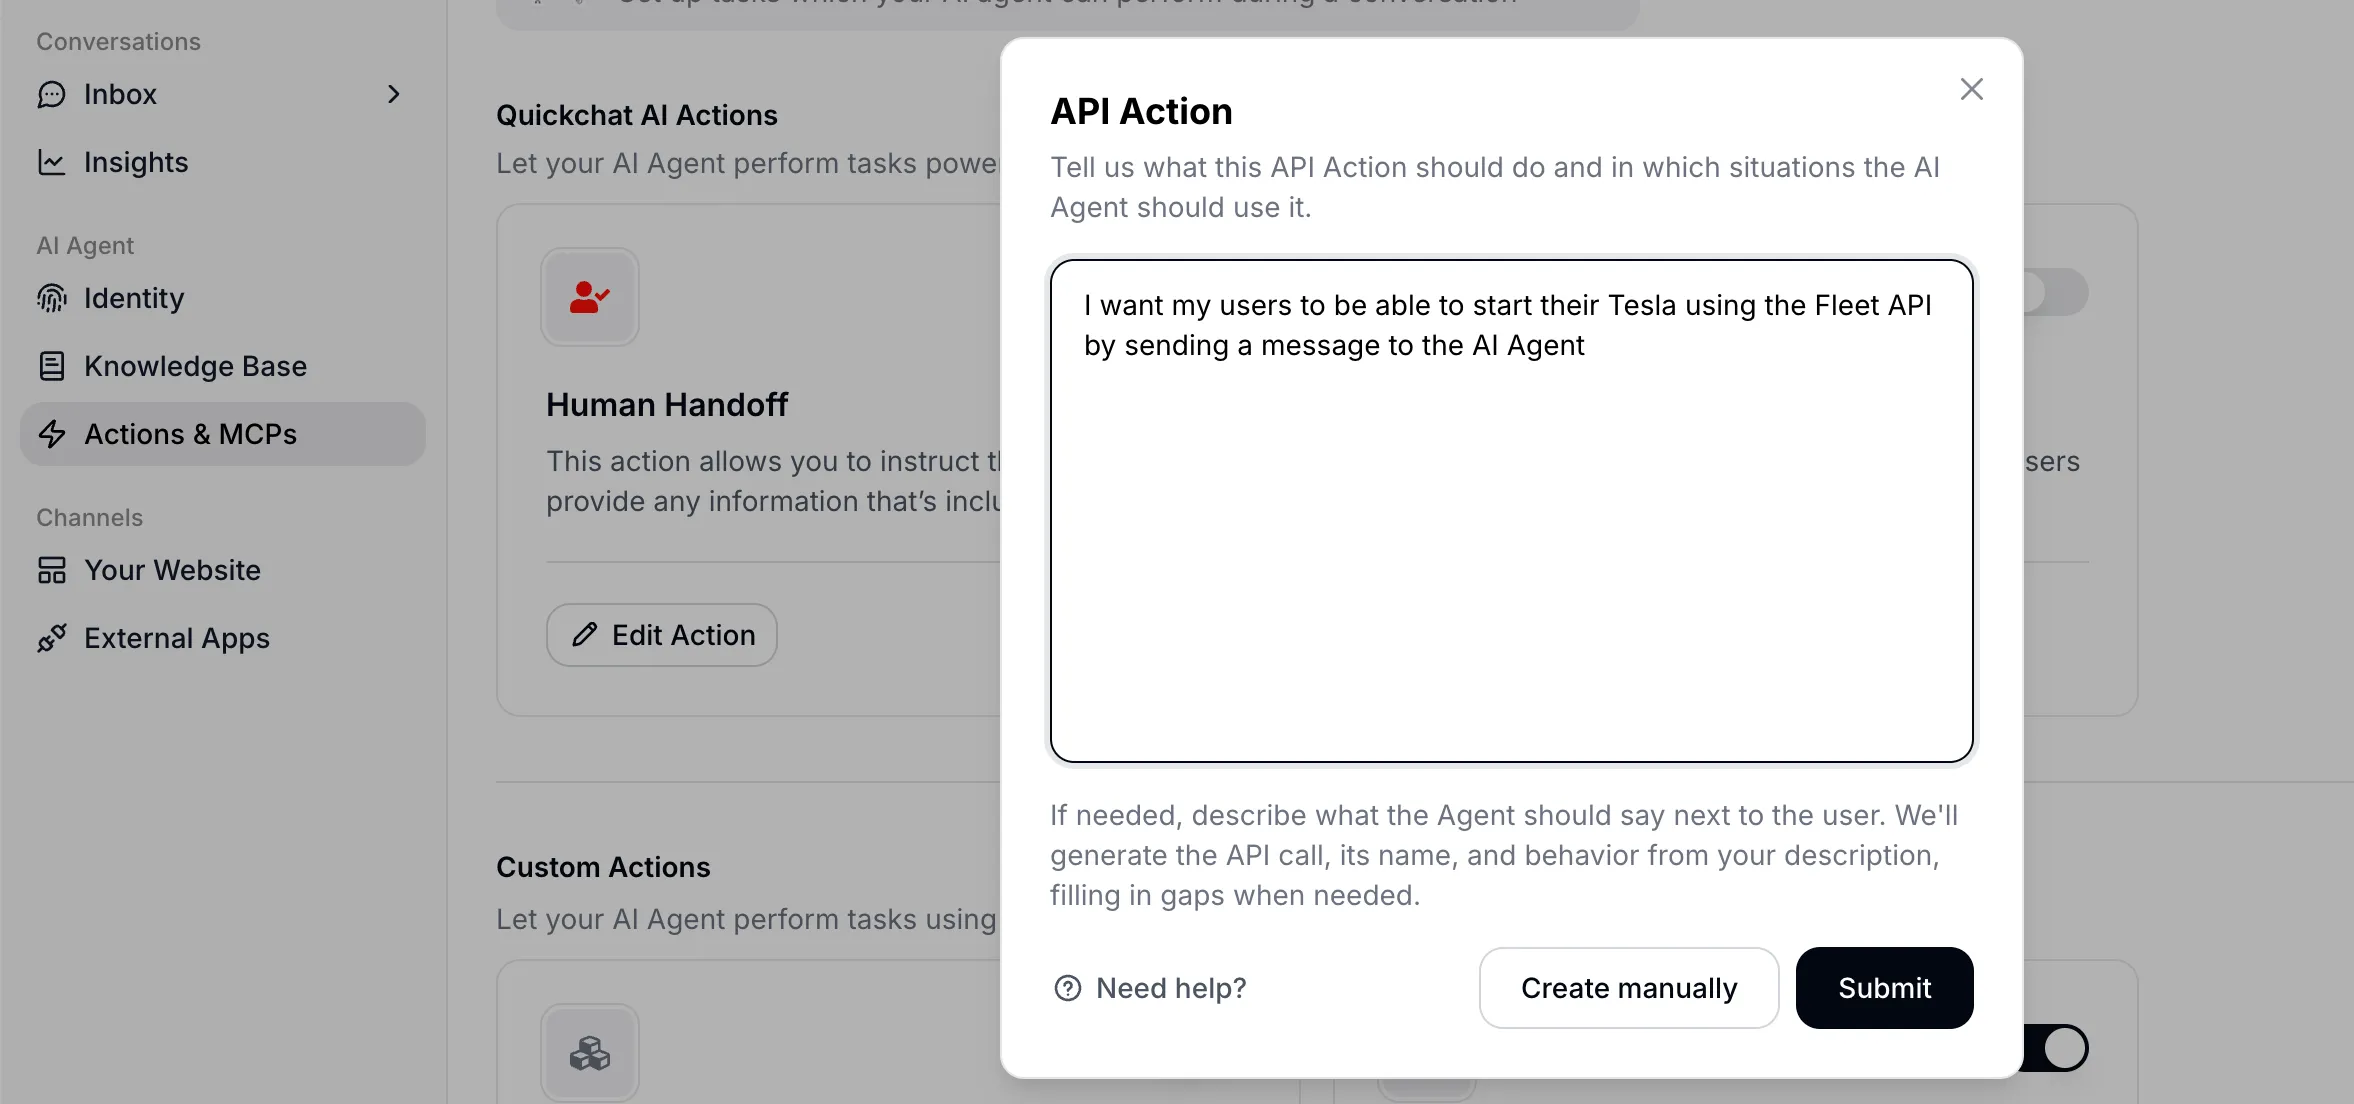 Zadání popisu požadované schopnosti v přirozeném jazyce.
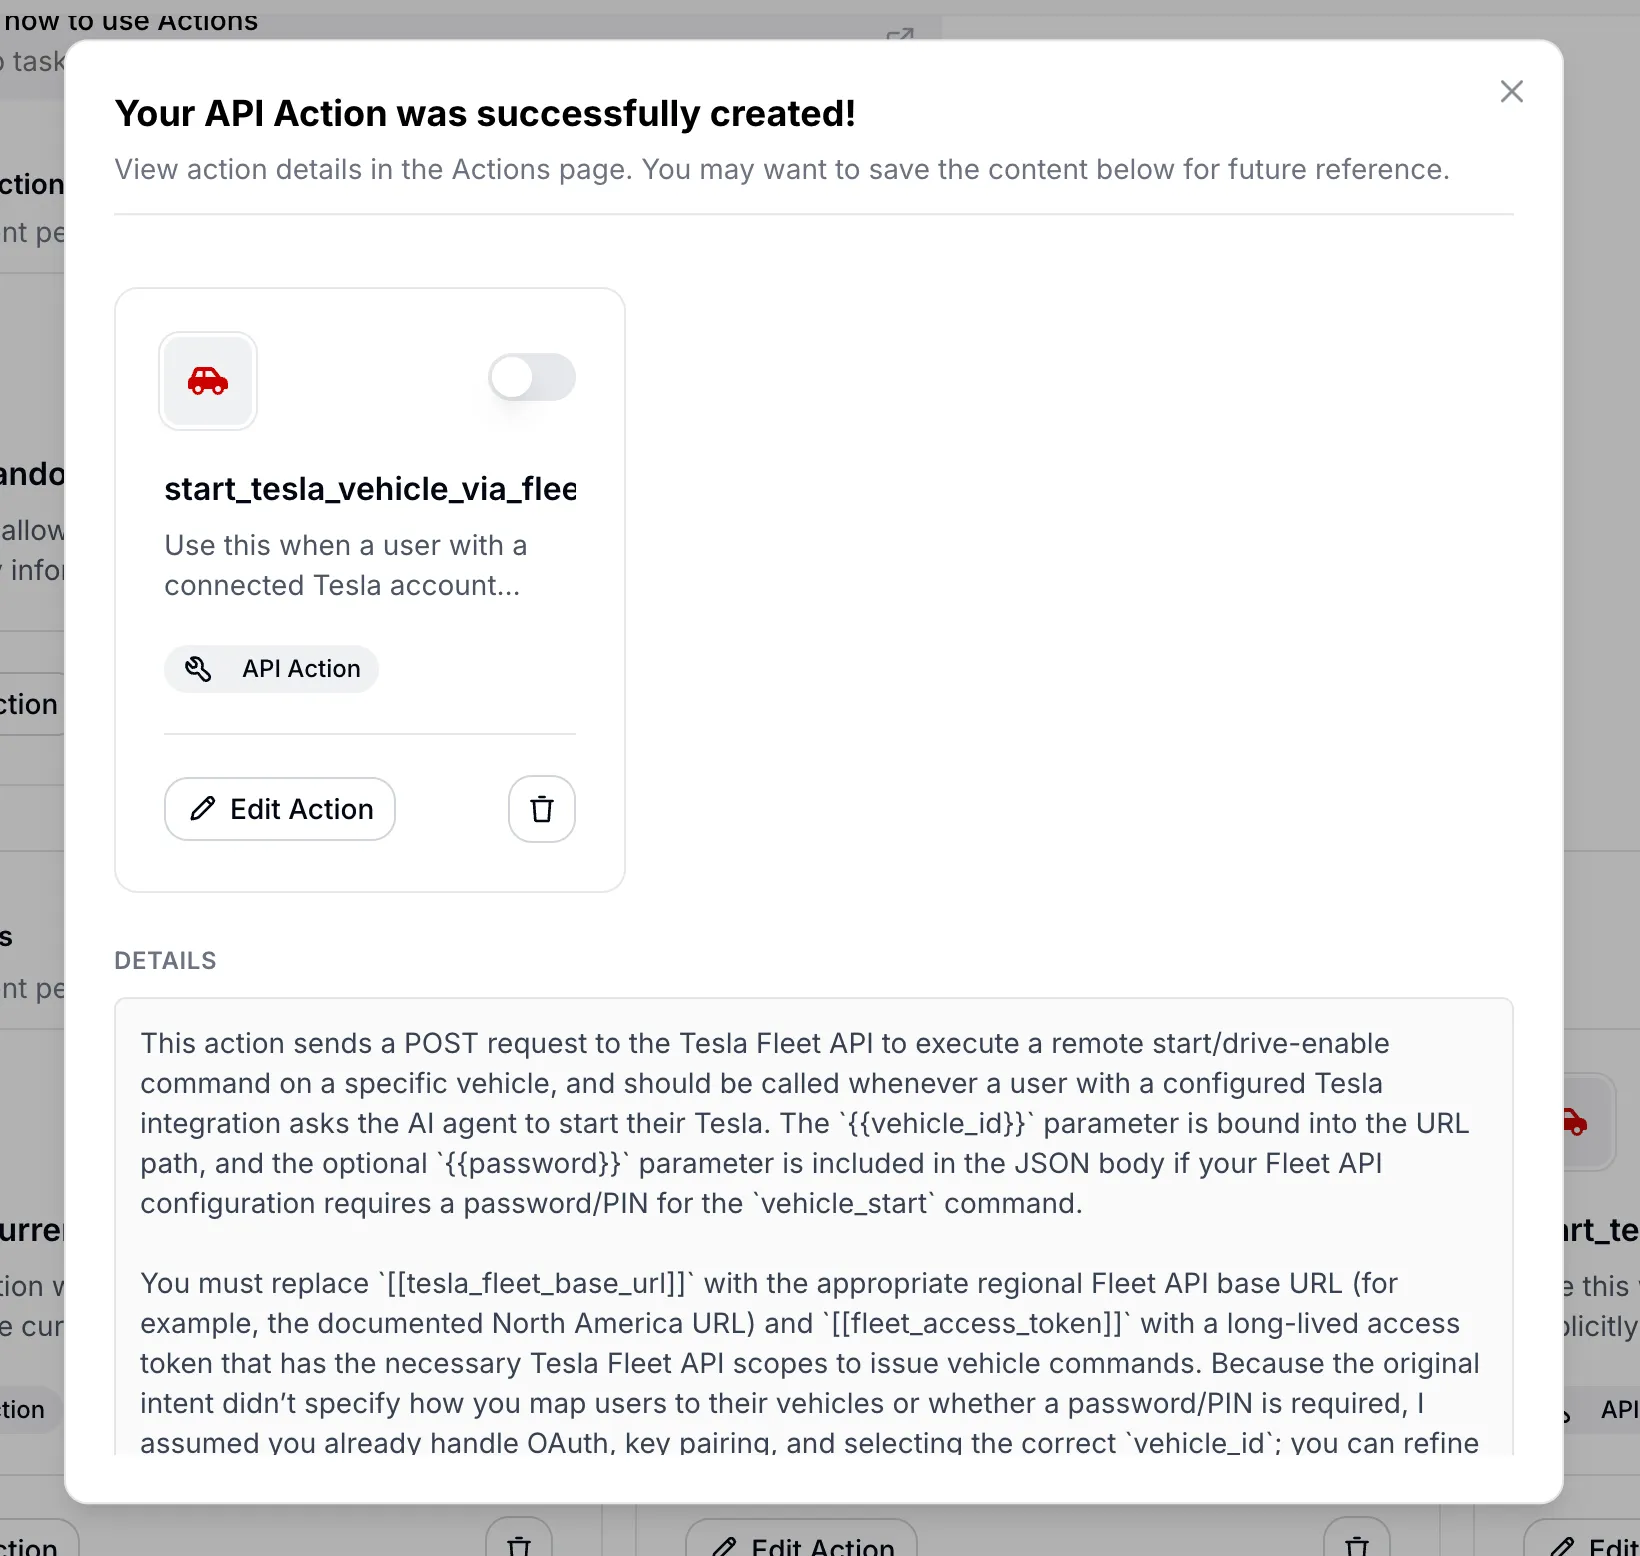 Vygenerovaná konfigurace AI Action s citacemi použité API dokumentace.
Automatizované generování AI Action je strukturované kolem tří priorit:
- Priorita 1: Pochopit záměr. Identifikovat přesnou schopnost, kterou vývojář chce, a konkrétní API endpoint, který ji poskytuje
- Priorita 2: Opřít se o dokumentaci. Použít webové vyhledávání k nalezení oficiální dokumentace dodavatele, ne odhadů
- Priorita 3: Navrhnout sémantiku zaměřenou na konverzaci. Vygenerovaný název a popis mají být o tom, kdy v konverzaci se tento nástroj použije, ne jen o tom, co API technicky dělá
Prompt používá dvě konvence placeholderů. {{param}} označuje runtime parametry, které LLM vyplňuje z kontextu konverzace. [[secret_name]] (dvojité hranaté závorky) označuje vývojářské konstanty, jako jsou API klíče a ID účtů, které musí být před aktivací nakonfigurovány ručně. Každý název parametru se musí objevit jako placeholder {{that_exact_name}} někde v definici požadavku a nejsou povolené žádné osiřelé placeholdery.
Systém používá fail-closed policy. Pokud model nedokáže potvrdit kritickou informaci z dokumentace (HTTP metodu, URL, autentizační schéma nebo požadovanou strukturu payloadu), žádná akce se nevytvoří. Místo odhadování systém vrátí stručné vysvětlení, co chybí.
Tady se filozofická pointa o tom, že AI agenti objevují API, propojuje s konkrétní produktovou funkcí. Funkce Generate from Text je doslova AI agent (LLM s webovým vyhledáváním), který vytváří definici nástroje pro jiného AI agenta (agenta Quickchat AI, který ji bude používat v konverzacích).
Propracovaný příklad: kompletní tutoriál, který ze dvou napsaných vět vytvoří dvě živé otestované akce (dotaz na počasí bez klíče a NASA akci s klíčem, včetně odmítnutí podle fail-closed), najdeš v článku jak připojit svého AI agenta k libovolnému API v běžné angličtině.
Za běhu se všechny tyto typy nástrojů sestaví dohromady. Quickchat AI shromáždí nástroje AI Action pro HTTP request, nástroje Shopify MCP, nástroje znalostní báze, nástroje remote MCP, nástroje Discord a další vlastní nástroje do kolekce, která se předloží LLM. Model mezi nimi nevidí žádný rozdíl. Nástroj Remote MCP a ručně nakonfigurovaná AI Action vypadají stejně, jakmile jsou v seznamu nástrojů.
Otevřená API jako nové SEO
Pokud budou AI agenti objevovat a používat API autonomně, dobře zdokumentované a snadno použitelné API se stává distribučním aktivem. Gartner předpovídá, že do roku 2026 bude více než 30% nárůstu poptávky po API pocházet od AI agentů.
Firmy, které mají otevřená API s minimálními překážkami pro získání přístupových údajů, mohou zjistit, že se jejich API stávají nejlepším akvizičním kanálem. Místo zobrazení ve vyhledávání Google jsou „zobrazeními“ AI agenti, kteří si vybírají tvoji službu místo služby konkurenta.
Stejná logika platí o úroveň výš. AI agent, který odpovídá z tvé dokumentace, může být sám vystaven jako MCP server, který ChatGPT, Claude a Cursor volají jako nástroj, díky čemuž je pro agentní web objevitelná tvoje znalost, nejen tvoje API.
Kvalita tvé API dokumentace rozhoduje o tom, jestli se s tebou AI agent dokáže úspěšně integrovat na první pokus. Popisy parametrů, chybové zprávy a ukázkové odpovědi plní stejnou funkci jako meta popisy a strukturovaná data v tradičním SEO. Matoucí chybová odpověď nebo nezdokumentované povinné pole znamená, že agent selže, a na druhé straně není žádný člověk, který by to odladil.
Firmy, jejichž API nejsou zdokumentovaná nebo jsou schovaná za náročnými požadavky na přístupové údaje, mohou zjistit, že jsou pro agentní web neviditelné, stejně jako se firmy bez webů staly neviditelnými pro Google v 2000s.
Používání počítače vs. API
Do výuky AI modelů pro „používání počítače“ se investuje významně (klikání na tlačítka, vyplňování formulářů, navigace v UI). Anthropic, OpenAI (Operator) a open-source projekty jako Browser Use nabízejí různé verze tohoto přístupu.
Používání prohlížeče je ale náhradní řešení pro chybějící API. Volání POST /orders trvá milisekundy a vrací strukturovaná data. Prohlížečový agent, který prochází checkout flow, potřebuje minuty a může se rozbít, když se tlačítko posune o tři pixely doleva. API jsou rychlejší, determinističtější a levnější na spuštění.
Protiargument je skutečný: API neexistují pro všechno. Legacy systémy, enterprise software bez API povrchu, fyzická zařízení ovládaná přes GUI. Používání počítače v těchto případech vyplňuje skutečnou mezeru.
Lepší dlouhodobá odpověď na „pro tohle nemáme API“ je pravděpodobně API vybudovat, ne učit AI používat GUI. Jak se stále více softwaru píše AI agenty pro AI agenty, náklady na budování a údržbu API klesají. Ekonomická kalkulace, která dřív dělala scraping UI levnějším než stavbu API, se mění.
Je tu také bezpečnostní úhel. „Smrtící trojice“ Simona Willisona popisuje nebezpečnou kombinaci přístupu k soukromým datům + vystavení nedůvěryhodnému obsahu + externí komunikace. Platí to pro oba přístupy, ale nástroje založené na API se snáz auditují a omezují. Můžeš logovat každé API volání, validovat každý parametr a rate-limitovat každý endpoint. Udělat totéž pro prohlížečového agenta, který může kliknout na cokoli, je mnohem těžší.
Nástroje pro fyzický svět
Všechno, o čem jsme zatím mluvili, se týká softwaru. Stejný vzor se objevuje i ve fyzickém světě.
RT-2 a Gemini Robotics od Google DeepMind používají stejnou architekturu, jen nástroje směrují na aktuátory místo API. Framework SPCA (Sense-Plan-Code-Act) to formalizuje pro robotiku: naskenuj prostředí, naplánuj postup, vygeneruj spustitelný kód, spusť ho, pozoruj výsledky.
Neexistuje žádné API pro „posuň rostlinu na mém stole doprava“. Robot s kamerou by ale mohl za běhu definovat move_object(object_id="plant_01", direction="right", distance_cm=15) jako nástroj a potom ho zavolat. Definice nástroje slouží jako rozhraní mezi vrstvou uvažování a vrstvou fyzického provedení, tedy ve stejné roli, jakou v softwaru hrají API endpointy.
Architektura LLM + nástroje + smyčka je obecně použitelná. Dnes se nejsnáze implementuje v softwaru, ale robotika ji dohání.
API psaná AI, pro AI
Za zhruba dva roky (2024 až 2026) jsme se posunuli od toho, že většinu kódu psali lidé, k tomu, že většinu kódu píše AI. Je to vhodná chvíle znovu promyslet, co je API endpoint. Endpoint je čím dál častěji deklarace schopnosti navržená tak, aby ji objevovaly a spouštěly stroje, ne technické rozhraní pro lidské vývojáře, kteří si přečtou dokumentaci a potom ji ručně integrují.
MCP jsou užitečná standardizační vrstva, ale jsou také kurační vrstva, která zavádí zkreslení. Tvůrce MCP rozhoduje, které nástroje vystavit a jak je zarámovat. Pro produkční AI agenty toto zarámování nemusí odpovídat tomu, co skutečně potřebuješ. (Podrobně jsme o tom psali při analýze výzev se Shopify’s MCP.)
Spektrum, kterým jsme prošli v Quickchat AI Agents, odráží širší pointu. Správná úroveň kontroly závisí na tvém případu použití. Remote MCP funguje dobře pro rychlé prototypování. Jednotlivé AI Actions ti dávají jemnozrnnou kontrolu pro produkční agenty pro zákazníky. Generate from Text nechá AI prozkoumat API a sestavit definici nástroje za tebe, když stále mapuješ možnosti.
A na každé úrovni je základní vzor stejný. LLM, sada nástrojů, smyčka. Ať už jsou těmito nástroji bash příkazy, API endpointy, MCP servery nebo robotické aktuátory, vždycky jsou to nástroje až dolů.